Deep Research Agent 会不断拆问题、检索、阅读和汇总。随着轨迹增长,新证据的边际价值通常下降,但每个低价值分支仍会产生搜索、解析、模型调用和上下文搬运成本。等到最终写报告前再压缩,很多钱已经花完了。
这项研究把裁剪问题从“用什么算法删文本”改写为“应该在哪个阶段阻止低价值信息继续流动”。它优化的是 信息在管线中的生命周期 。
#三个阶段,节省的成本完全不同
检索前裁剪判断候选子问题是否值得搜索;检索后裁剪判断刚取回的结果是否增加新信息;生成前裁剪只整理最终报告需要的上下文。三者看似都在减少 Token,影响范围却不同。
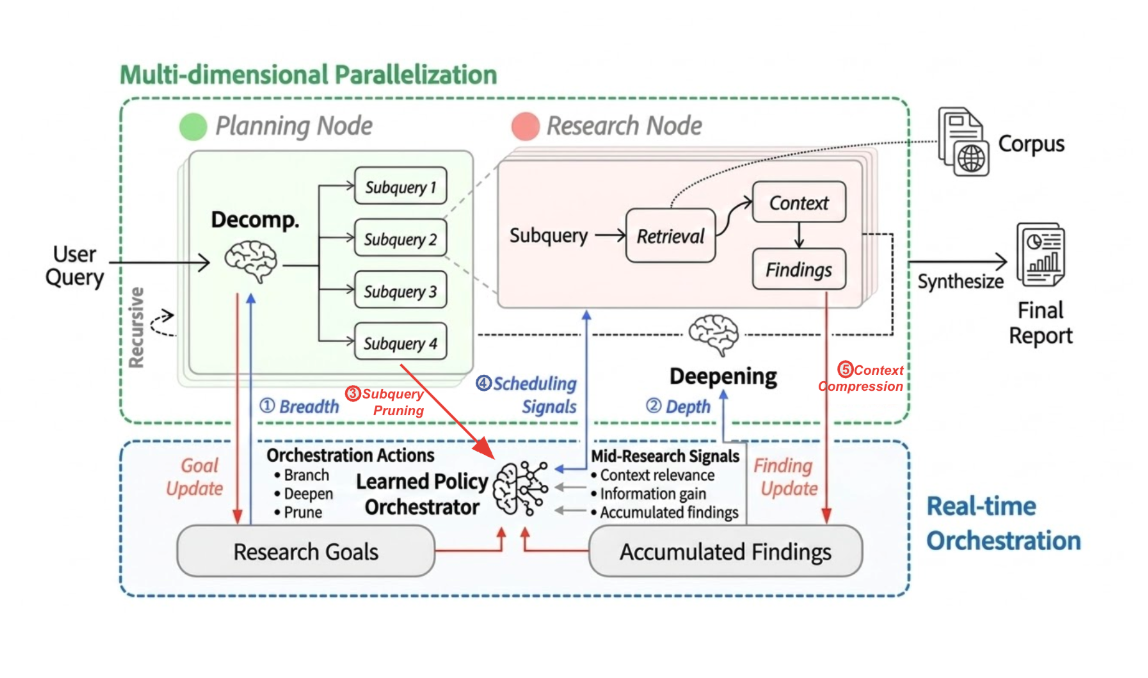 Deep Research 流程中的检索前、检索后与生成前裁剪位置
未裁剪基线平均探索 29 个节点、消耗 37.54 万 Token,并需要 3422.6 秒生成一份报告。它自带的生成前整理把上下文条目减少约 33.3%,Token 减少约 34.1%,但此前检索和结果处理成本已经发生。
因此早期门控能够同时减少分支数、工具调用、处理 Token 和延迟;生成前裁剪最多只优化最后一次综合。
#放在哪里,比用哪个评分器更重要
研究比较相关性、新颖性、MMR、DPP、质心漂移、子模覆盖、LLM 判断和一个学习型控制器。轻量启发式策略最高减少 73% Token,同时在固定裁判设置下大致保持报告质量。
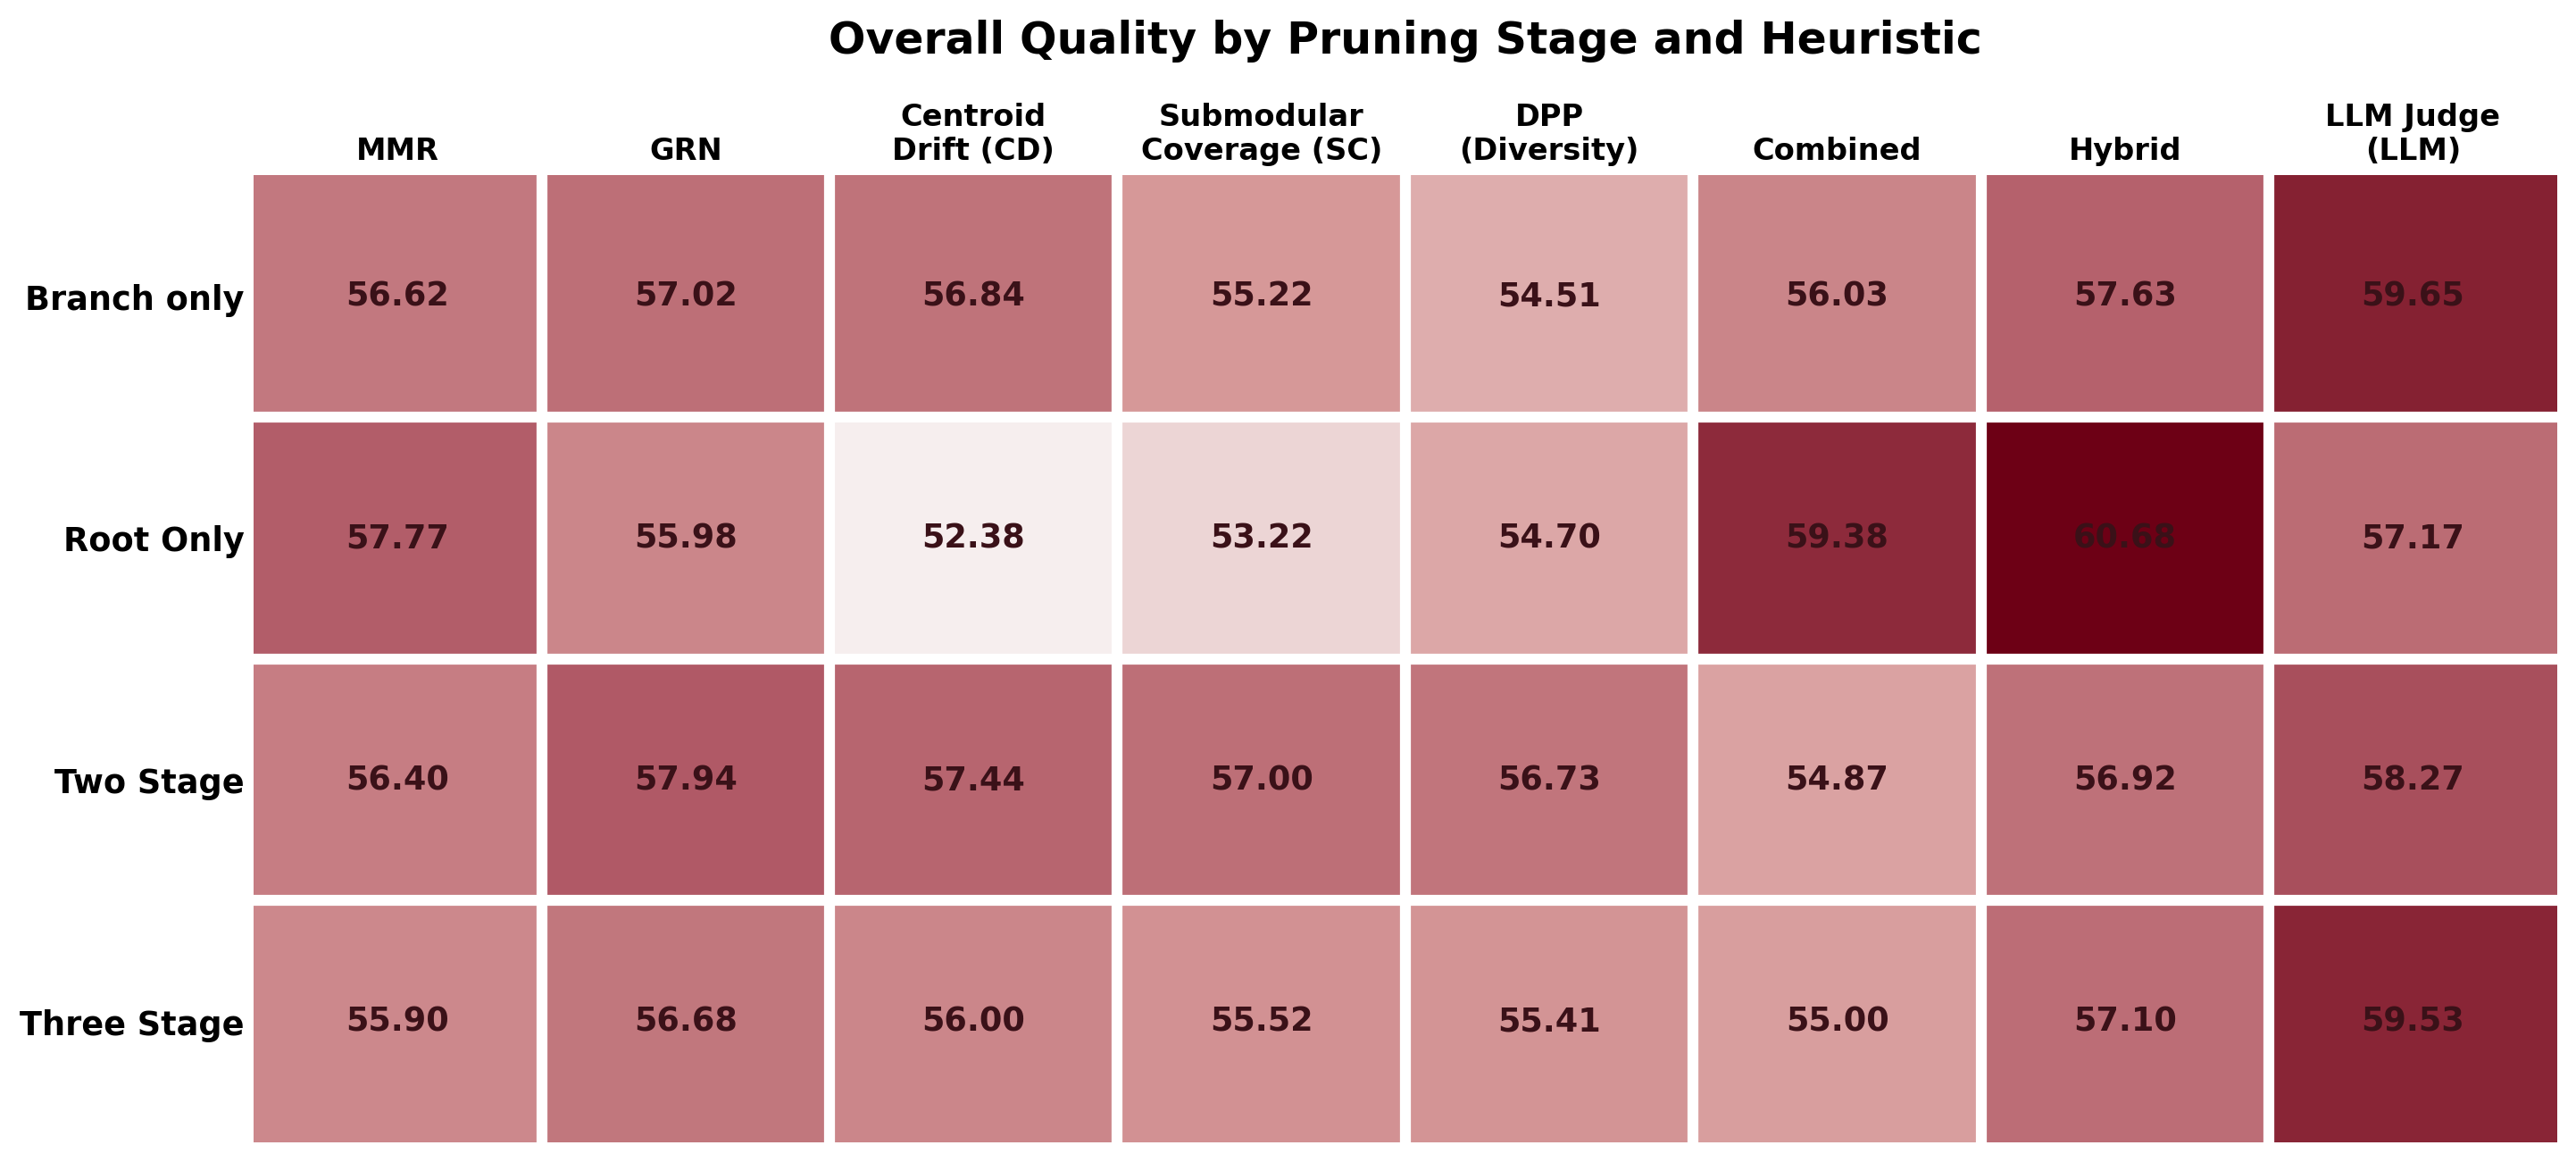 不同阶段与启发式组合的质量—效率表现
没有一种方法在质量、效率、相关性和来源忠实度上全面占优。生成前 Hybrid 的单阶段质量最高,CD + SC 给出较好的质量—效率折中,三阶段组合适合追求最大压缩。学习型控制器只在部分设置中有竞争力,并没有稳定超过简单启发式。
#报告好看,不等于证据保留得好
裁剪后的报告可能被模型裁判认为表达更清晰,却丢失关键引用。研究发现,最高的最终质量分与最高的 citation recall 并不来自同一策略。压缩策略因此至少要同时测四件事:答案质量、执行成本、相关证据覆盖和来源忠实度。
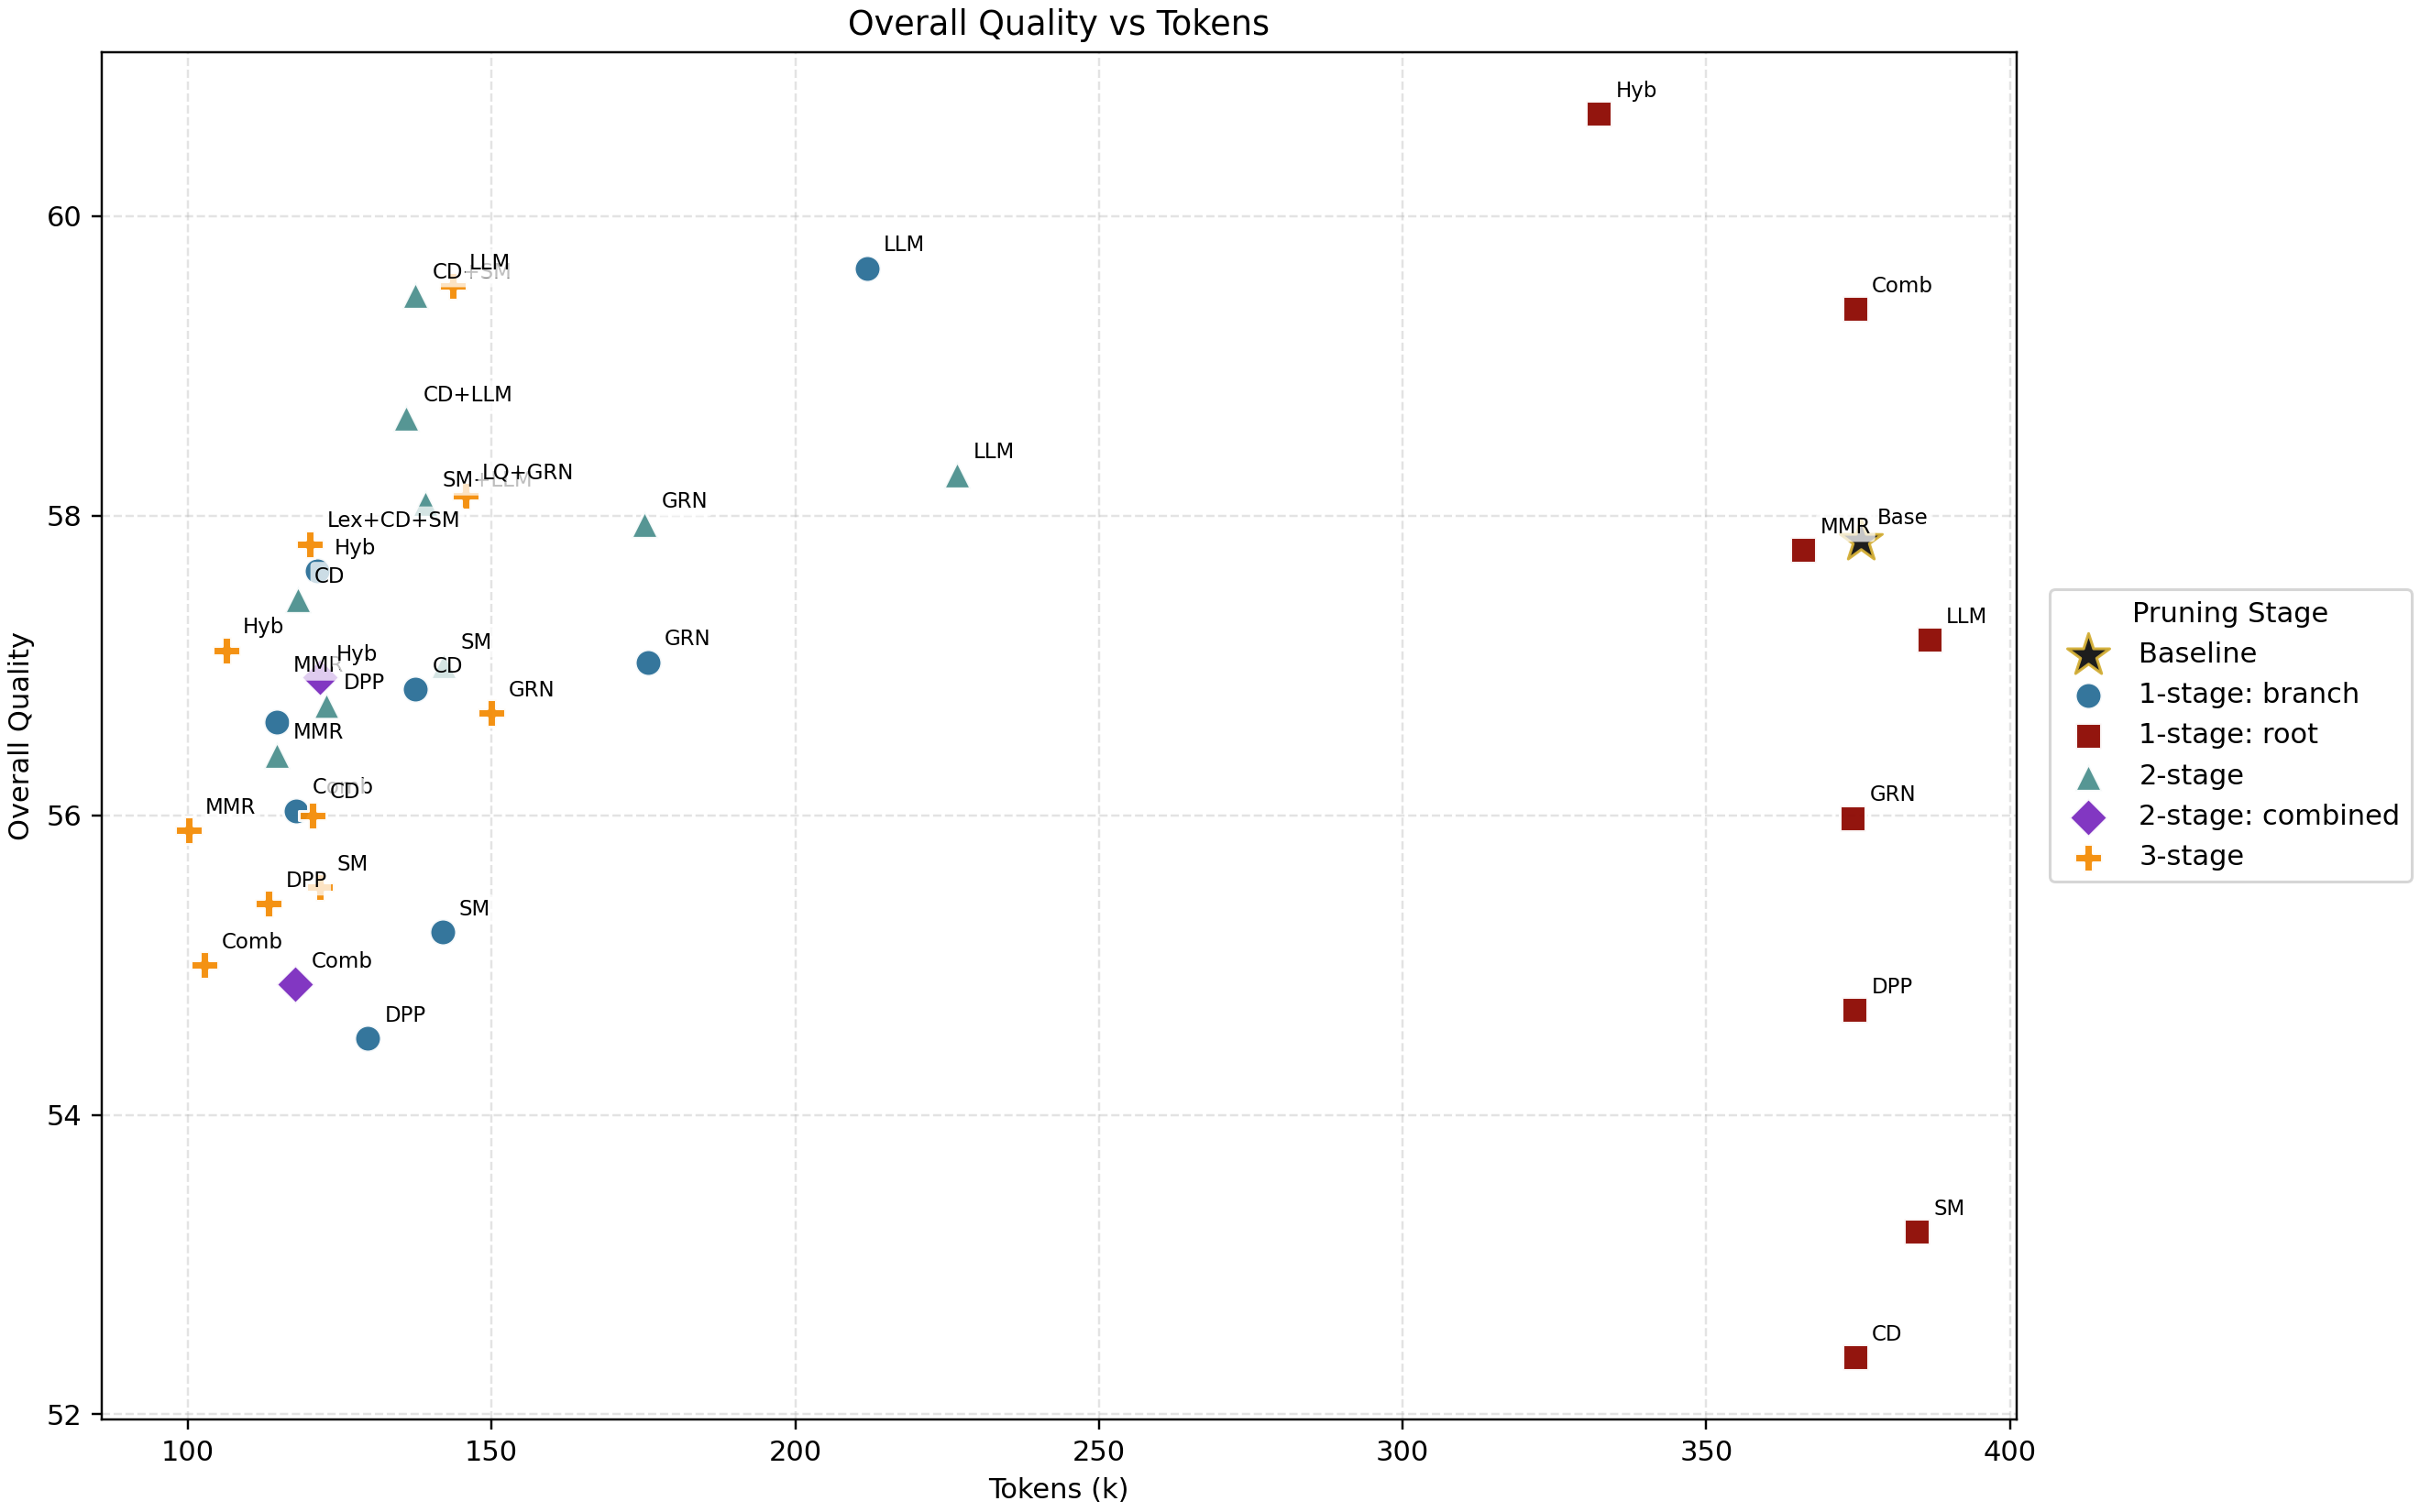 Token 减少与人工质量评估之间并非单调关系
生产系统还应允许按任务调阈值。事实核查、法律和科研任务需要更高证据召回;趋势扫描或低风险草稿可以更激进地提前终止分支。固定“保留前 10 条”很难覆盖这些差异。
这项工作的工程结论很明确:上下文不是最终 Prompt 里的一堆文本,而是一条有生成、流转和淘汰节点的数据管线。越早识别边际价值低的分支,节省的就越接近完整成本。