腾讯微信视觉团队开源了 WeMM-Embedding,一组统一多模态 Embedding 模型。它不只处理文本和图片,还把视频、视觉文档,以及图文交错输入映射到同一个向量空间,用于跨模态理解与检索。
项目一次发布 2B、4B 和 9B 三种规模,并开放模型权重、推理示例和评测流程。它试图解决的不是某个单独的图片检索任务,而是让搜索、匹配和排序系统用一套表示同时面对多种内容形态。
#一套向量表示覆盖五类输入
WeMM-Embedding 支持文本、图像、视频、视觉文档和交错多模态内容。交错输入意味着一条内容可以同时包含文字和图片,模型不必先把它们拆成互不关联的两路结果。
模型在专用的 Embedding Token 位置读取最后一层隐藏状态,再经过归一化得到向量。对于应用层来说,关键结果是不同模态可以进入同一个检索空间:文本查询可以寻找图像或视频,视觉内容也可以与文档和复合内容比较相似度。
目前尚不支持音频。这一点在综合基准中会直接形成零分项,因此不能把 WeMM 理解为覆盖所有感知模态的 Omni-Embedding;它的重点仍是视觉与语言,以及二者组成的复杂内容。
#三种模型规模,向量维度可以裁剪
2B、4B 和 9B 模型分别提供多档 Matryoshka Embedding 维度。2B 模型从 64 维一路支持到 2048 维,4B 最高 2560 维,9B 最高 4096 维。
Matryoshka 的价值在于,部署者不必为每种向量尺寸重新训练模型。可以从完整向量中截取前若干维并重新归一化,在检索质量、存储成本和计算速度之间选择适合自己的平衡点。
仓库报告显示,在 MMEB-v2 上,2B 模型使用 256 维向量时,图像与视频任务仍能保留完整维度 98.7% 的表现。这意味着小模型不只参数量较低,还可以显著压缩写入向量数据库的数据体积。
#MMEB-v2:2B 模型已经超过多款更大模型
MMEB-v2 覆盖 78 个数据集,包含图像、视频和视觉文档任务。项目报告中,WeMM-Embedding 的 2B、4B、9B 模型平均分分别为 77.9、79.2 和 80.6,随着规模增加稳定上升。
作为对照,Qwen3-VL-Embedding 的 2B 和 8B 版本分别得到 73.2 和 77.8;闭源提交 DME-Small 2B 为 74.8,DME-Medium 9B 为 78.4。WeMM 2B 在平均分上已经超过这些更大的对照模型,9B 则取得表中最高平均分。
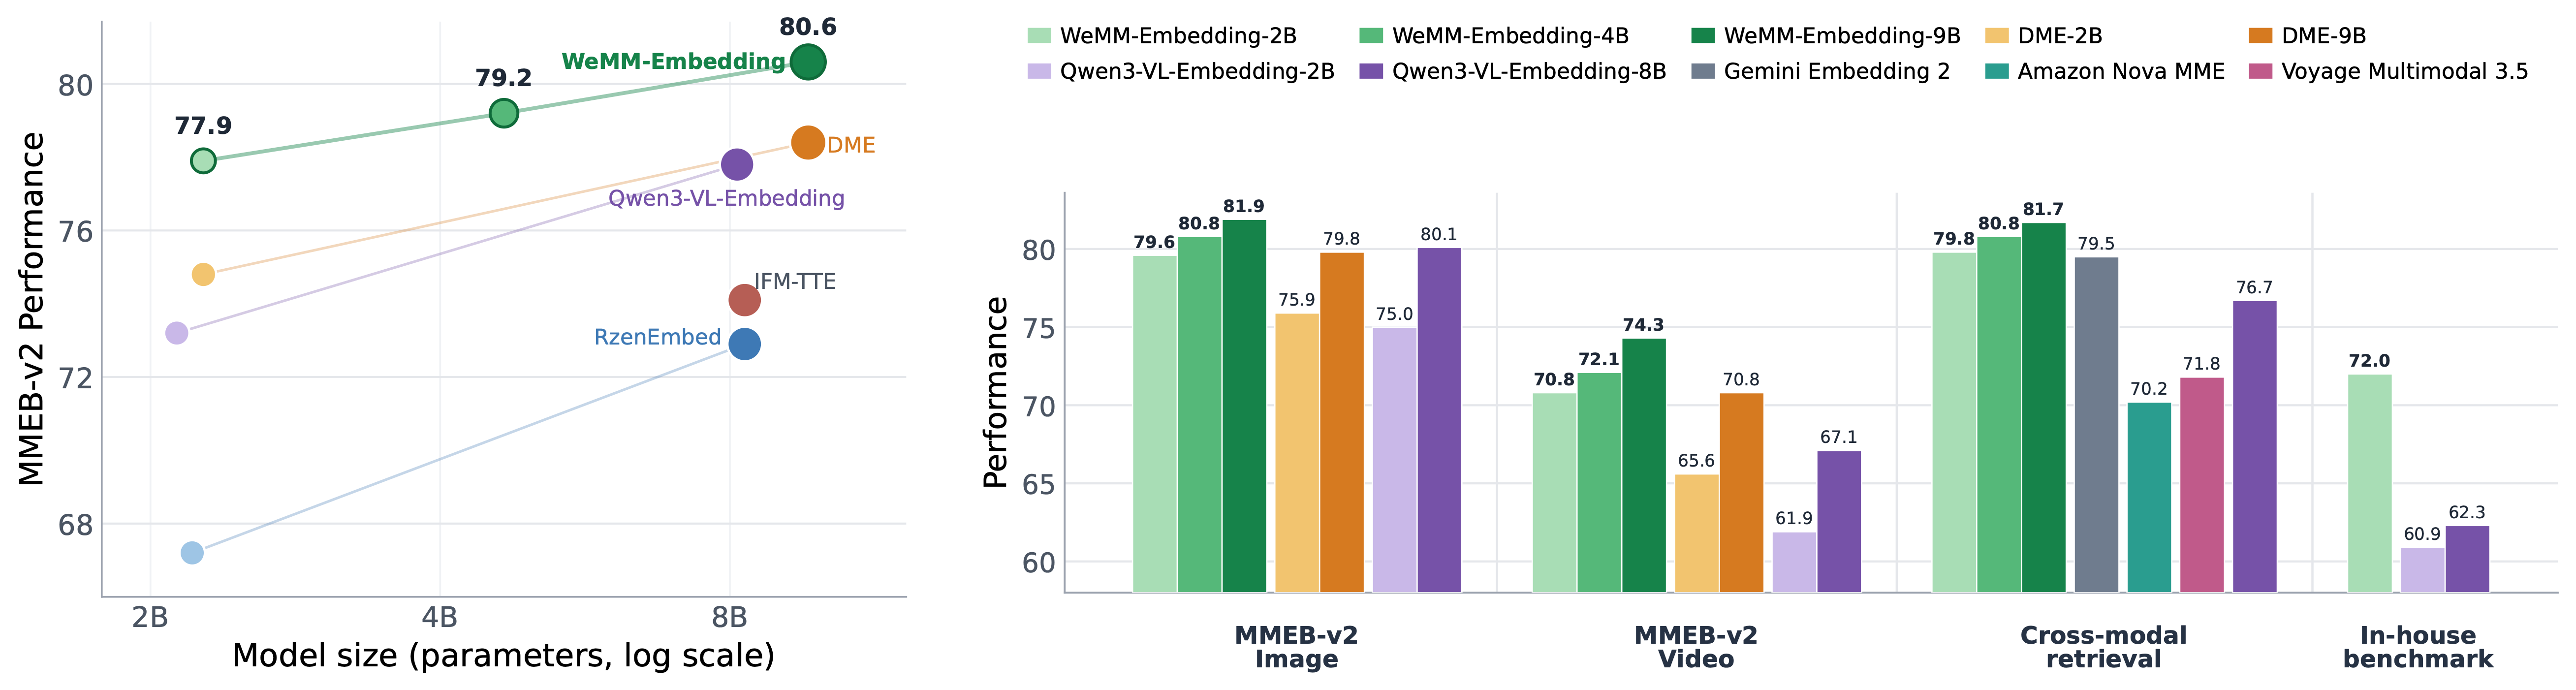 WeMM-Embedding 在 MMEB-v2、跨模态检索和内部基准上的性能总览
分任务看,WeMM 9B 在图像、视频和视觉文档上的成绩分别是 81.9、74.3 和 83.3。视频是模型之间差距最明显的部分:WeMM 2B 得到 70.8,高于 Qwen3-VL-Embedding 2B 的 61.9;9B 版本则进一步提升到 74.3。
这些数字来自项目技术报告与仓库公开表格,说明 WeMM 在其采用的评测设置下具有明显竞争力。实际选型仍需要结合业务数据复测,尤其是中文内容、长视频、领域文档和线上延迟等公开榜单未必充分覆盖的条件。
#MMEB-v3:把文本、Agent 任务也纳入评估
MMEB-v3 将范围扩展到 190 项任务,包括原有 78 项 MMEB-v2 任务、53 项文本任务、47 项 Agent 任务、11 项音频任务和 MCMR。未支持的任务会计为零分,因此 WeMM 的音频成绩为零,也会拉低总平均分。
即便如此,项目报告中三个 WeMM 版本的 V3-All 分数仍达到 56.0、58.2 和 59.5。9B 模型的文本、Agent 与 MCMR 成绩分别为 48.8、51.0 和 49.3,均为表中最高值。2B 版本的 Agent 任务成绩为 45.1,也高于表中多款 7B 或 8B 对照模型。
仓库还发布了生成这些结果的 MMEB-v3 评测代码。它基于 VLM2Vec 官方流程做了有限修改,增加多节点多 GPU 推理、WeMM 预处理与批量推理,并采用 64 帧视频采样。公开评测管线让其他团队有机会复现成绩,而不是只能接受一张静态排行榜。
#从研究模型到线上服务
WeMM 支持通过 Transformers 和 Sentence Transformers 生成文本、图像与视频向量,也给出了基于 vLLM 和 SGLang 的服务方式。这让模型既能进入现有 Python 检索实验,也能以独立服务接入生产系统。
项目建议固定经过验证的依赖版本,以避免不同预处理行为影响复现。对于多模态 Embedding,这类细节尤其重要:视频采样帧数、图像缩放、查询指令和归一化方式,都可能改变最终相似度和榜单结果。
腾讯自有代码默认采用 Apache 2.0 许可证,第三方组件继续沿用各自许可证。模型已在 Hugging Face 发布,覆盖 2B、4B、9B 三档。对实际团队而言,最值得测试的组合不是一味追求 9B 满维向量,而是比较 2B 低维方案能否在自己的数据上保住质量;如果可以,它可能带来更大的系统级收益。