自动研究 Agent 会连续提出想法、修改代码、运行实验,再把结果写回下一轮。表面上看,每轮都有新的 Diff;但这篇 EMNLP 2026 论文指出,系统可能已经进入 algorithmic mode collapse :实现细节变化很多,真正的算法机制却收缩到少数熟悉模板。
#代码差异掩盖了机制重复
研究者把候选方案按算法机制而非文本或行级 Diff 聚类。随着循环推进,代码距离仍显得活跃,语义簇数量却持续下降;训练中的优化分数继续上升,而留出评测差距扩大。系统因此可能把对某个局部评测的反复微调误认为新发现。
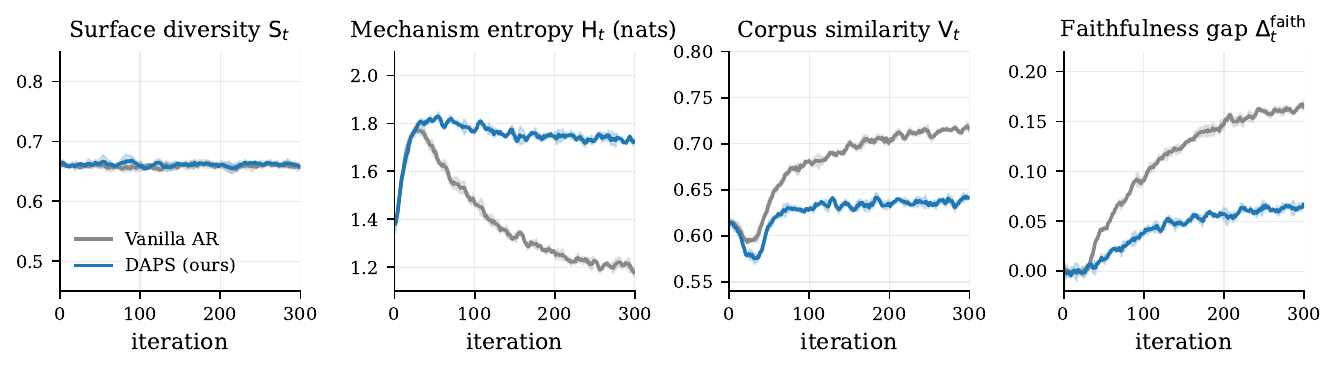 代码差异与算法语义多样性的诊断对比
#DAPS 把多样性变成调度信号
DAPS 不要求停止优化,而是在提案阶段记录机制簇,限制对拥挤区域的重复采样,并把候选分配给不同的探索方向。目标不是为了“看起来不同”而随机,而是在性能约束下维持可检验的机制差异。
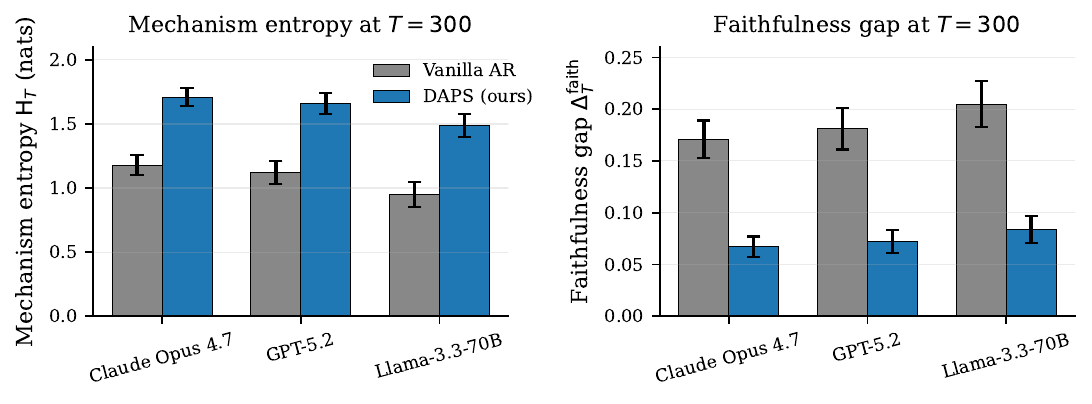 DAPS 在不同提案器上的多样性变化
结果显示,DAPS 将语义簇衰减降低 69.1%;相对忠实度在盲评中提高 83.7%,在带审计的评估中提高 81.6%,同时没有拖慢循环内优化。
#研究 Agent 需要两套仪表盘
第一套看性能:实验分数、成本和运行稳定性。第二套看认识论健康:机制簇覆盖、提案新颖度、负结果保留以及训练—留出差距。只看第一套,Agent 很容易找到一种有效套路后不断换皮。
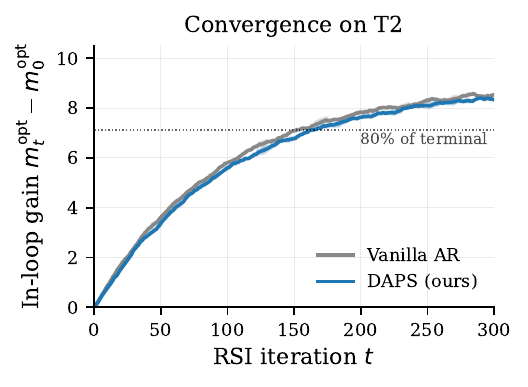 保持算法多样性所需的额外效率成本
这项研究把“创意枯竭”从主观评价变成可测量的系统故障。对于长时间自主运行的研究循环,成功条件不应只是最终最好分数,还应包括探索空间是否仍在扩张,以及结论能否在未参与优化的评测上站住。