软件工程 Agent 的成绩通常被压缩成一句话:某模型在“修 Bug”或“实现功能”的基准上通过了多少题。但相同标签之下,任务可能来自完全不同的筛选流程,要求触及的代码范围、引入的新逻辑以及修改位置在依赖图中的重要性也可能截然不同。
这篇研究提出 SNC Profile,把问题从“这道题叫什么”改成“完成它究竟需要做什么”。
#标签只能描述意图,不能描述工程负荷
团队分析了 SWE-bench Verified、SWE-Gym Lite、FEA-Bench、FeatBench 和 FeatureBench,并收集两个模型家族、三个规模,共 14,922 条执行轨迹。
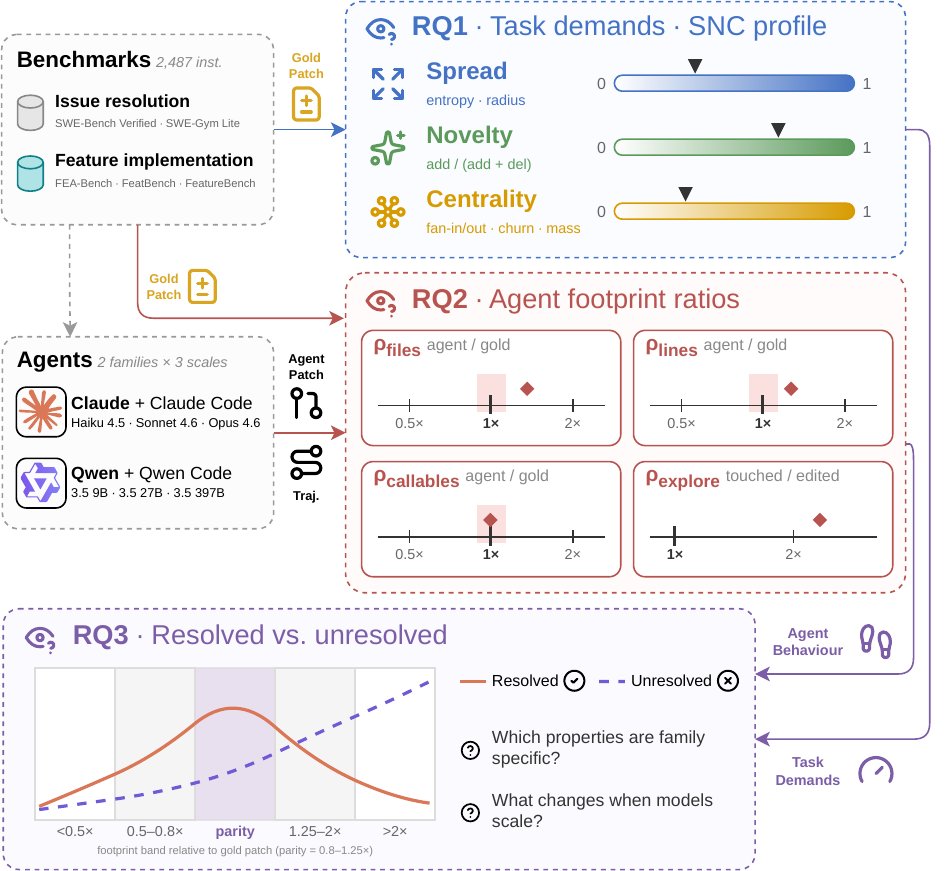 SNC 研究如何连接任务、轨迹与结果
传统类别大多来自提交说明:fix、feat、refactor 等。它们能说明作者想做什么,却无法回答改动是否跨越多个模块、是否引入仓库里从未出现的调用关系,以及是否触及大量其他组件依赖的核心节点。
SNC 因此定义了三个轴:
- Spread:改动在文件、函数和依赖邻域中有多分散;
- Novelty:解决方案引入了多少相对仓库历史的新结构;
- Centrality:被修改代码在依赖网络中有多关键。
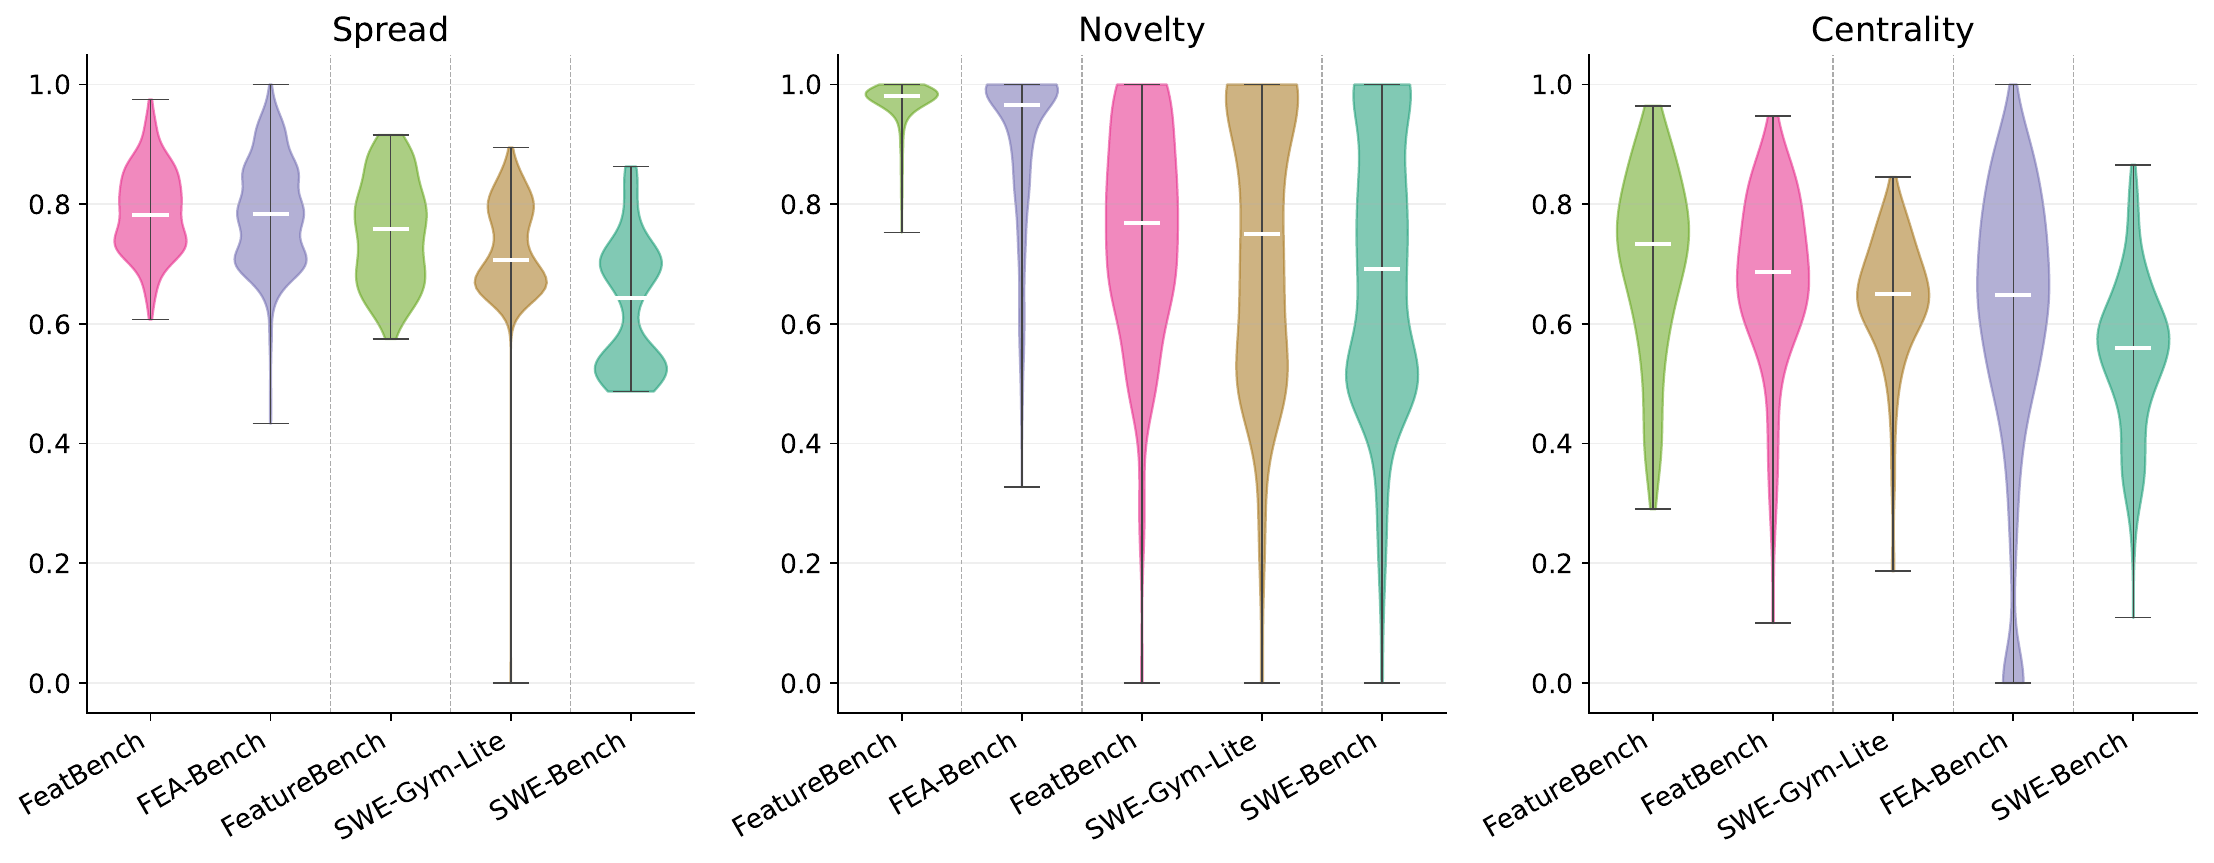 五个基准在 SNC 三个聚合维度上的统计分组
结果很直接:任意两个基准至少在两个 SNC 轴上存在统计显著差异。即使 FeatBench 与 FeatureBench 的标签分布几乎相同,它们的任务需求仍明显不同。所谓“功能实现能力”并不是一个稳定的测量对象,它会被数据构建方法重新定义。
#标准答案也不是完整真相
研究进一步比较 Agent 轨迹、最终补丁与人工黄金补丁。一个重要发现是:只看黄金补丁会漏掉题目给 Agent 带来的真实搜索负担。
当问题描述隐藏了关键提示时,Agent 往往要探索更大范围,最终补丁也可能比黄金答案更大;当数据构建流程人为扩大黄金补丁时,Agent 反而可能用更小的改动完成任务。任务措辞不仅影响是否成功,也改变 Agent 会生成怎样的工程行为。
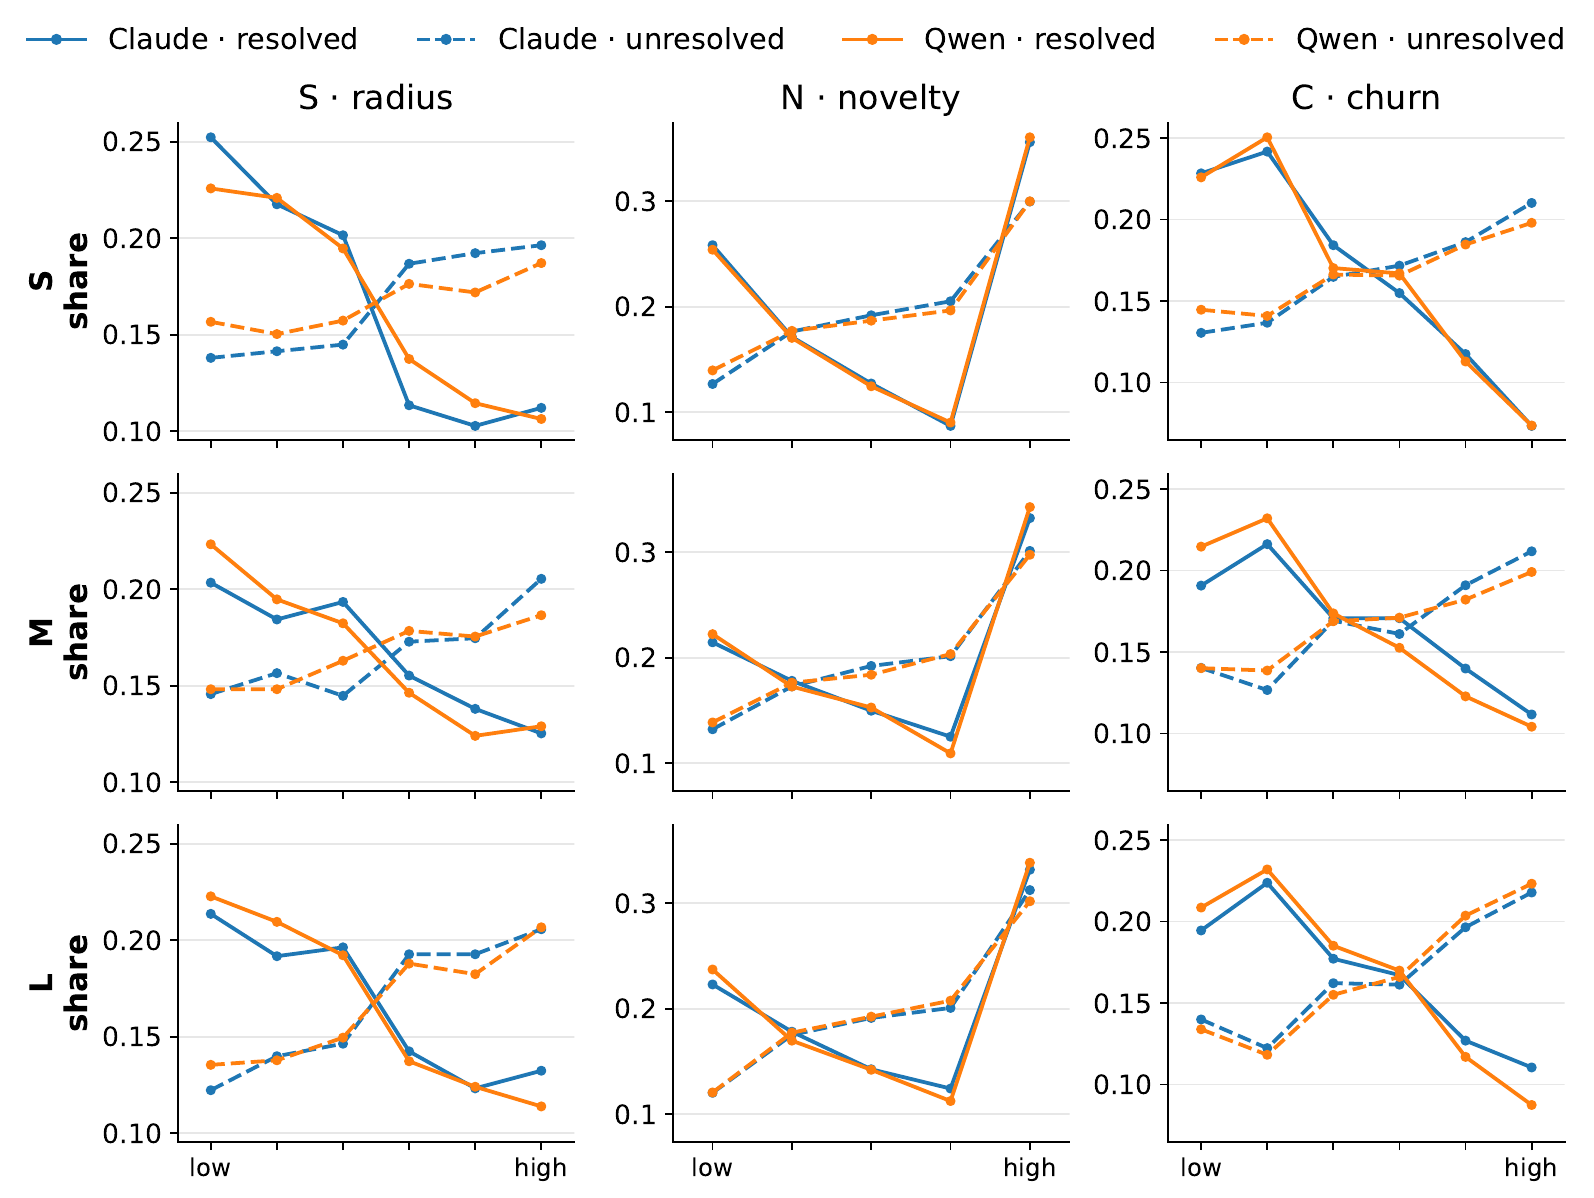 成功与失败轨迹在任务需求和行为足迹上的差异
低 SNC 区域在所有模型中都更容易成功:范围小、结构新颖度低、依赖影响有限的任务更容易被解决。但“成功时该怎样改代码”并不统一。
Claude 家族的成功更常表现为改动范围逐渐接近黄金补丁,文件数量对齐比例从小模型的 0.17 升到大模型的 0.54;Qwen 家族则在各个规模上都更倾向于超过黄金补丁的范围。对两个家族而言,改得过少都与失败相关,但最佳行为并不是同一模板。
#评测应该报告任务轮廓,而不只是平均分
SNC 不是为了再造一个总分,而是提醒评测者把任务分布公开出来。一个模型在低中心性的小范围修复上领先,不等于它能处理跨模块、高新颖度的功能建设;两个榜单都写着“Bug Fix”,也不意味着分数可以横向比较。
更可靠的报告至少应同时给出任务的 SNC 分布、模型在各区域的成功率、轨迹与最终补丁的行为差异,以及数据筛选流程。只有这样,基准结果才能回答“Agent 擅长什么”,而不只是“Agent 在这份题单上得了多少分”。