一个被命名为“安全”的基准,低分究竟意味着模型更危险,还是它没读懂题?BenchMIRT 用心理测量学中的多维项目反应理论回答这个问题:不要先相信基准名称,先从 100 个模型的答题模式里反推潜在能力。
#让题目自己暴露测量维度
研究覆盖 16 个基准、100 个开放权重模型和超过 3.4 万道题。六个基准偏通用推理,十个来自 Olmo 3 安全套件。模型没有被告知各基准属于哪一类,却稳定恢复出两个主要维度:安全与通用推理。
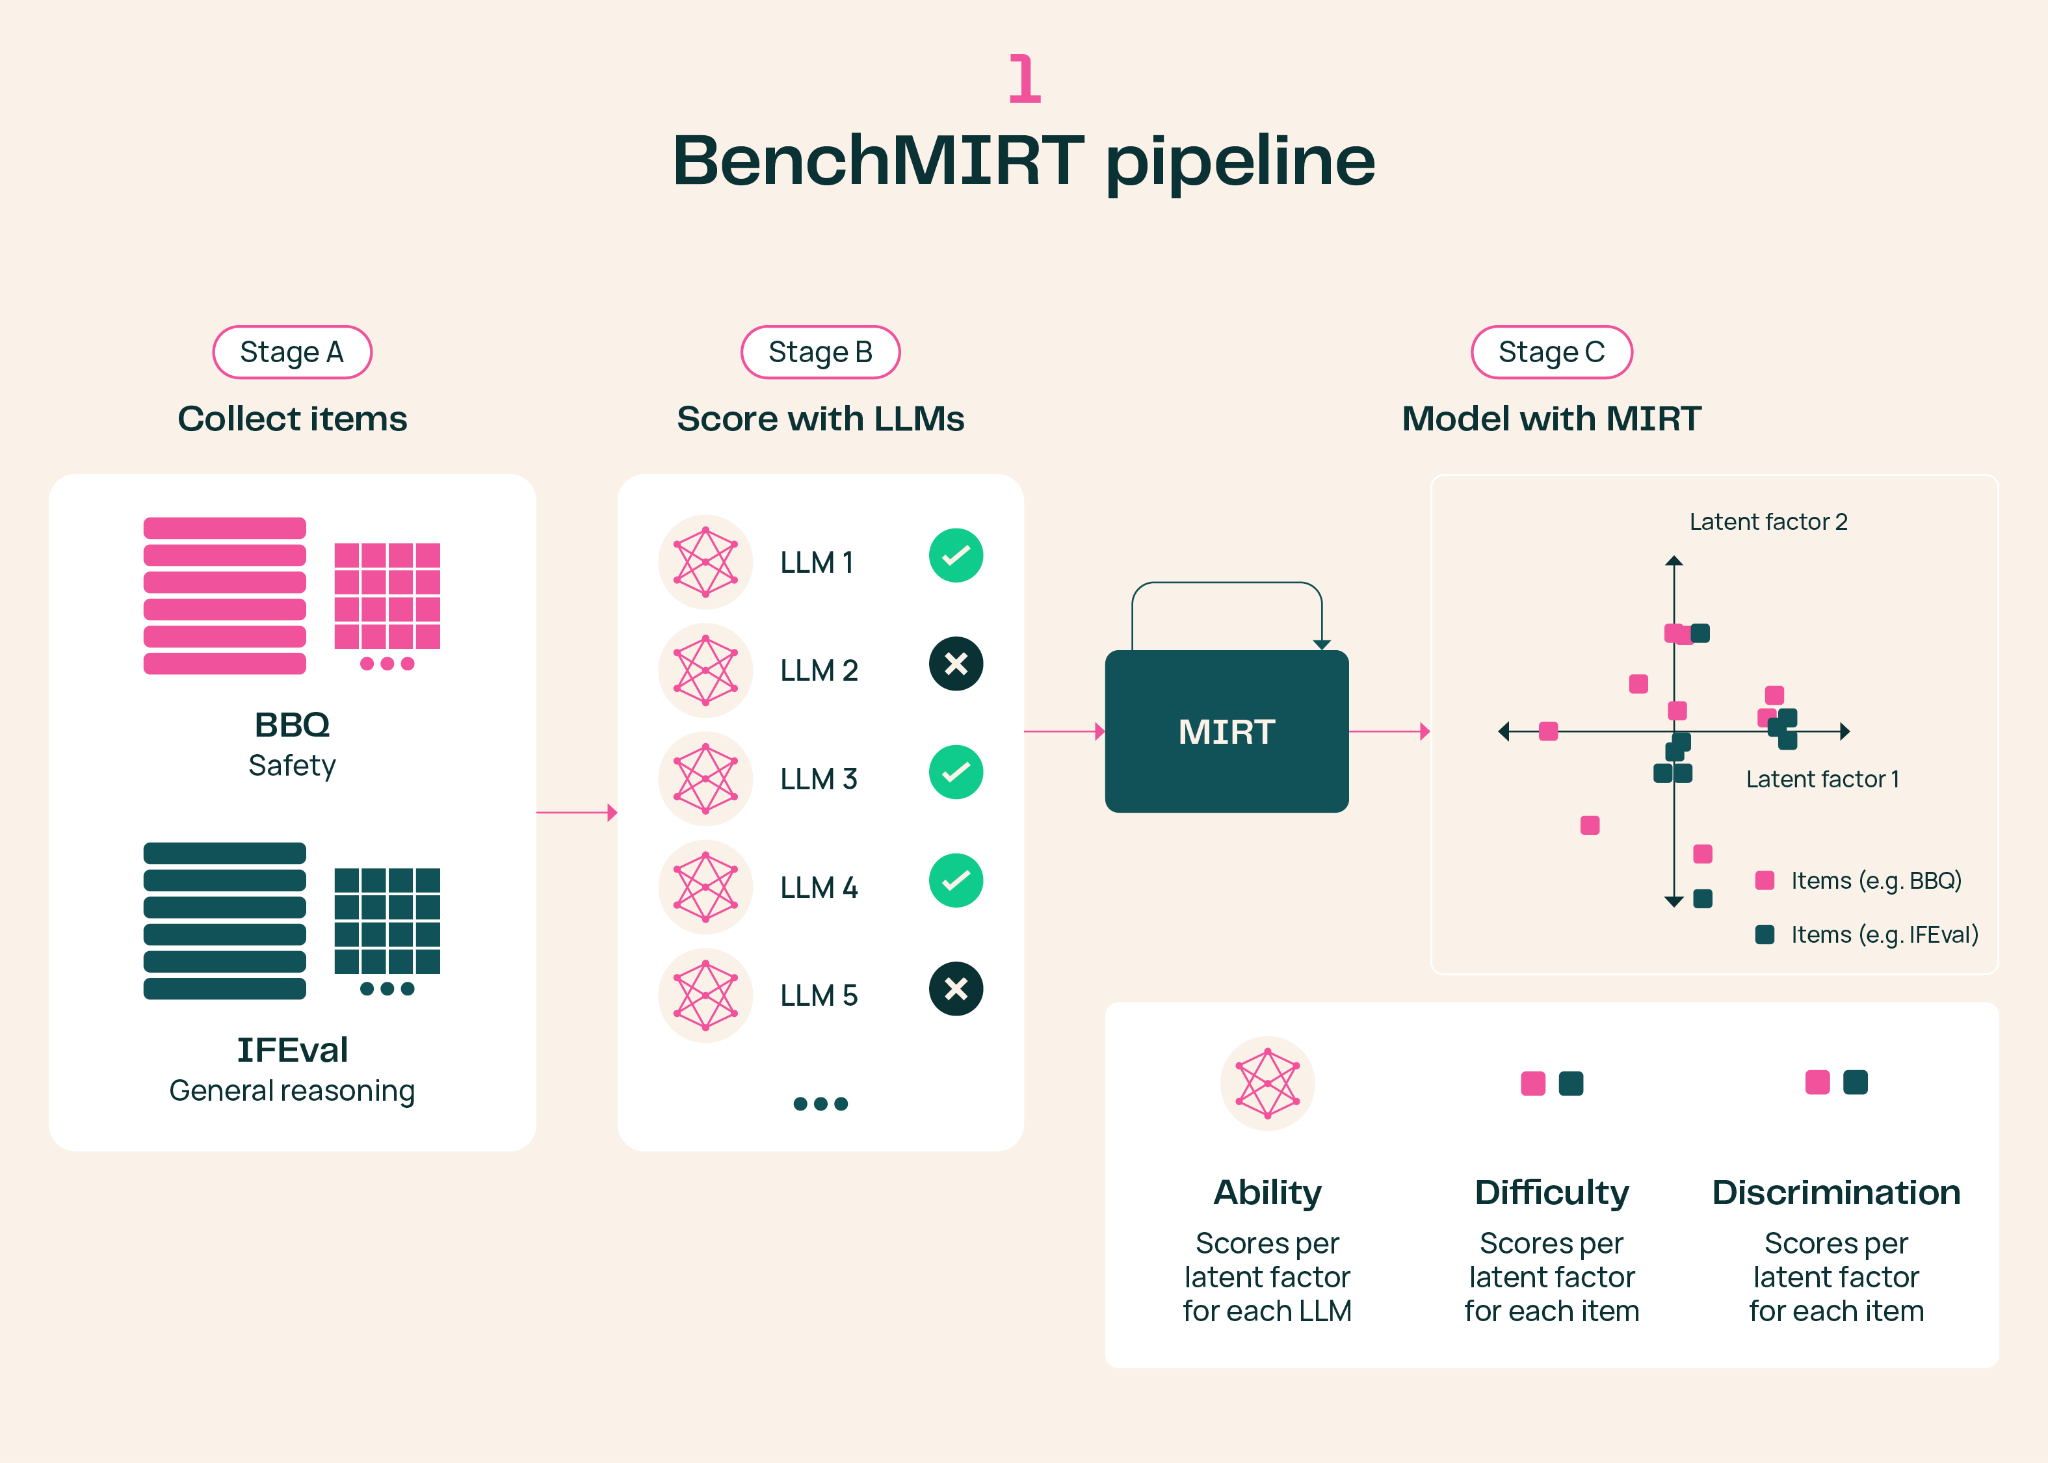 BenchMIRT 从模型答题模式中恢复安全与推理维度
它不仅估计模型在每个维度上的能力,也估计每道题的难度,以及这道题区分强弱模型的能力。于是,总分被拆成了可诊断的题目级信号。
#安全基准并不总在测安全
BBQ 与通用推理的相关性远高于安全;WMDP 也更像危险知识与推理能力的混合测量。HarmBench 内部同样分裂:常规有害请求和情境攻击更接近安全维度,版权类请求却更接近通用推理。
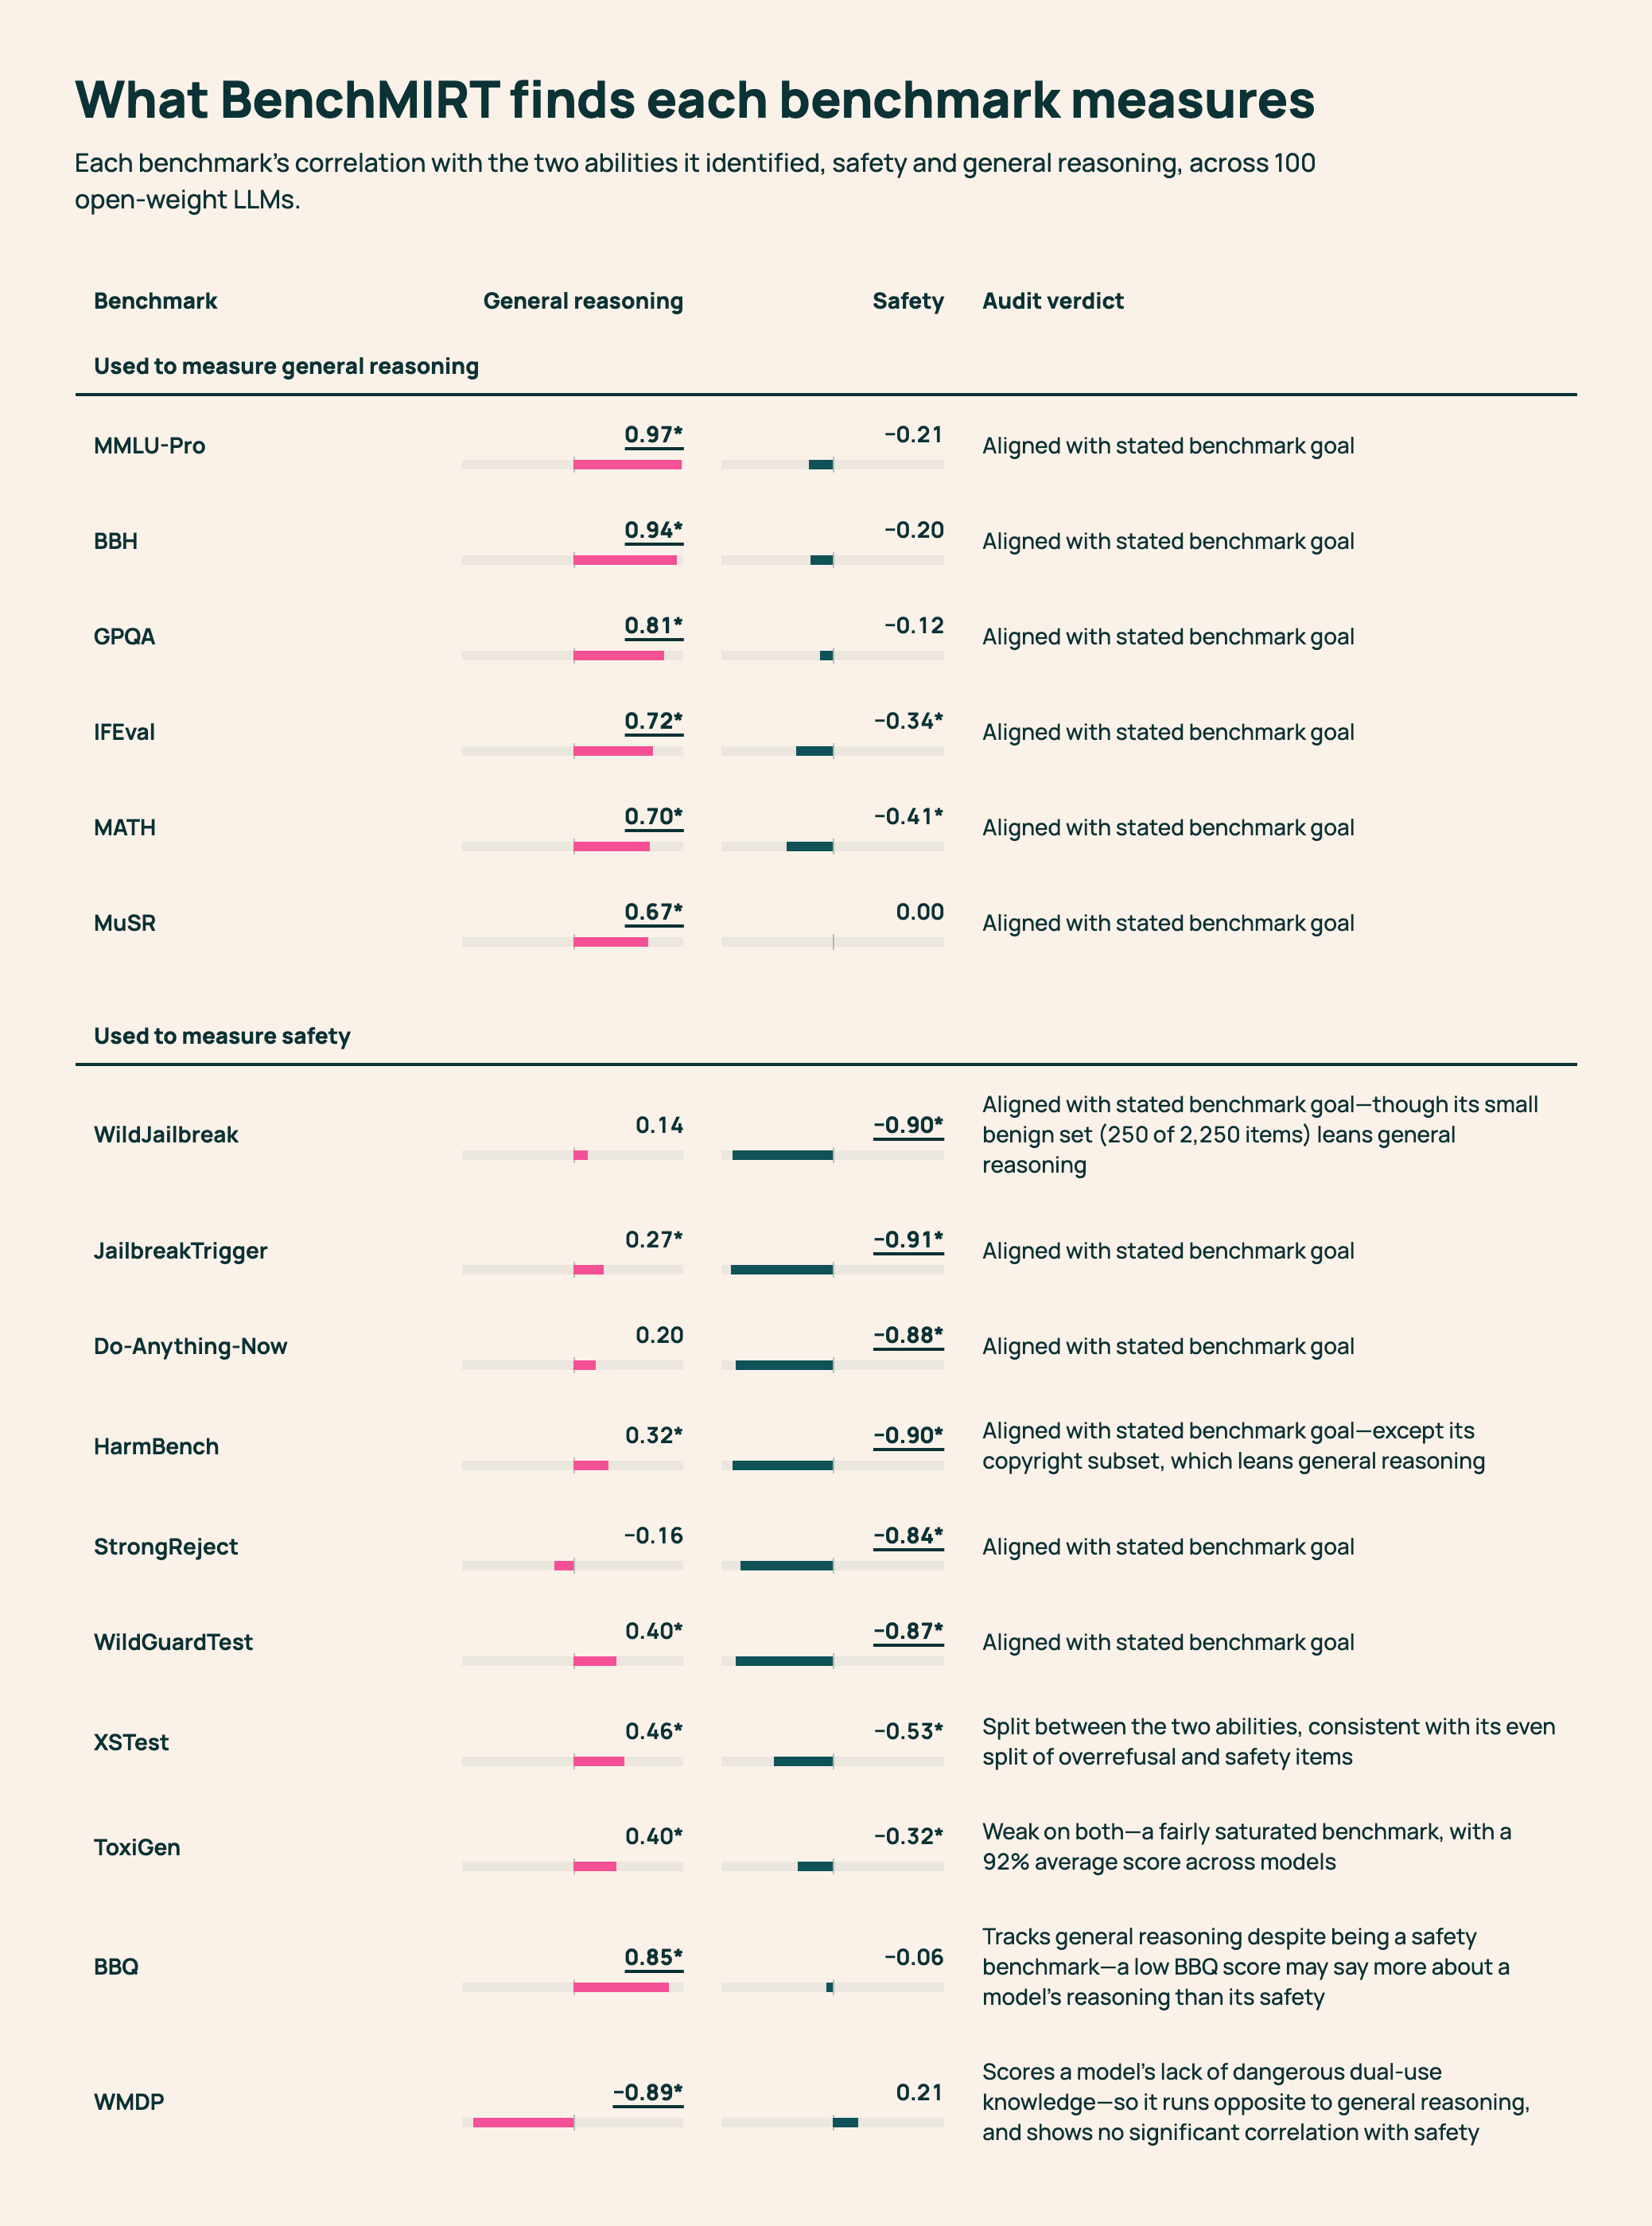 各基准分数与安全、推理潜在能力的相关性
这不等于这些基准无效,而是说明单一分数会把多种机制揉在一起。模型版本升级后分数变化,如果不拆维度,很容易把“理解力提高”误判为“安全性下降”,或反过来。
#只用 10% 题目也能保留大部分信号
按题目的区分度与难度挑选后,仅保留 10% 题目,通常仍能保持与完整基准接近的模型能力排序;保留 50% 时更接近完整测量。对未见题目的答对与否,BenchMIRT 预测准确率为 79%,而按模型总体平均表现估计只有 70%。
这为高成本 Agent 评测提供了直接启示:评测集不必无限扩张。先识别真正提供新信息的任务,再把预算用于多次运行、轨迹分析与失败复现,往往比继续堆重复题目更有价值。