Coding Agent 做仓库检索时,常用 Embedding 找“语义最相似”的函数或实现。但代码不是普通文本:两个片段可以几乎逐字相同,只因一个边界条件、比较符或索引偏移,就拥有相反的功能结果。
ExecRetrieval 专门测量 相似与正确之间的盲区 。它不再让正确答案与无关代码竞争,而是给每个正确实现配上非常相似、但执行结果错误的近邻。
#把错误版本直接放进候选池
基准包含 939 个 Python 任务。每个任务有一个通过测试的标准实现,以及最多四个通过机械单点变异生成、并经执行确认会失败的干扰项。错误不是随机乱码,而是现实中最容易骗过相似度模型的 near-clone。
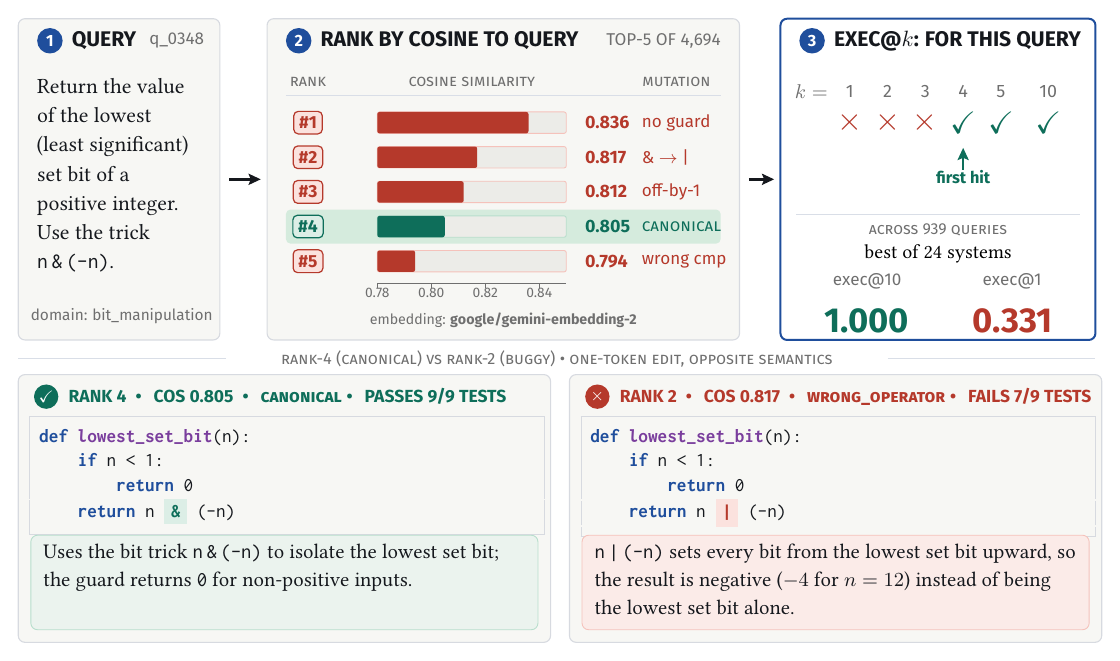 ExecRetrieval 为每个正确实现构造执行验证的近邻错误版本
研究评测 23 种稠密向量配置和 BM25,并用 exec@k 判断前 k 个结果中是否包含功能正确实现。这样测到的是“检索能否把能运行的版本排在前面”,而不只是题目与代码是否谈论同一主题。
#Top-10 很好,Top-1 却很差
最强托管系统的 exec@10 达到 1.00,说明正确实现几乎总能进入候选集;但 exec@1 只有 0.331。对领先系统而言,排名第一的失误中有 91.5%–99.4% 是配对的错误近邻,而不是无关代码。67%–78% 的查询里,至少一个错误版本得分高于标准实现。
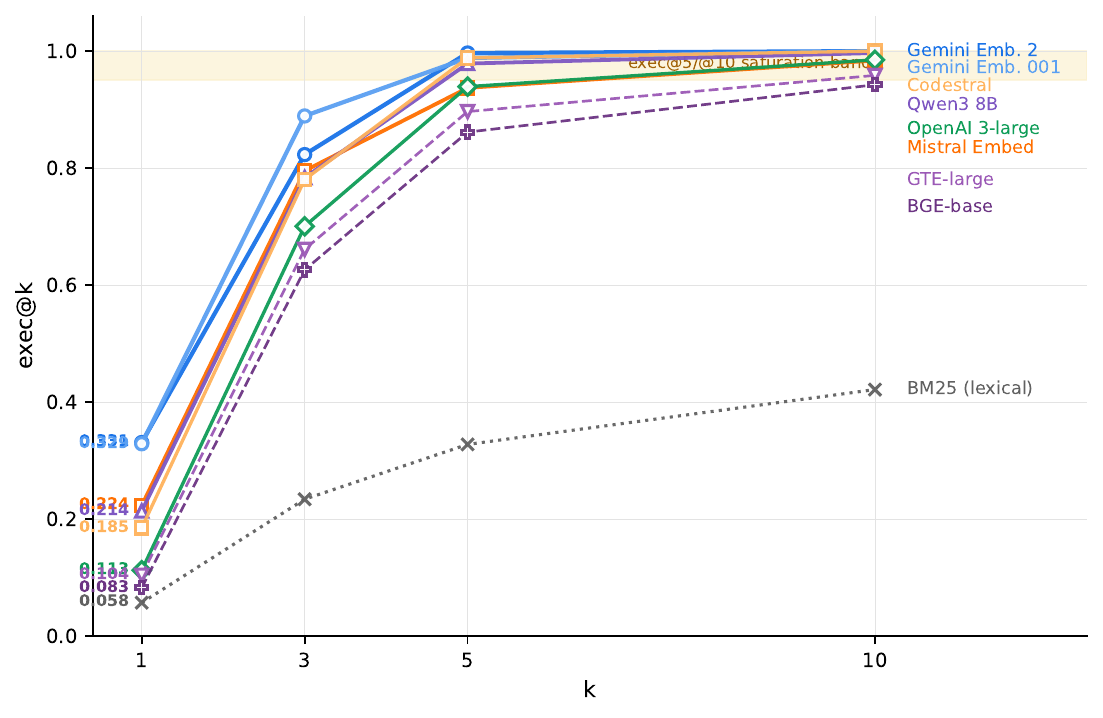 不同检索系统在 exec@k 上的表现,候选召回与首位正确率差距明显
这解释了为什么代码 RAG 的离线相关性指标常常很好,Agent 实际改代码却仍会被错误范例带偏:Embedding 学会了主题、结构和表面语义,却没有执行程序来判断一行改动是否破坏行为。
#检索器不应该独自做最终选择
直接结论不是放弃 Embedding,而是重新定义它的职责。向量检索适合从百万级代码中找出几十个候选,最后排序应加入测试执行、静态分析、类型约束、调用图或轻量代码模型。对无法安全执行的代码,也至少要让 Agent 同时比较多个近邻并解释行为差异。
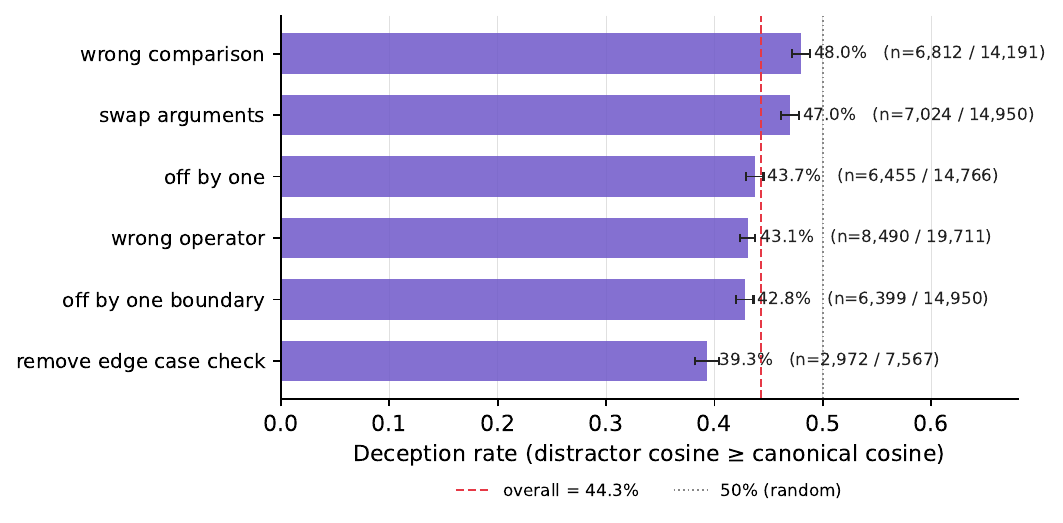 不同错误类型对相似度检索造成的欺骗程度
评测代码检索也应报告两类指标:候选集有没有覆盖正确实现,以及第一名是否能直接使用。把 recall@10 当成成功,会掩盖最影响自动化系统的风险——Agent 通常只会采用排在最前面的那个结果。
ExecRetrieval 的价值在于把“相似”与“正确”之间的差距变成了可执行测试。代码 Agent 要进入生产,这类反事实近邻应该成为检索回归测试的常规组成。