传统视频理解通常先按固定频率采样,再把抽出的帧交给模型。它简单,却会在无关片段上浪费大量 Token,同时错过只持续几秒的关键动作。Google DeepMind 的新方案改变了这一顺序:模型先理解问题,再决定应该去视频的什么位置取证。
#从固定采样变成主动检索
Agentic Video Understanding 会把长视频当作一个可查询环境。模型先形成初步判断,再调用工具跳转到相关时间段,以更高分辨率检查细节;证据不足时继续扩展或回看,直到能回答问题。它处理的是从十分钟到数小时的视频,而不是预先压缩好的一组静态截图。
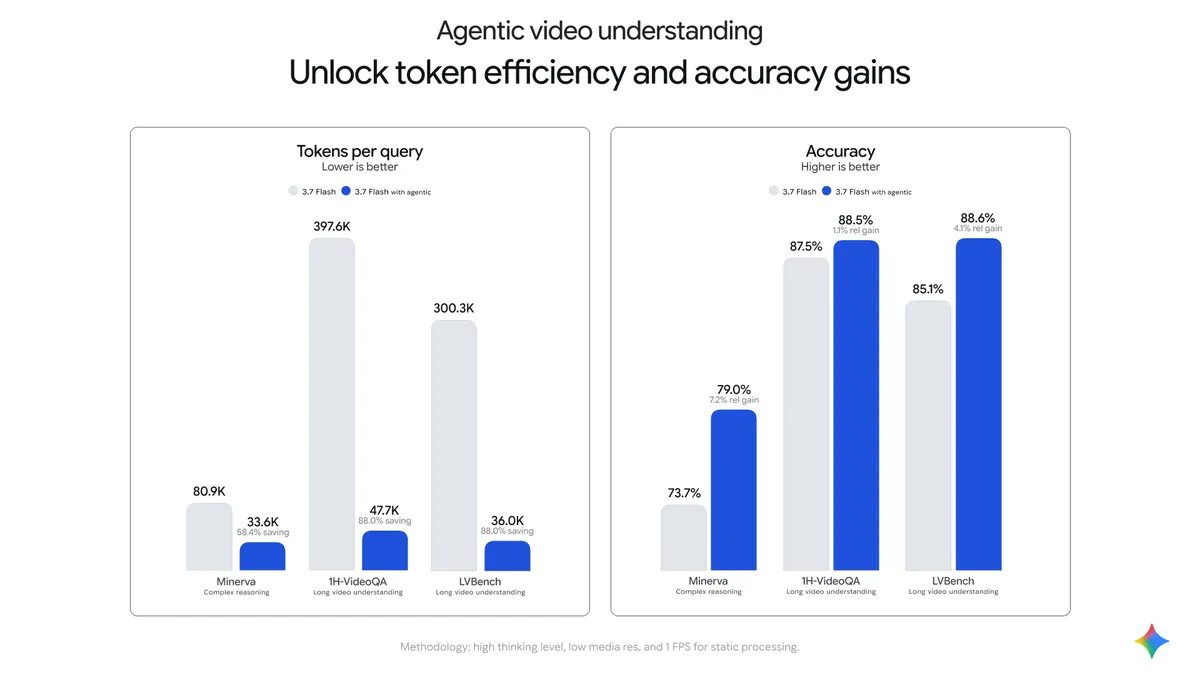 主动视频理解在 Token 效率与准确率上的变化
#少看,反而看得更准
相较固定帧率方案,论文给出的最好结果是减少 88% Token、降低 66% 单次查询成本,同时准确率提高 7%。这不是单纯压缩:系统把计算预算从大量无关画面转移到了与问题相关的局部片段。
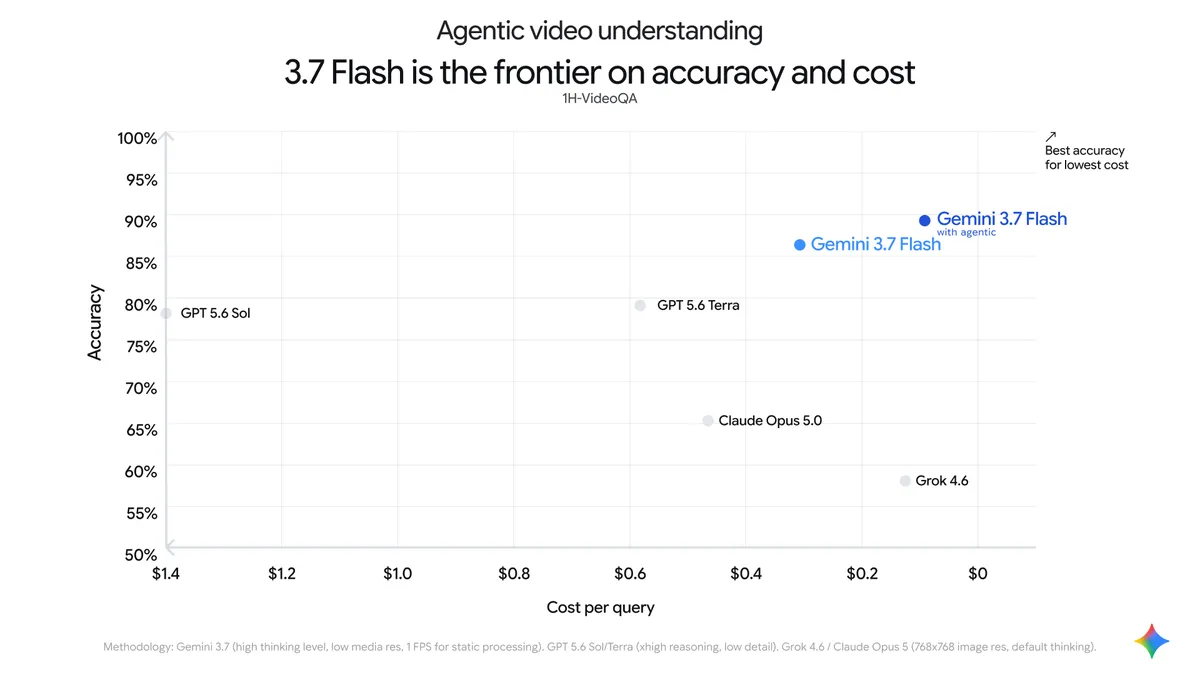 主动视频理解的成本—准确率前沿
这种机制尤其适合体育分析、内容审核、会议检索和安全取证。真正的难点不是识别某一帧里有什么,而是知道“接下来该去哪一段找证据”,并把多个时刻的线索串成可以复查的结论。
#视频由输入变成工具环境
流程图揭示了产品层面的变化:视频不再是一次性提交给模型的巨大输入,而是一个由 Agent 反复调用的外部信息源。查询、定位、局部读取、推理和再次查询组成闭环。
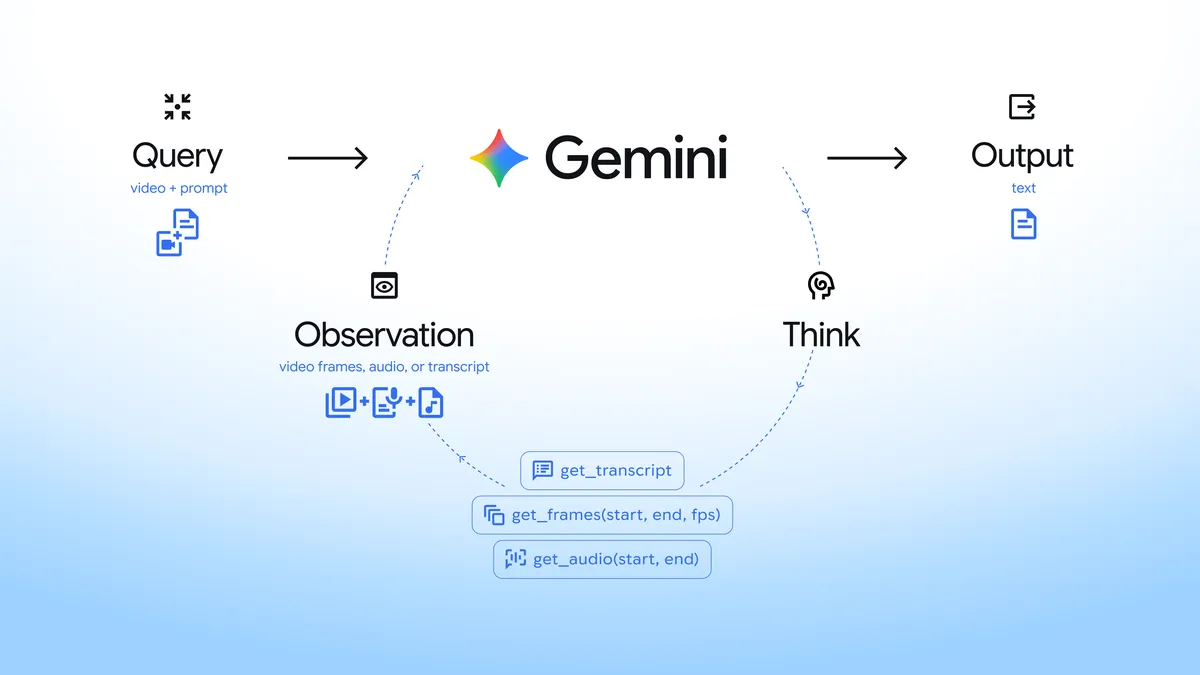 从问题到片段检索、局部检查和答案生成的流程
这也带来新的评测要求。系统不仅要答对,还要衡量检索了哪些片段、是否漏掉反例、花了多少 Token,以及引用的时间范围能否支持结论。未来的多模态 Agent 竞争,核心会从“能看视频”转向“会管理自己的视觉注意力”。