同一个模型,换一套上下文管理、工具策略、恢复机制和验证流程,最终成绩可能完全不同。Agent Harness 已经不再是中性的“测试外壳”,而是能力本身的一部分。
HarnessDev 提出了一个更激进的问题:既然模型能写软件,它能不能从极弱的种子出发,自己构建并持续改进驱动 Agent 的软件?
#评测的不是答案,而是会长期存在的基础设施
HarnessDev 分为 Creation 与 Evolution 两个阶段。创建阶段给模型一个能运行但不会主动完成任务的种子,以及少量公开开发样例;模型必须实现执行循环、工具策略、上下文管理、状态与记忆、生命周期恢复和结果验证。进化阶段则允许它读取下游反馈,修改此前创建的 Harness,并选择一个最终版本。
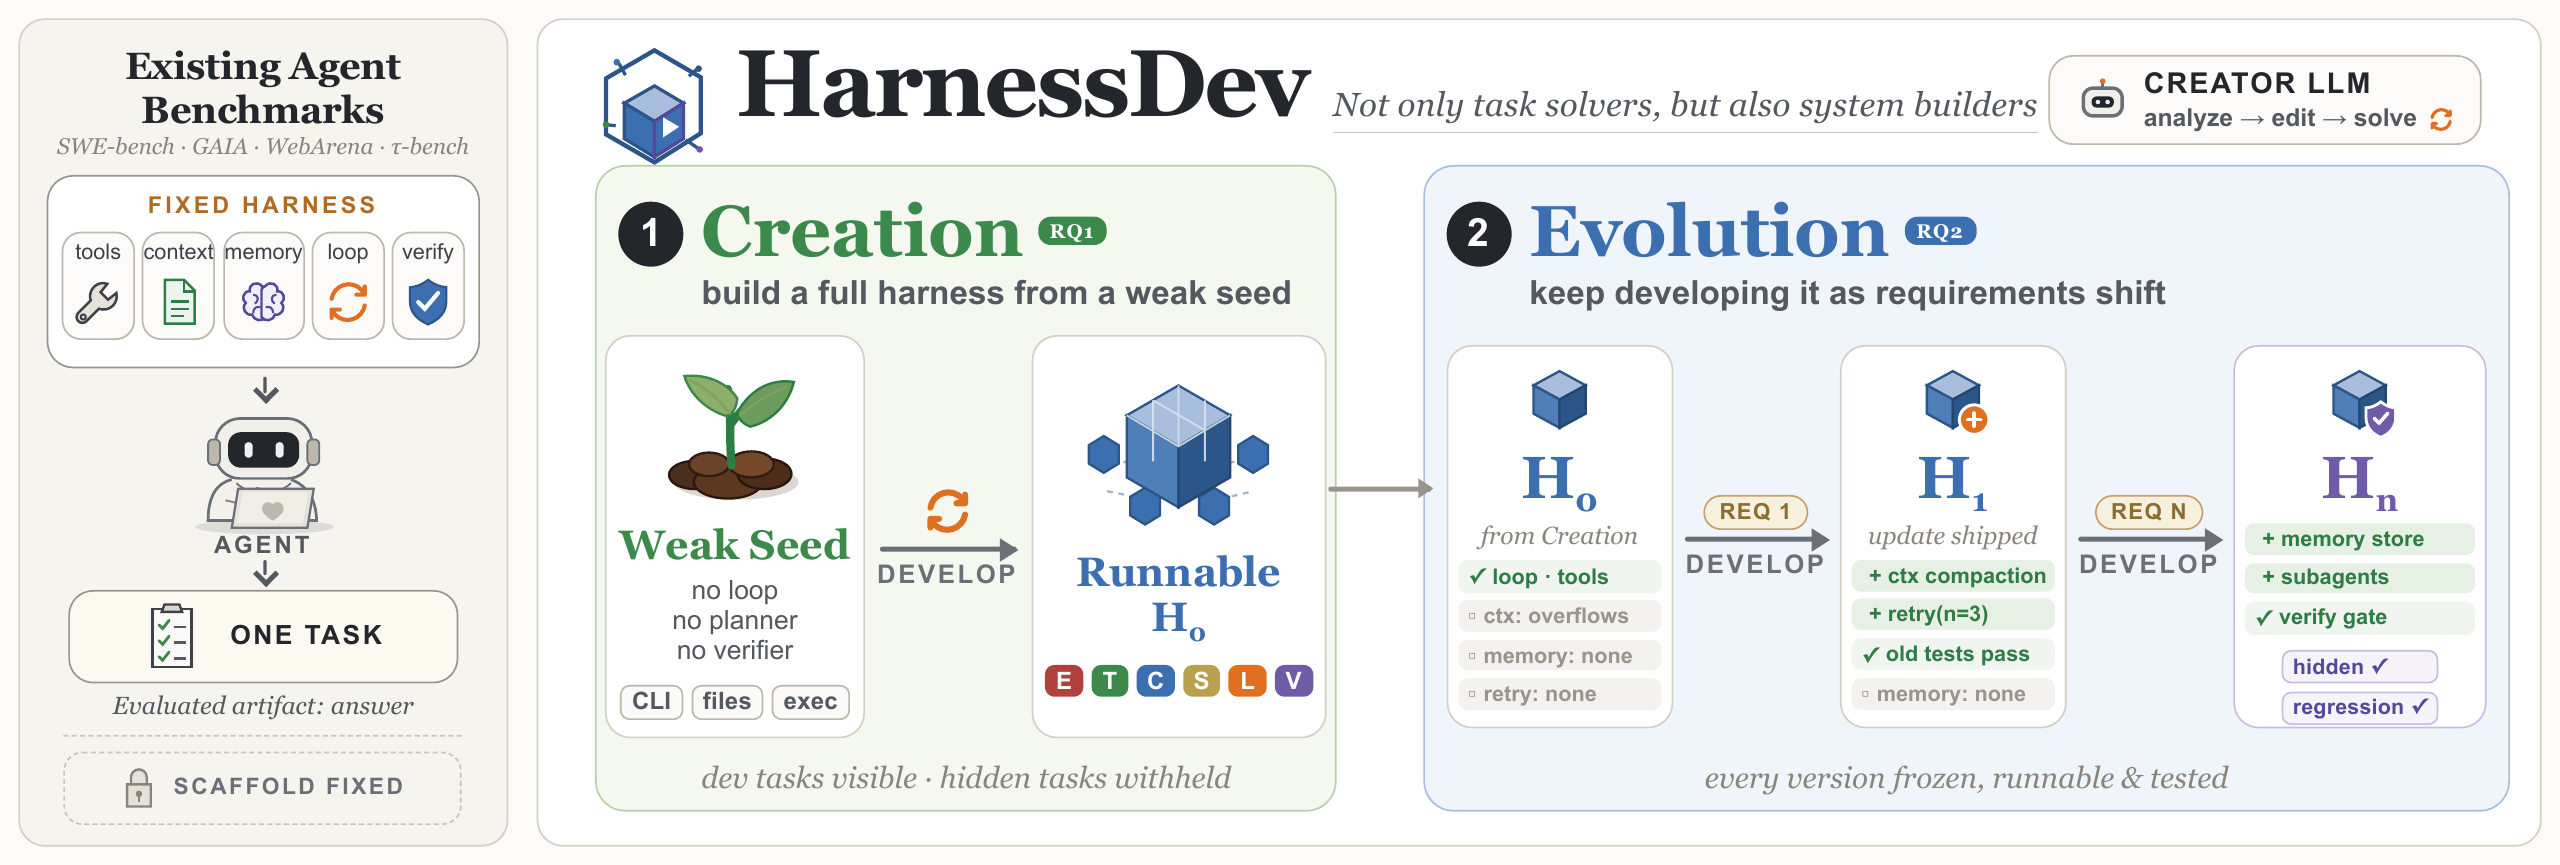 HarnessDev 的创建与进化阶段
隐藏任务、答案和正式分数始终不可见。最终交付物不是某一道题的输出,而是一套可重复运行、能在多道未见任务上工作的基础设施。研究还把执行模型固定下来重新测试,以区分“Harness 真有能力”与“创建它的模型恰好也最适合运行它”。
评测覆盖六个创建模型、四类领域和五个下游基准,共 2,207 个唯一测试实例。四个领域分别是代码、搜索与研究、写作、机器学习实验。
#模型能造出完整系统,但成熟工程仍有明显优势
生成的 Harness 并不只是几段提示词。研究在多数产物中观察到工具路由、上下文压缩、状态持久化、失败恢复和验证逻辑;不同模型也形成了不同架构偏好。
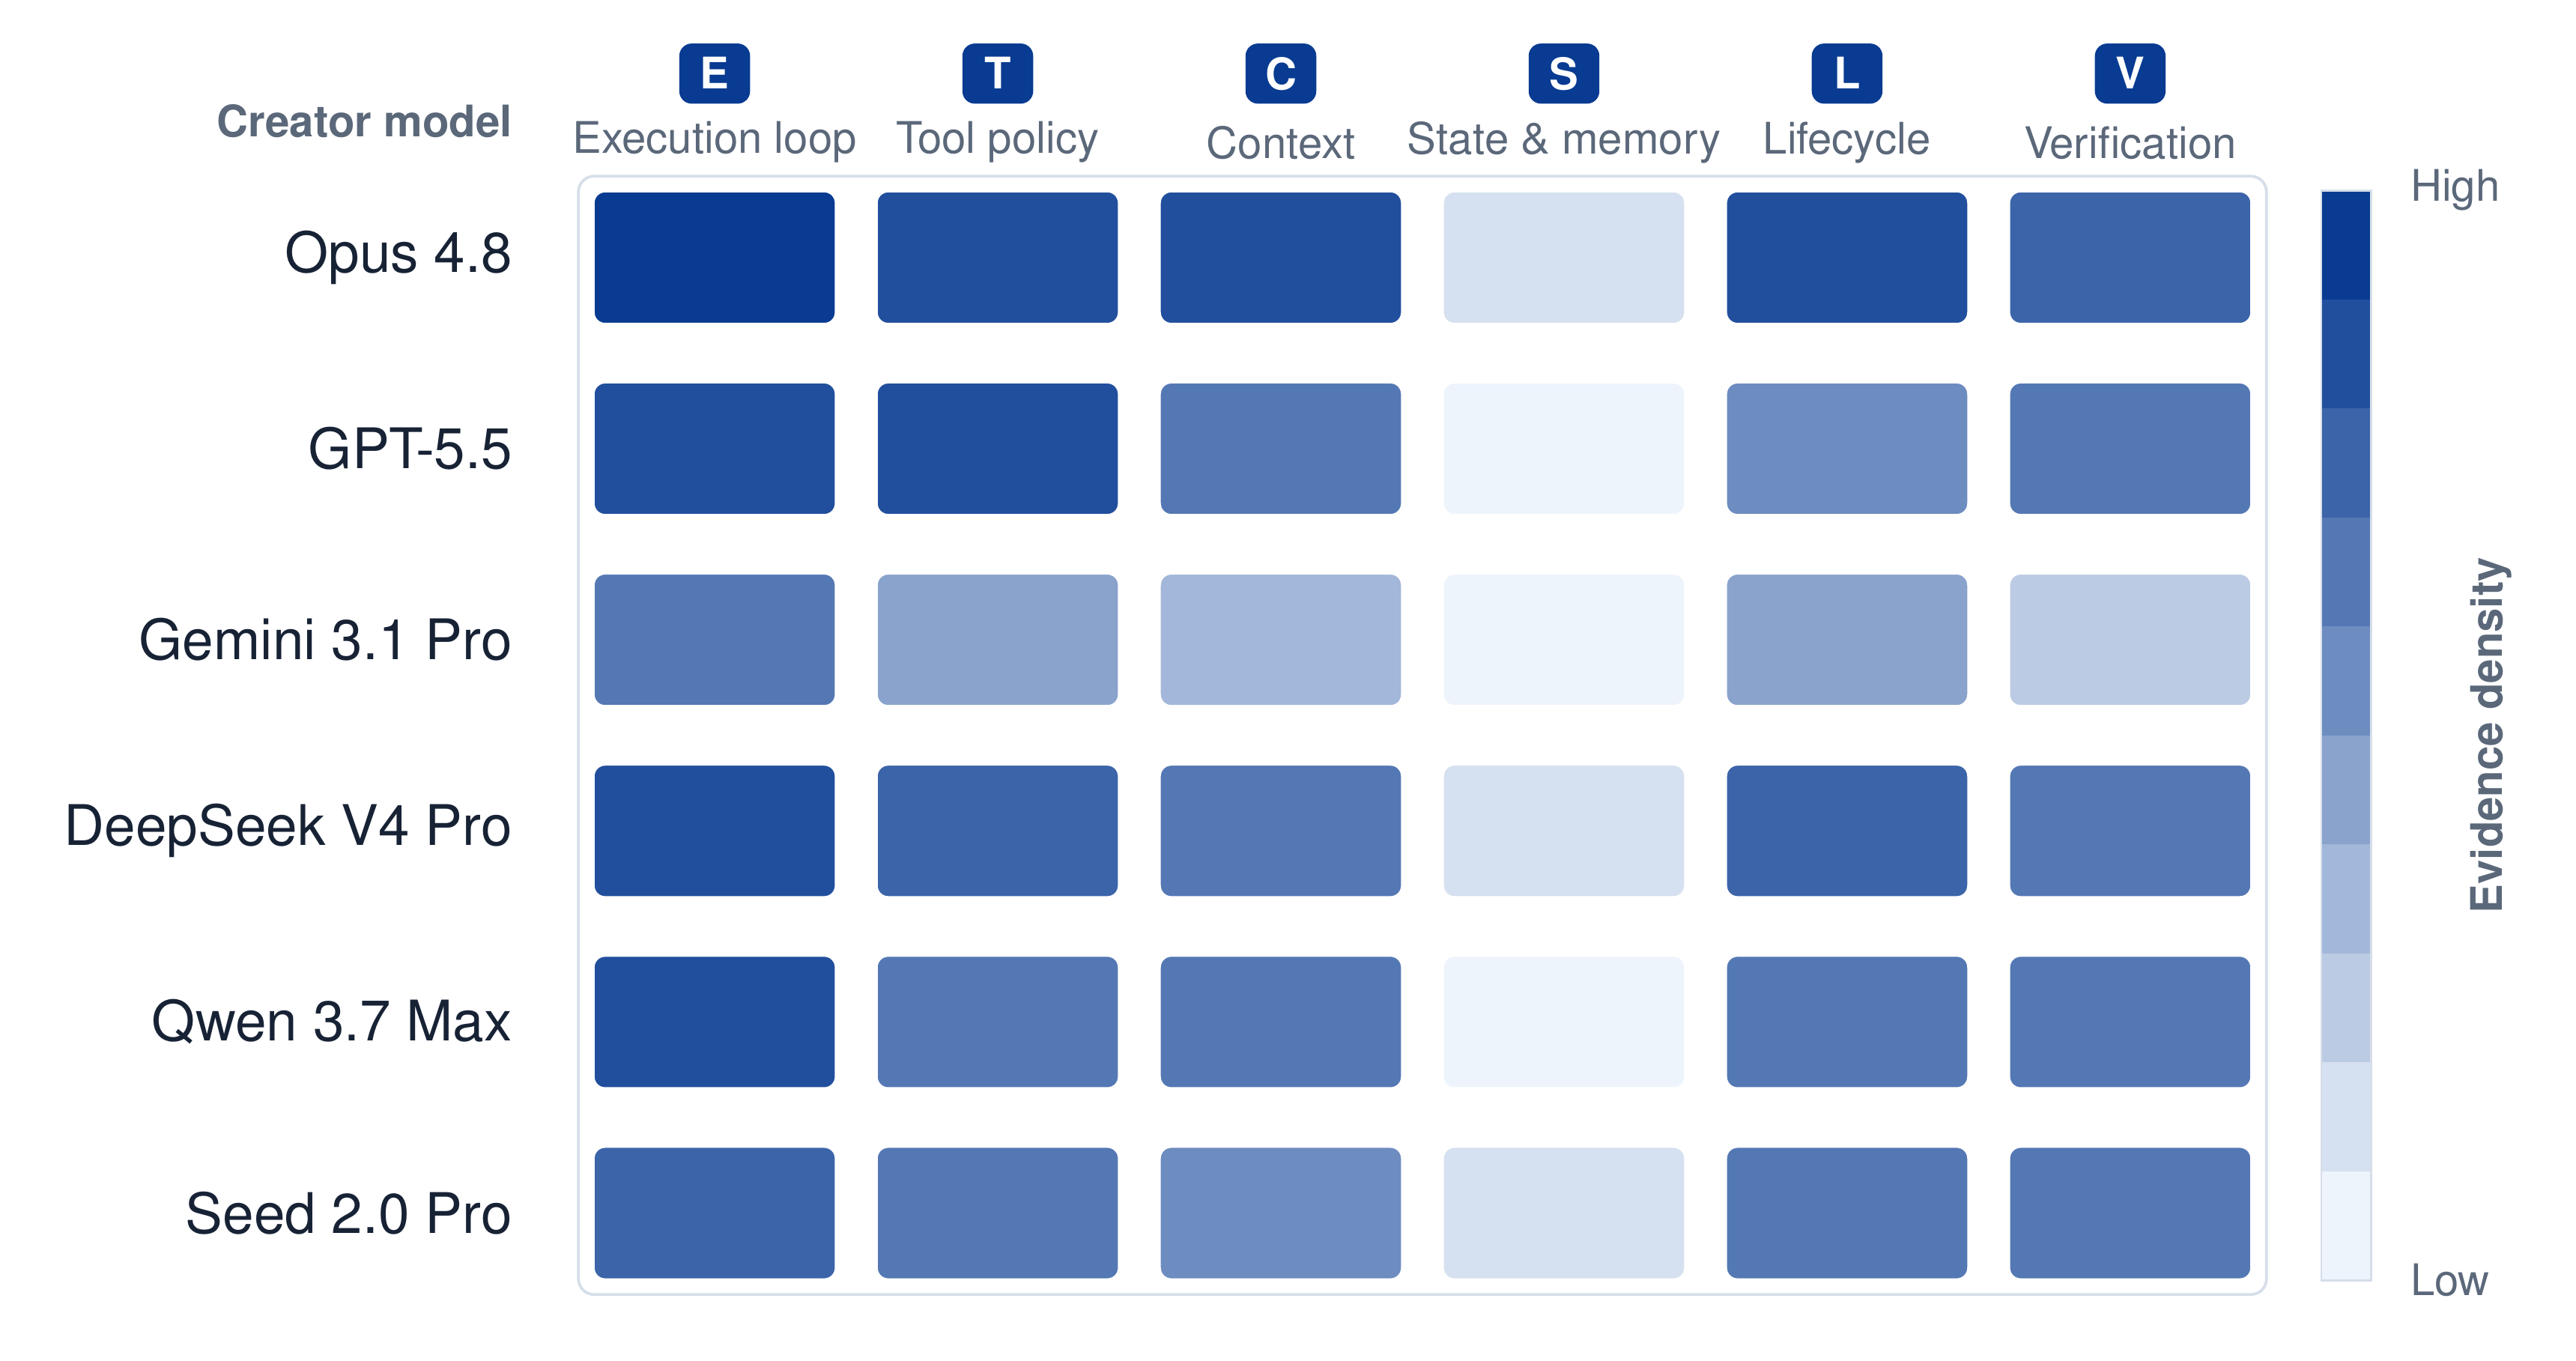 生成 Harness 在六类控制模块上的机制覆盖
但完整不等于成熟。在代码任务以及搜索与研究任务上,生成系统仍显著落后于选定的人类工程参考;在写作和机器学习实验上,一些模型创建的 Harness 能够追平甚至超过参考系统。这里的“超过”只表示超过这套外部参考配置,不代表超过人类能力。
成本差异同样巨大。相近成绩可能需要接近一个数量级不同的执行 Token。以 MLE-bench 为例,一个系统用 2930 万 Token 得到 19.1 的奖牌率,另一个用 2.084 亿 Token 得到 19.6。只看最终分数,会把系统效率这一关键属性完全抹掉。
#Harness 与执行模型之间存在耦合
把所有 Harness 交给同一个执行模型后,排名和分数会发生明显变化。
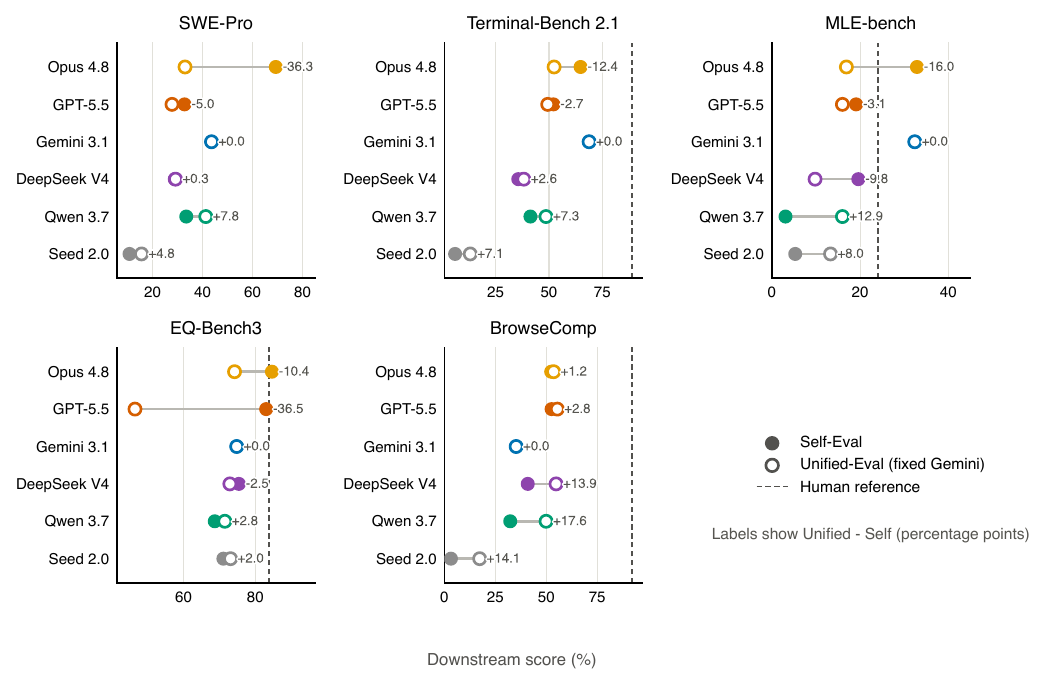 固定执行模型后的 Harness 迁移表现
这说明 Harness 不是一份与模型无关的通用程序。它可能依赖特定模型的工具调用习惯、上下文长度、错误恢复方式和推理风格。一个模型为自己构建出的高分系统,换模型运行后不一定保留优势。
进化阶段确实产生了一些提升,但过程并不单调。某些版本在可见反馈集上进步,却在冻结后的 630 个隐藏任务上退化;不同执行模型甚至会对同一次 Harness 修改给出相反结果。反馈循环最有效的情形,是 Agent 能定位具体失败原因,做出针对性改动,再进行端到端验证。仅凭几个小探针通过就宣布改进,常常会过拟合。
HarnessDev 最重要的贡献不是证明模型已经能取代 Harness 工程,而是把新的评测单位钉在了桌面上:未来比较 Agent 系统时,应该同时测模型、Harness、二者匹配关系、执行成本和跨任务泛化。只给模型名与通过率,信息已经不够了。