现有视觉语言模型已经能描述柱状图、读取折线趋势,也能回答静态截图上的问题。但真实数据产品很少把全部证据摊在一张图里:数值藏在悬停提示中,类别需要筛选,时间范围要拖动,多个视图还会相互联动。
InSight 把评测从“看图回答”改成“操作图表并核验证据”。
#交互不是界面噪声,而是取证过程
基准包含 21,349 条声明,来源是人类撰写的数据分析叙事,并配有完整可运行的交互式网页环境。Agent 需要判断声明属于 Supported、Refuted 或 Not Verifiable。
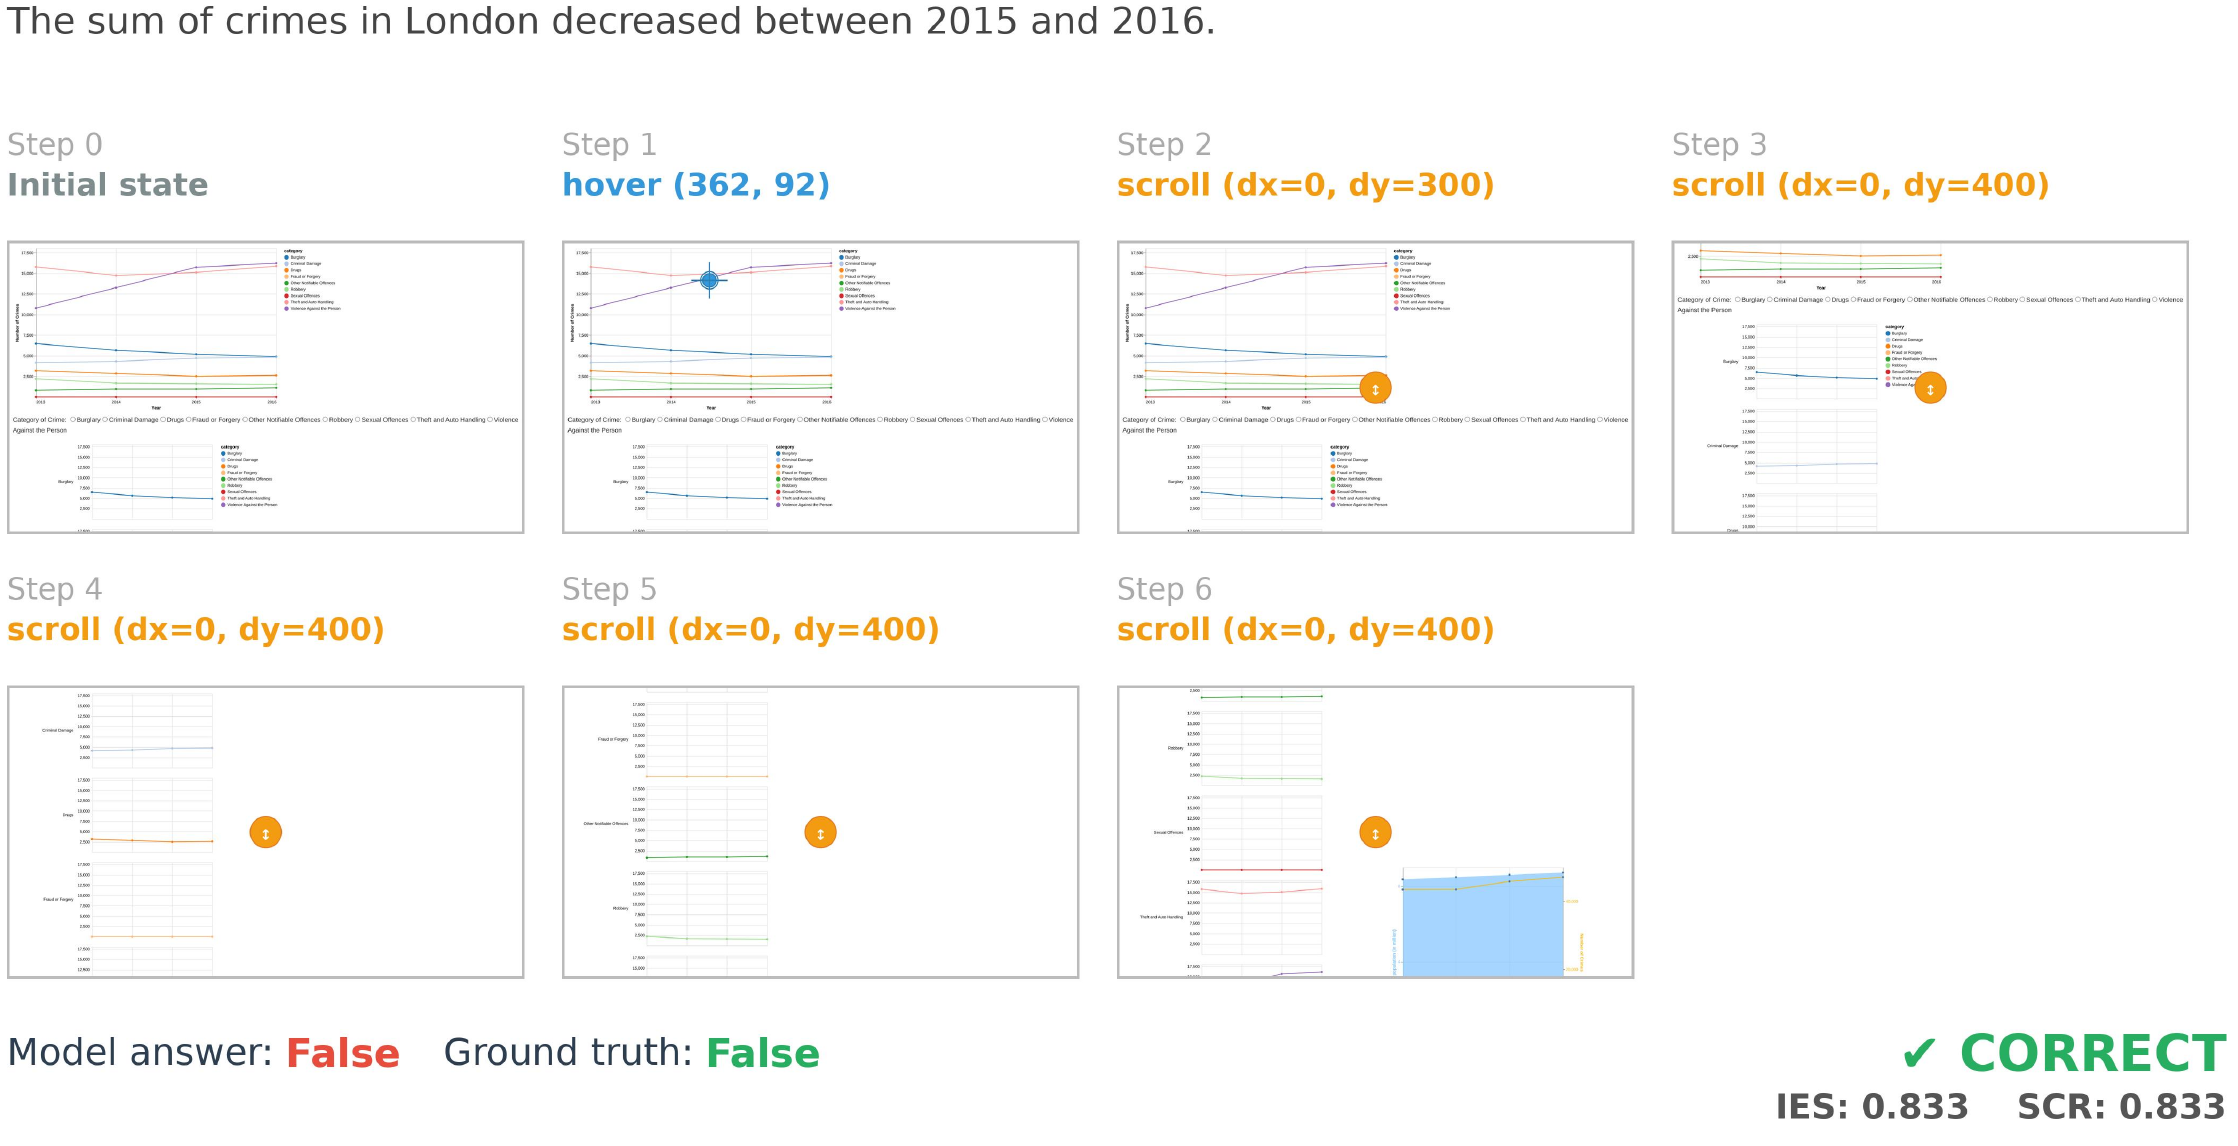 Agent 通过悬停与滚动核验伦敦犯罪趋势
例如,一条关于伦敦犯罪趋势的声明无法从首屏直接判断。模型先悬停读取某个数据点,再滚动到另一个联动视图补齐证据,最后才能正确判定为假。点击、悬停和滚动在这里不是通往答案的机械步骤,而是决定模型是否看见关键证据的推理动作。
InSight 因此保留完整交互轨迹,并设计 Interaction Efficiency Score,衡量 Agent 是否用合理动作找到证据。只评最终标签,会把“碰巧猜对”和“正确调查”混在一起。
#数据集怎样避免只生成简单真假题
团队先从人类分析文本中抽取带语义标签的片段,再拆成消解指代后的原子命题。真声明直接继承原始证据;假声明通过反义替换或词表内参数替换生成;无法验证声明则引入图表证据范围之外的新实体或取值。NLI 模型和人工流程用于检查变换是否保持预期关系。
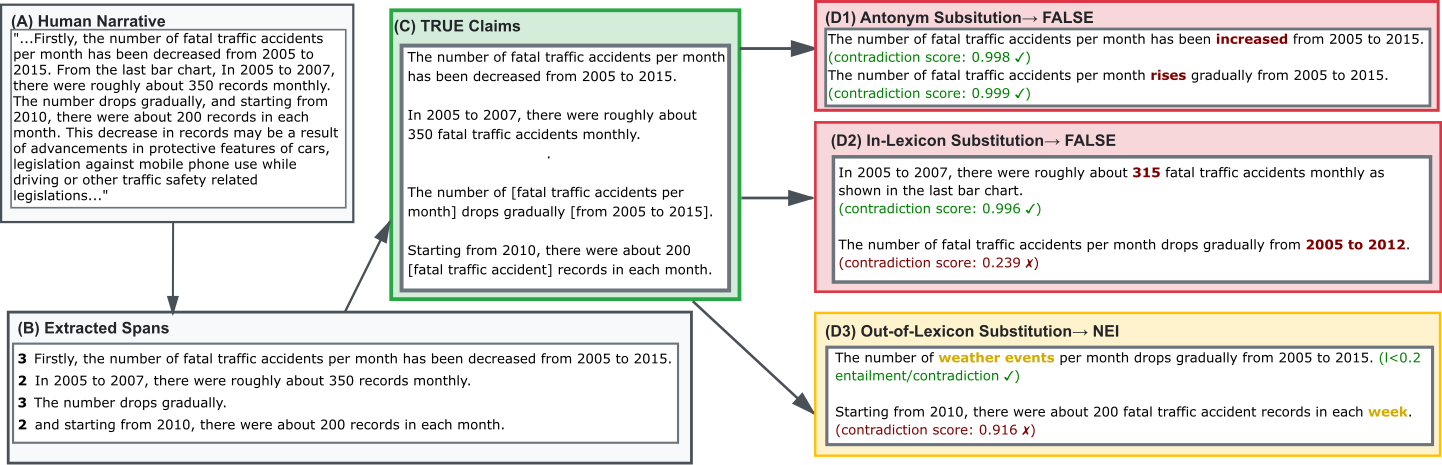 从分析叙事构造真假与不可验证声明
网页环境覆盖悬停、点击、筛选、缩放、平移、选择和链接视图等操作,并包含不同 Vega-Lite 图形类型。任务难点不是 OCR,而是根据声明规划证据获取路径。
#最容易错的是“没有证据”
实验显示,前沿模型在交互核验上仍有明显缺口。典型错误之一,是模型看到一个方向相似的趋势就提前作答,没有继续操作以检查限定条件;另一类错误,是把当前界面没显示的信息当成“假”,而不是“无法验证”。
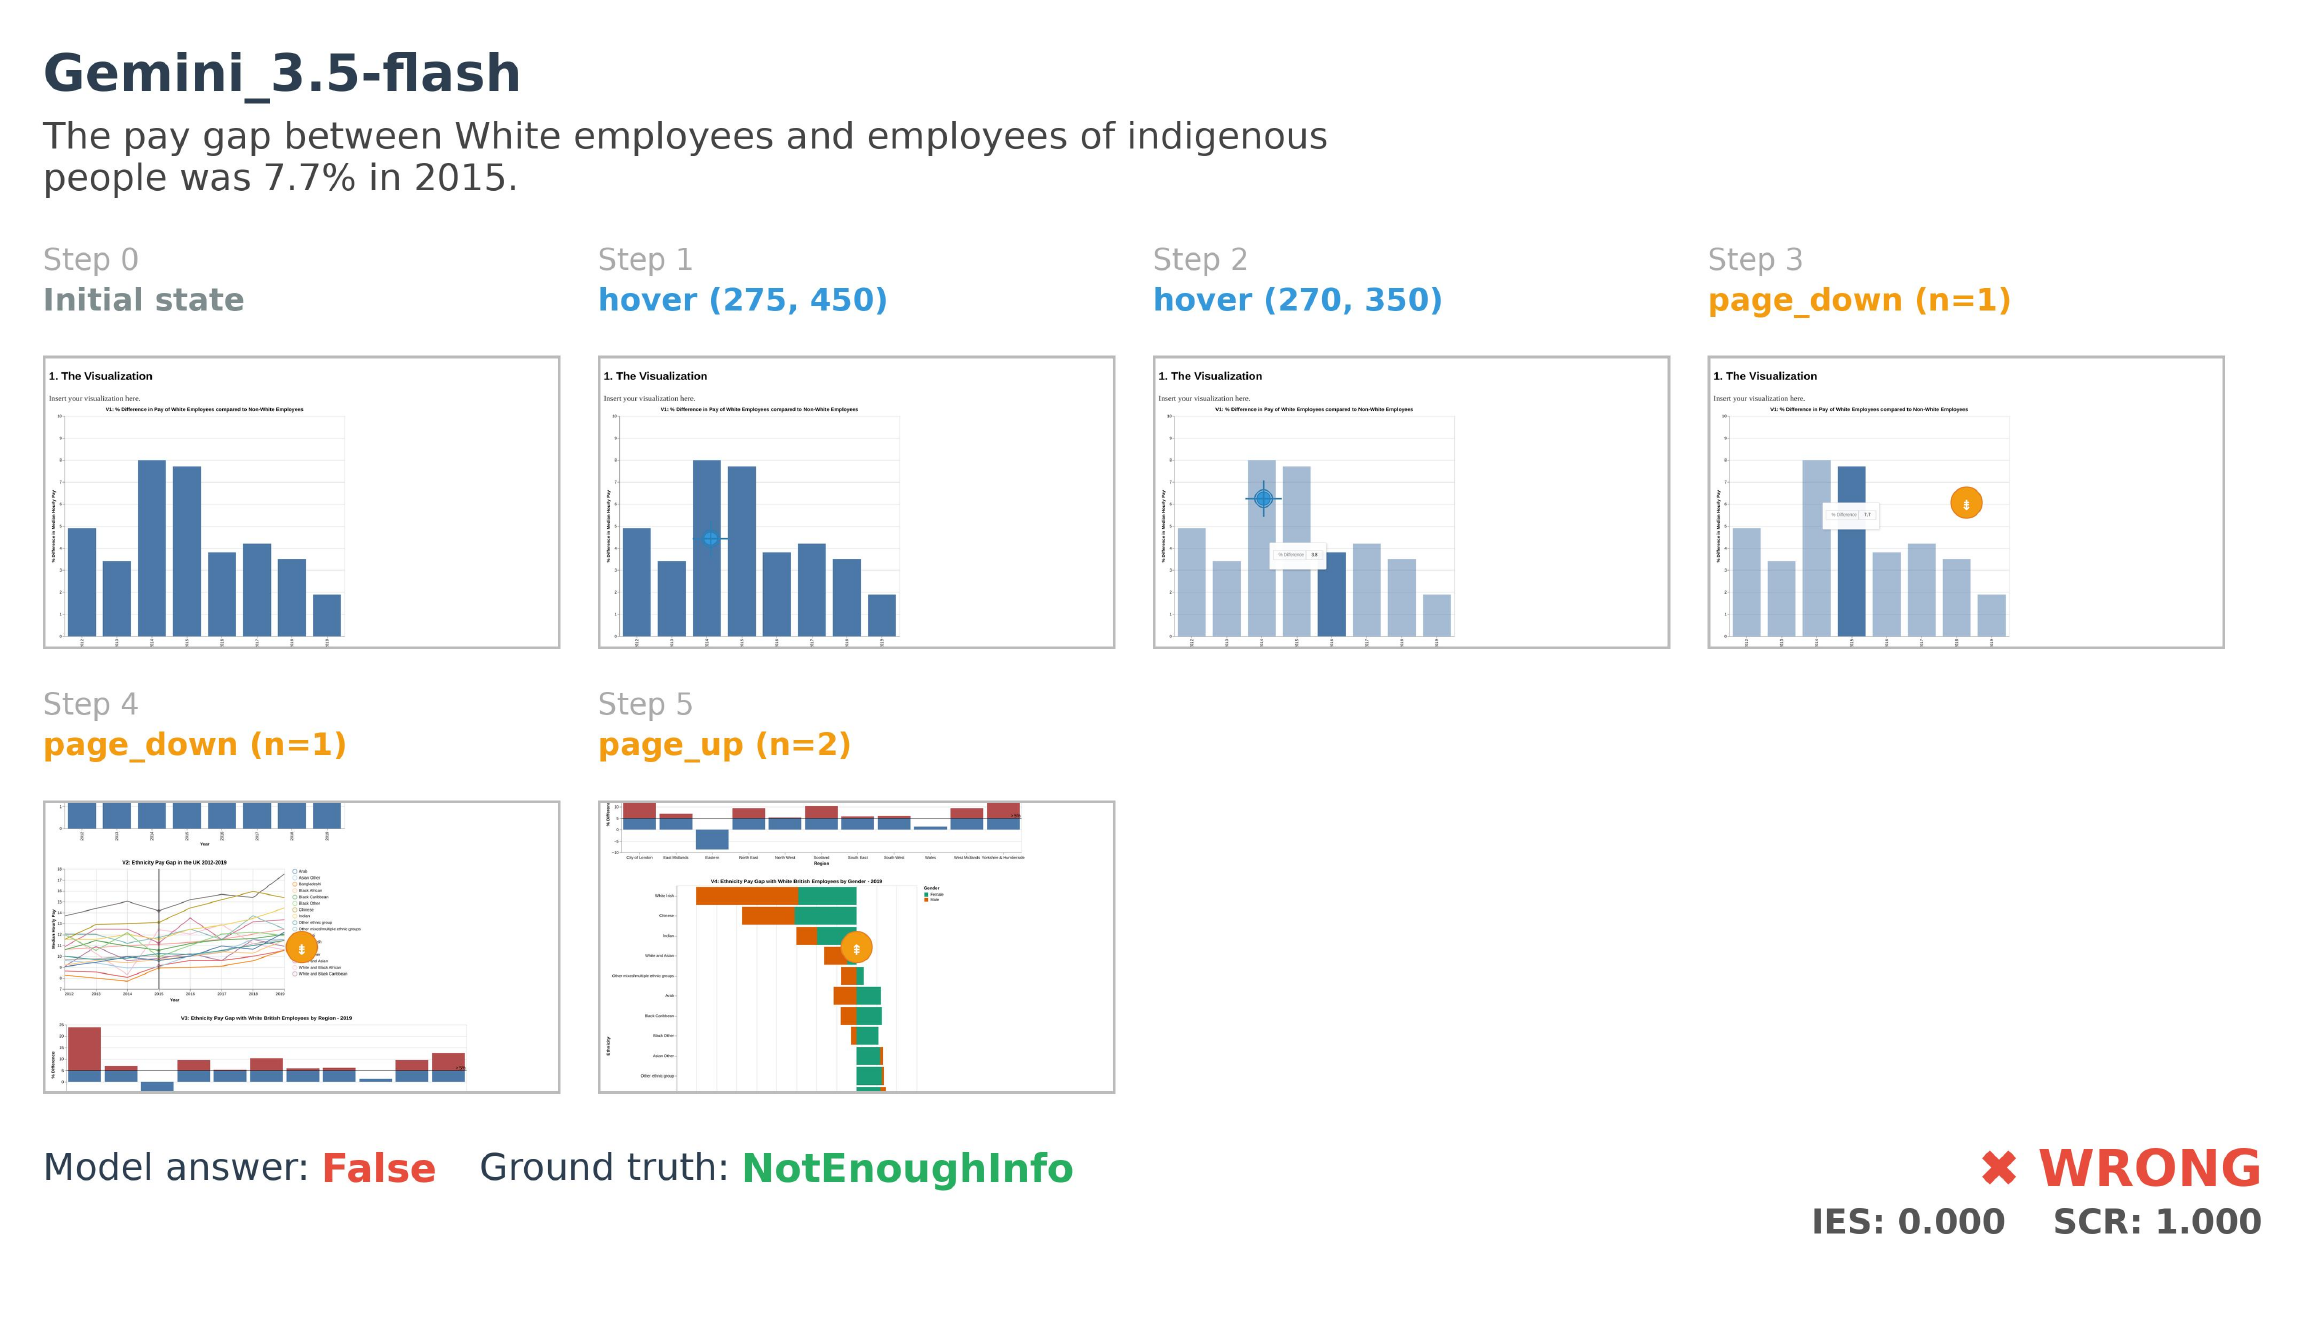 模型把无法验证的声明错误判成假
这一区分对数据 Agent 很关键。数据库里没有证据证明某个结论,不等于数据库证明它错误。一个可靠系统必须跟踪自己访问了哪些视图、哪些筛选条件仍未展开,以及现有证据的覆盖边界。
InSight 也为生成式 UI 和数据产品提出了反向要求:如果希望 Agent 能使用界面,图表就需要稳定的交互语义、可观察的状态和可追踪的证据来源。漂亮的视觉呈现并不足够,界面还必须成为机器能够调查的环境。