LLM-as-a-Judge 已经被广泛用于数据筛选、偏好标注、自动评测和奖励建模。我们知道它会有位置偏差、长度偏差和标准混淆,却很少知道一个 1 到 5 的分数究竟怎样在模型内部形成。
这项入选 EMNLP 2026 主会的研究没有继续比较“裁判与人类有多一致”,而是对 Themis 与 Prometheus 两个开源评测模型做机制分析:错误在哪里被发现,信号怎样传到输出位置,评分又在哪一层真正确定。
#用可控错误追踪评分信号
研究团队构造了八类局部扰动,分属可读性与充分性两条轴。前者包括介词、时态、拼写和顺序错误,后者包括实体、数字、指代和反义或否定错误。每个干净摘要都有配对的损坏版本,错误数量和 Token 位置都被明确记录。
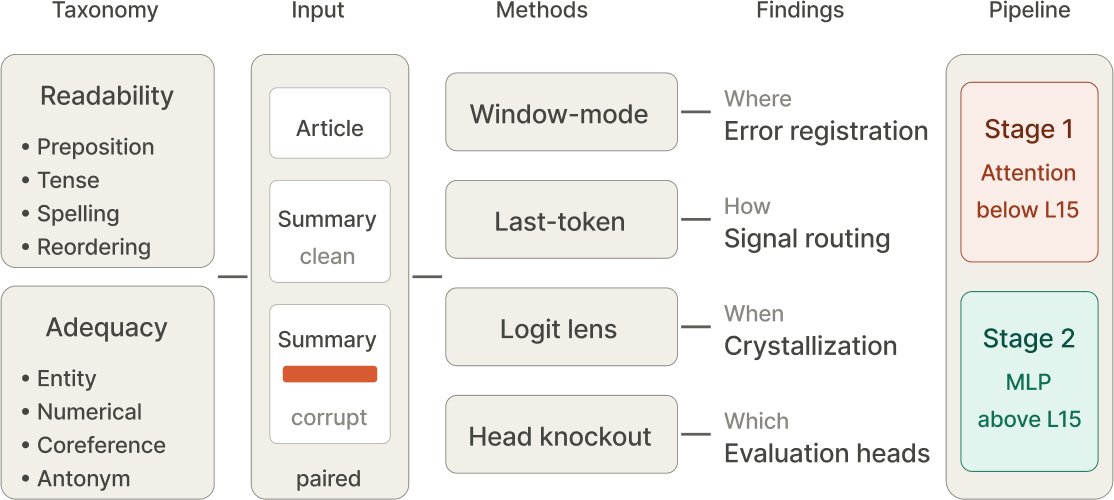 从局部扰动到评分机制的四种分析方法
在此基础上,论文组合使用四类工具:窗口式因果追踪检查错误在输入哪里被处理,末 Token 因果追踪检查评分信号在哪层汇总,Logit Lens 观察 1 到 5 分的概率何时稳定,注意力头消融则定位哪些头在推动或抑制错误评分。
#评分是一条两阶段流水线
两个模型都显示出相似的分工。低于第 15 层时,注意力负责比较局部错误并把信号路由到输入末尾;更高层的 MLP 再整合信号并写入评分。最终决定不是从头到尾平滑形成,而是在很晚的某一层突然结晶:Themis 是第 26 层,Prometheus 是第 25 层。
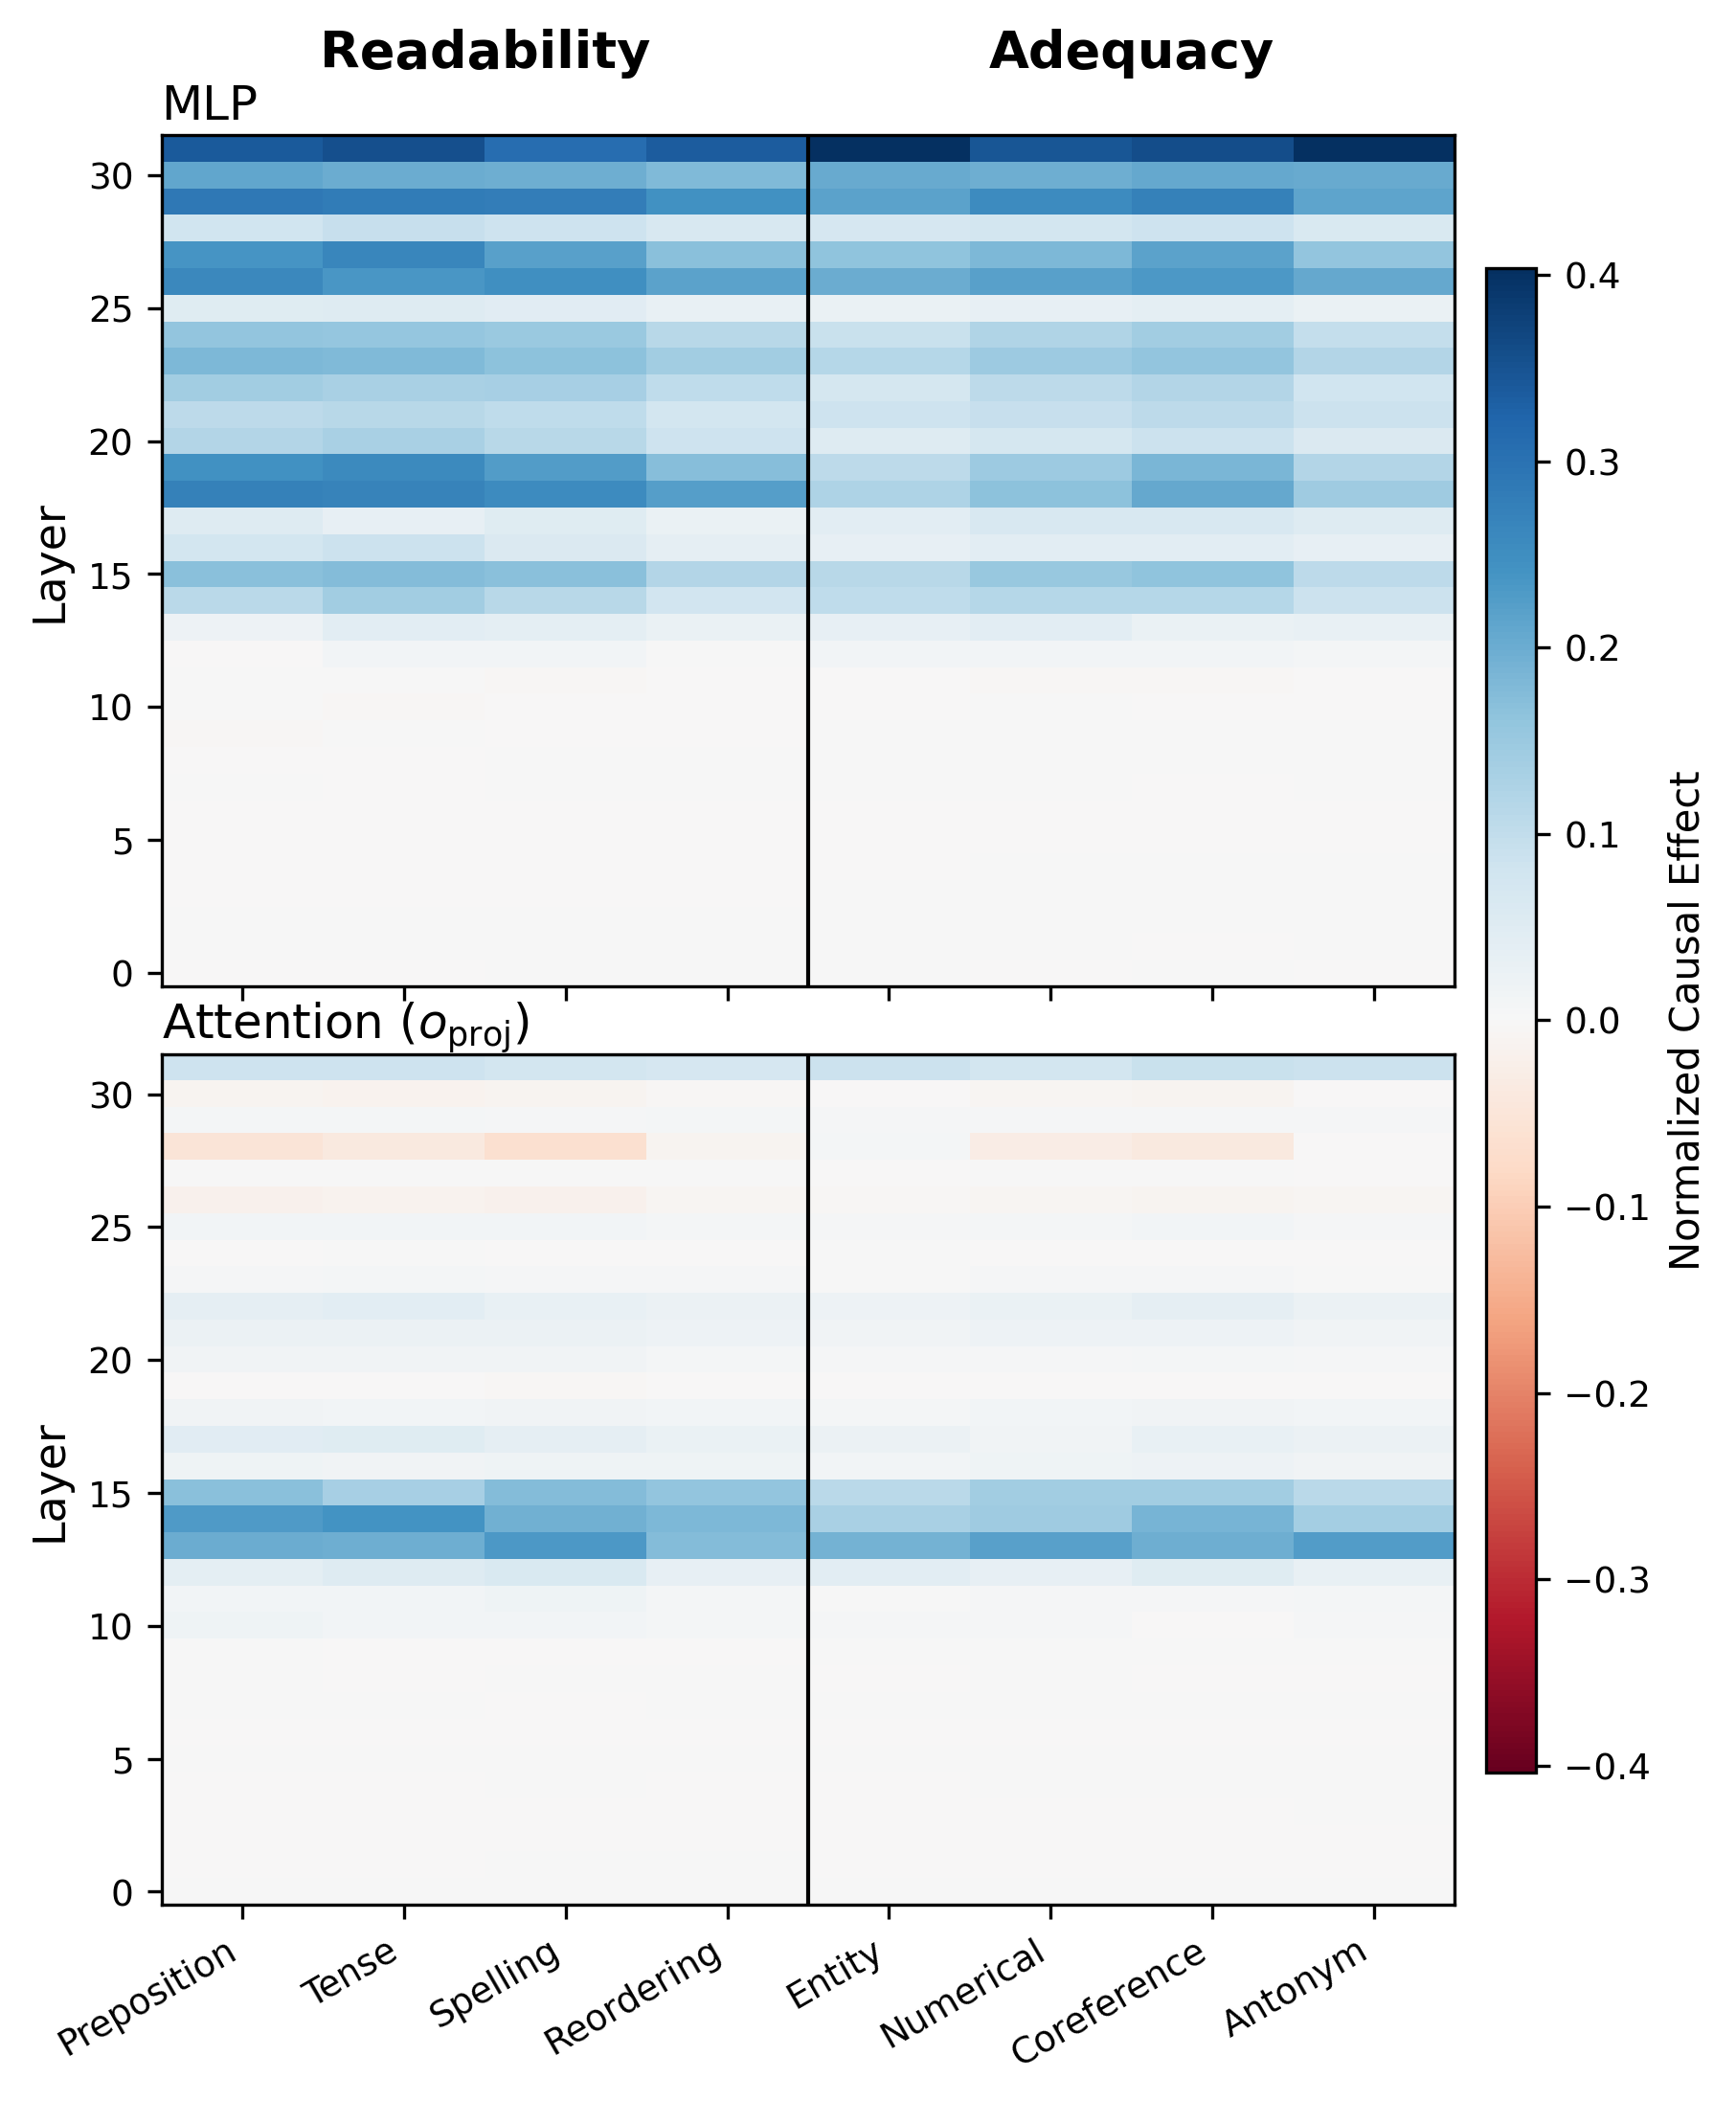 Themis 的末 Token 因果追踪结果
错误类型也会改变早期处理方式。可读性错误往往需要查看相邻语法上下文,注意力影响分布更宽;实体和数字等充分性错误更集中在被替换 Token 附近。这说明裁判并非只把表面统计直接映射成分数,它会依据评价维度采用不同的局部比较方式。
两种裁判在最后写分时又不完全相同。Themis 更像在顶层做一次强提交,Prometheus 则从中后层逐步累积,并在最后一层出现反方向修正。这类差异可能解释为什么两个总体相关性接近的裁判,在特定扰动上仍会表现不同。
#微调没有从零造出裁判回路
团队还对 Themis 的基础模型 Llama-3-8B 运行同样实验。基础模型已经具有注意力路由和晚层结晶结构,说明评分机制借用了 Transformer 原本存在的计算基底。
裁判微调主要安装了两个更局部的变化:压低第 15 层以下、末位置的 MLP 贡献,使“识别与路由”和“汇总与写分”分离得更清楚;同时把结晶层从第 28 层提前到第 26 层。
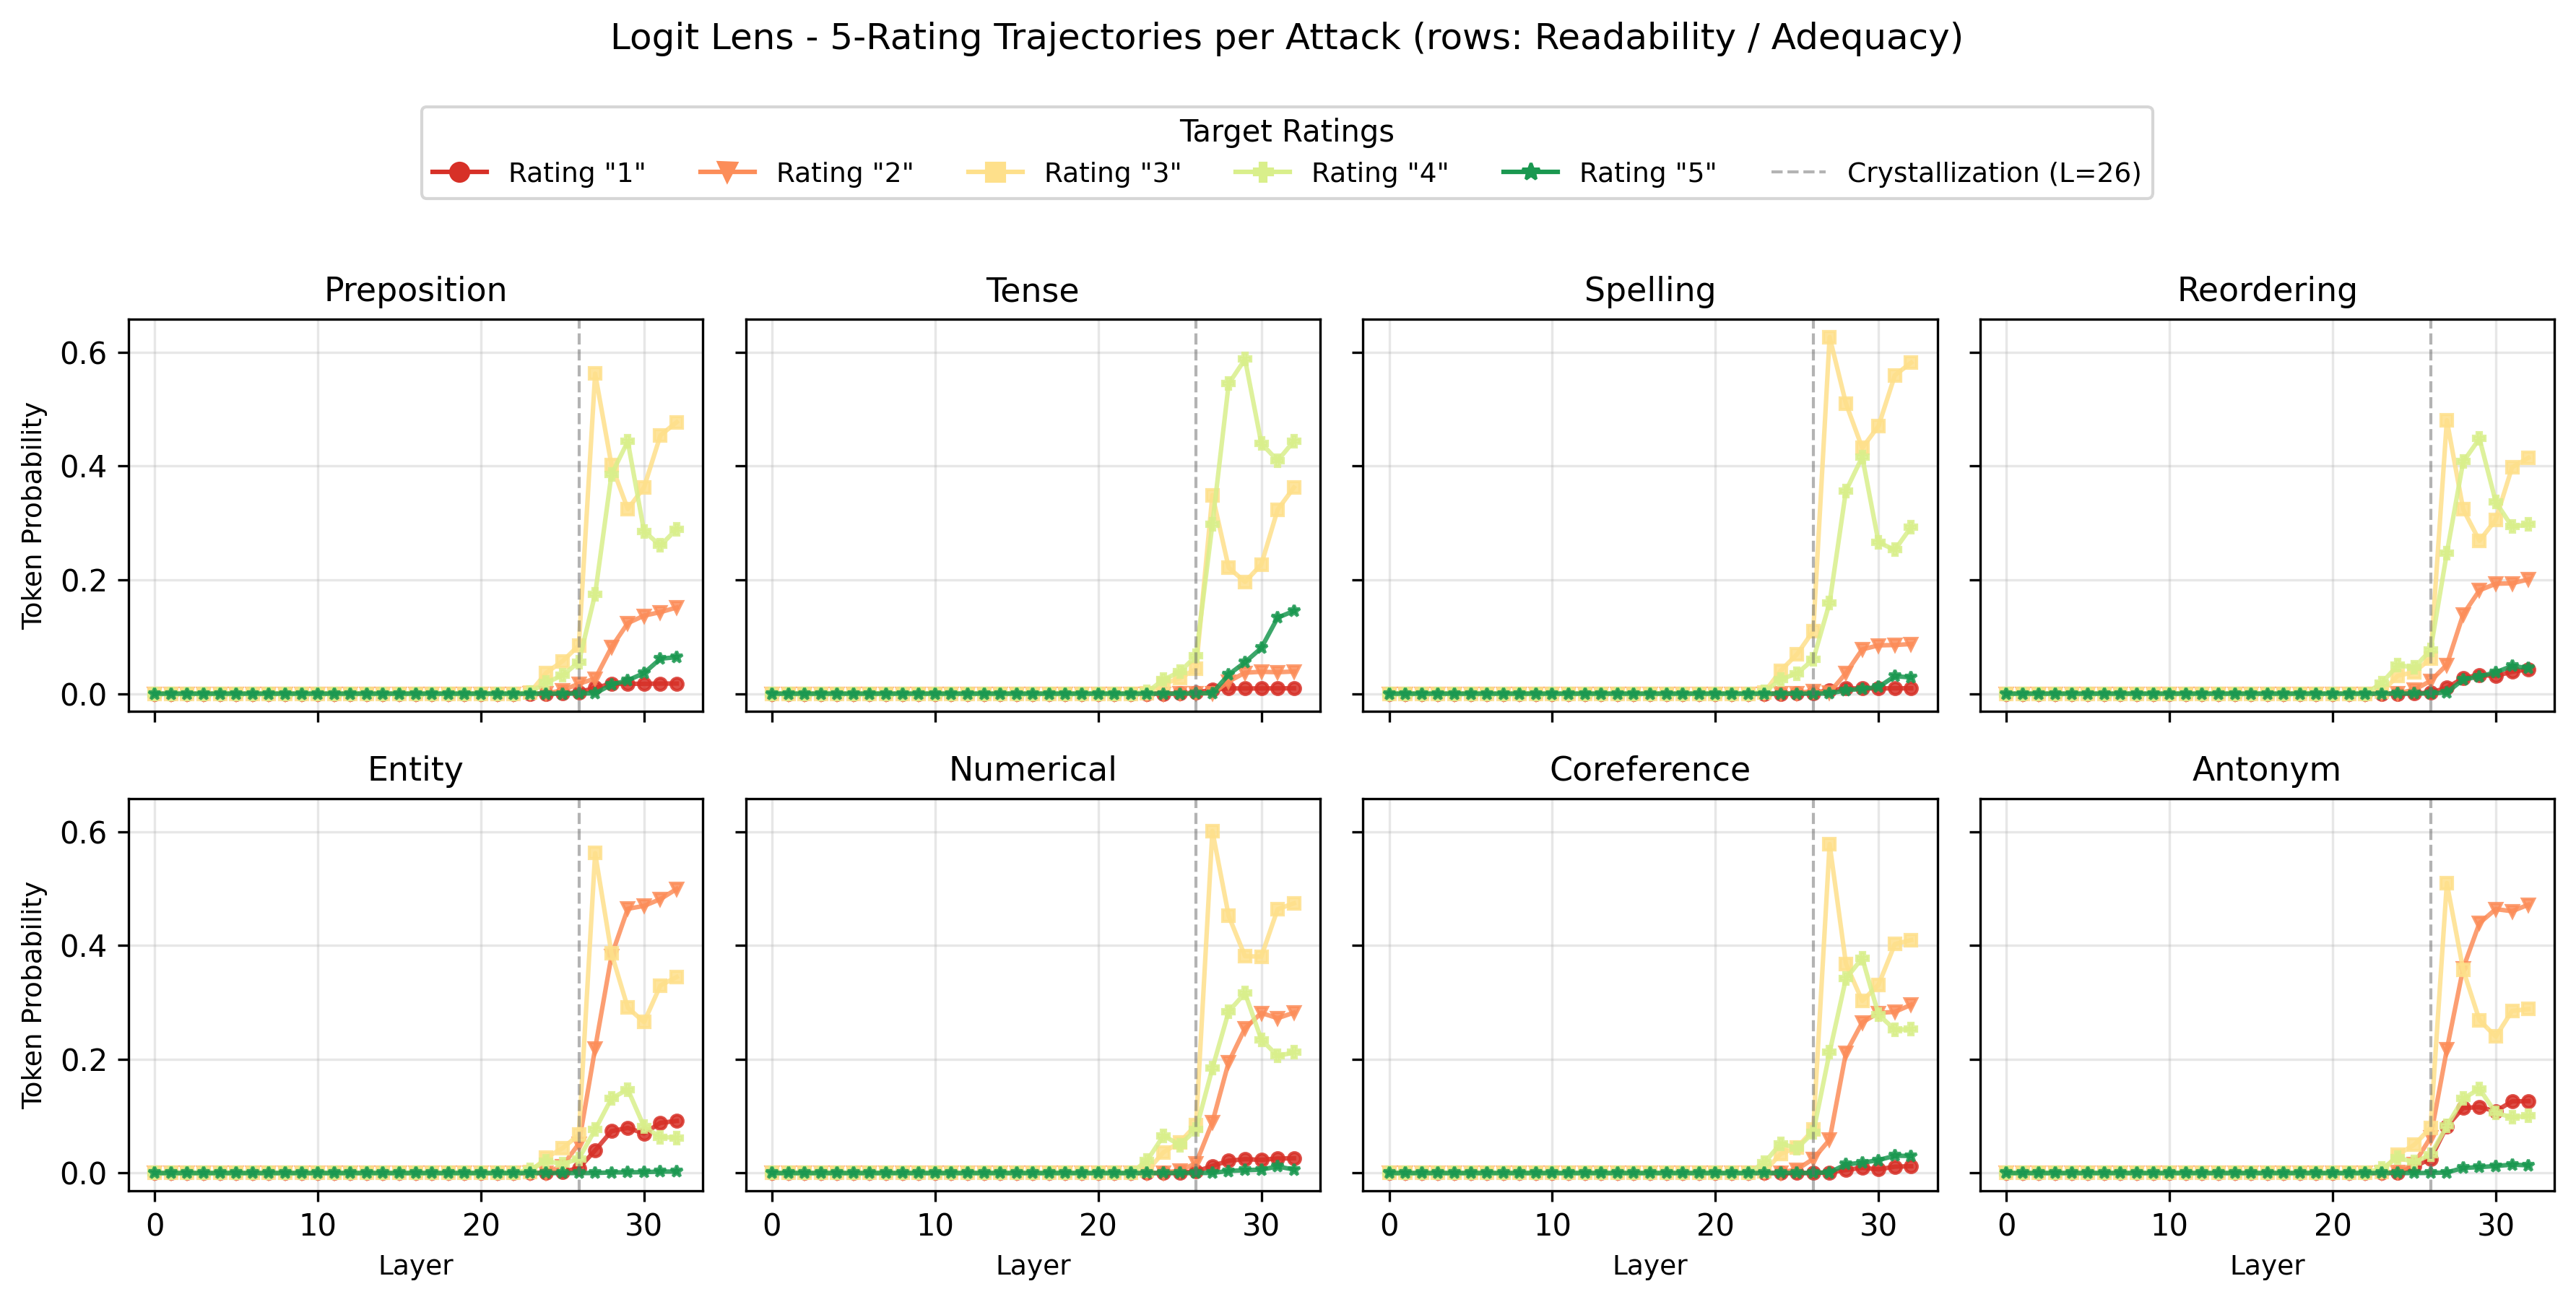 两类裁判模型的评分概率在不同深度成形
这给评测系统带来两个启发。第一,行为一致性不是充分证据,应该用针对性扰动确认裁判是否处理了目标标准。第二,改进裁判未必需要全量重训;如果关键机制集中在少数路由与写分位置,更定向的监督和干预可能更高效。
研究范围仍有限:只分析摘要任务、两种 7B 到 8B 规模模型和八类可定位错误。它没有证明所有裁判都共享同一回路。但它把自动评测向前推进了一步——从观察裁判给了几分,转向检查它为什么能给出这个分数。