大多数 Agent 记忆系统都在回答“过去发生过什么”:保存对话、事实、偏好和经验,需要时再检索。前瞻记忆处理的是另一类问题——现在许下一个承诺,等未来某个条件出现时主动执行。
“等部署完成后通知我”“下次看到该客户来信时附上合同”“如果预算超过阈值就停止任务”都属于前瞻记忆。它要求系统在其他工作继续进行时保存意图、识别触发条件、执行一次或多次,并在完成、取消、过期之间维护生命周期。
#这不是普通的相似度检索
回顾性记忆通常根据当前查询找相似历史片段。延迟意图却不能只靠语义相似:它有明确的触发条件、作用域、时间约束、重复策略和状态变化。如果 Agent 每一轮都把一段自然语言备忘重新交给模型解释,很容易漏触发、重复执行或在条件尚未满足时提前行动。
论文把问题重新定义为“带模式约束的状态跟踪”,并提出 Prospective Intention Store(PIS)。
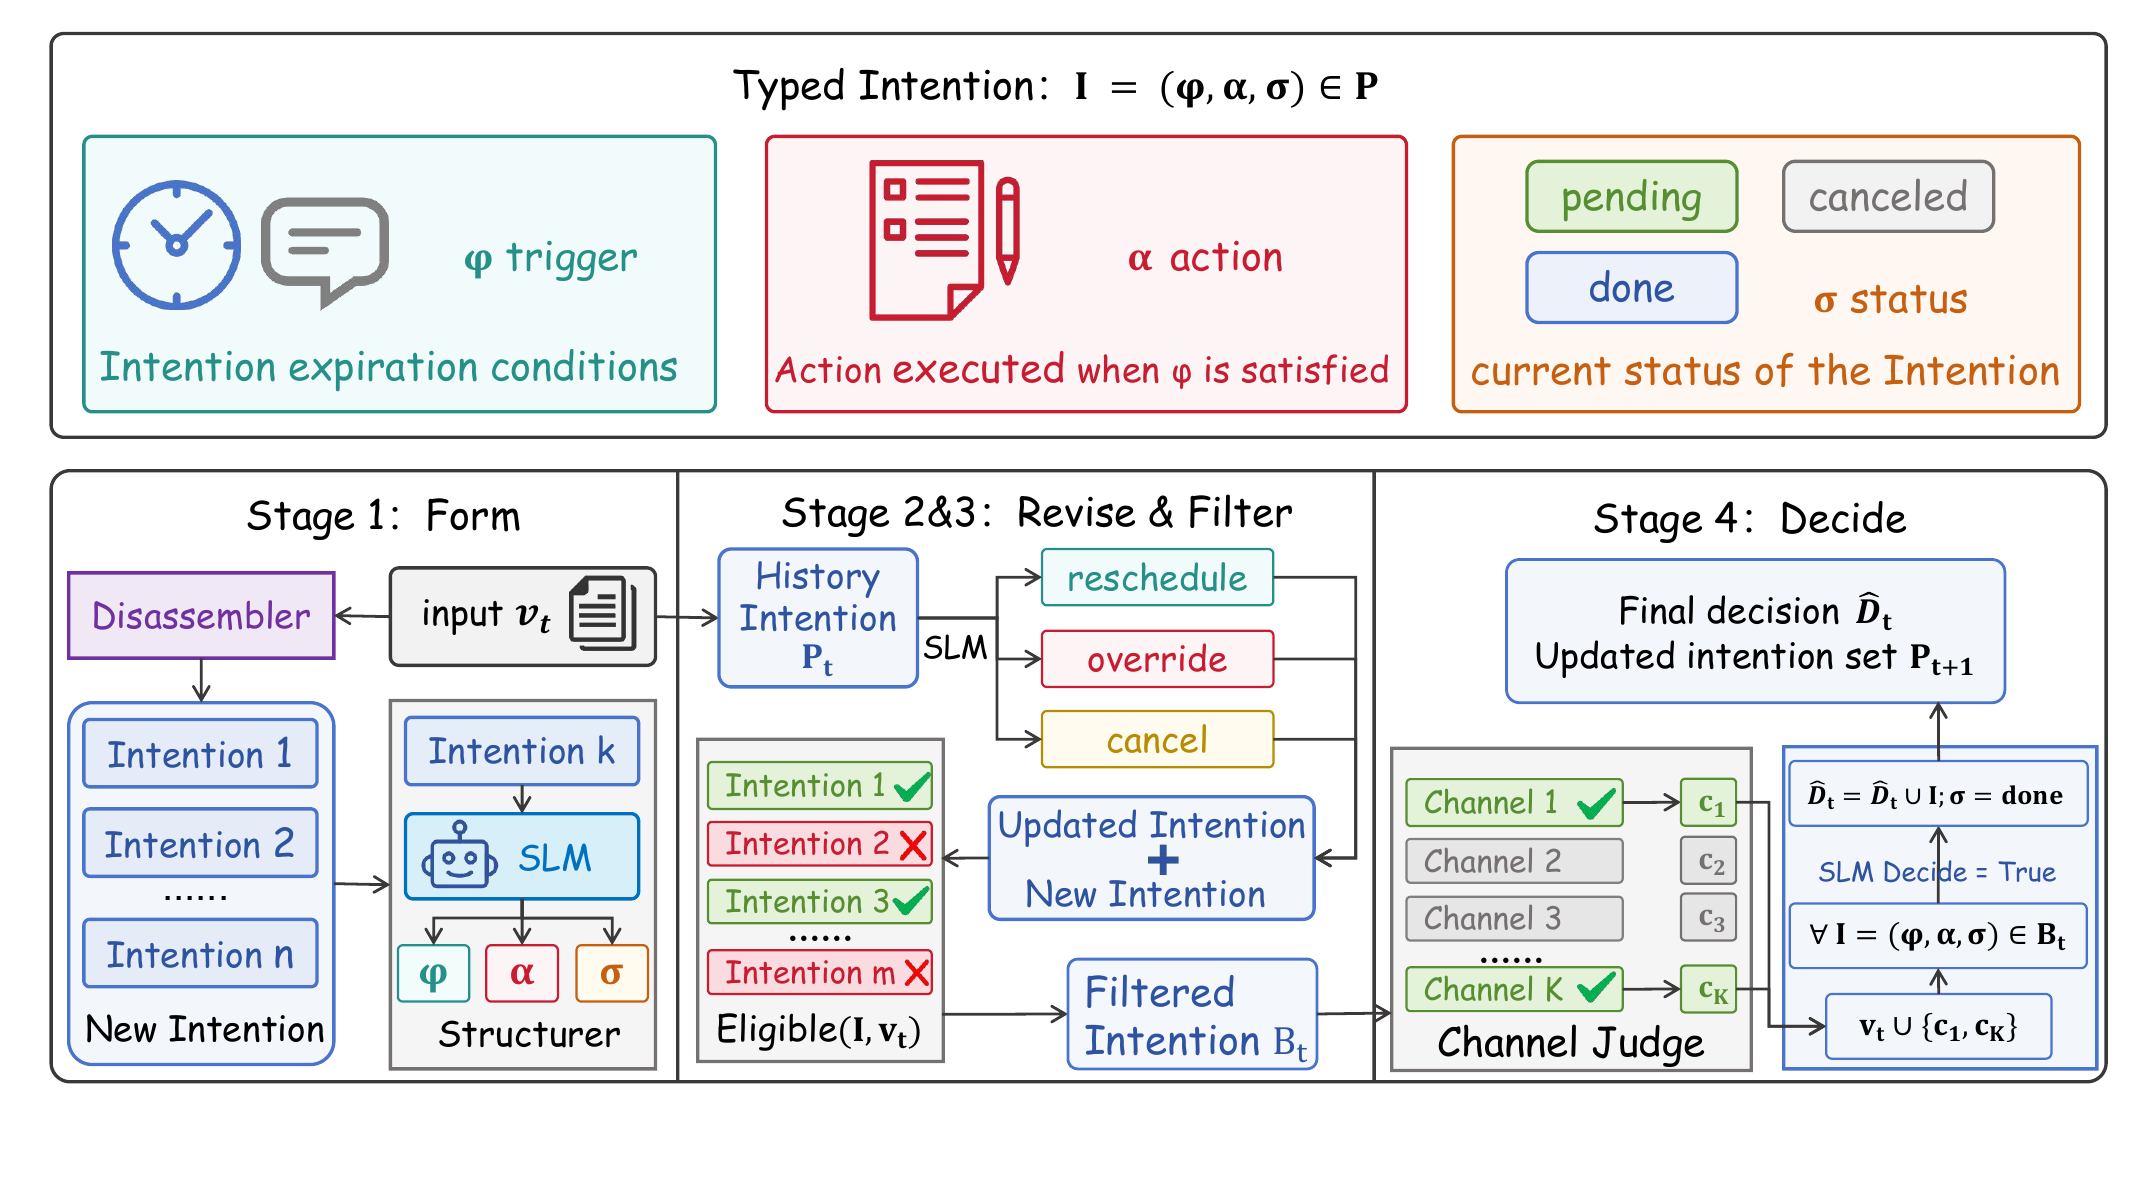 PIS 的类型字段与生命周期
每个延迟意图被拆成结构化字段:要执行的动作、触发条件、作用域、生命周期状态,以及完成和取消规则。确定性的状态迁移由代码负责,模型只处理需要语言理解的局部工作,例如从用户表达中抽取意图,或判断当前事件是否满足语义条件。
#小模型不需要承担全部记忆推理
PM-Bench 上,已有最强 Scaffold 的 Set-F1 为 65.1%。DeepSeek-Chat 配合 PIS 达到 82.9%。更能说明问题的是小模型:Gemma-E2B 没有存储结构时只有 4.2%,使用七种回顾性记忆方案也最多 6.6%,换成 PIS 后达到 66.2%。在另一组设置中,PIS 达到 70.1%,回顾性方法最高为 54.4%。
提升并不来自微调、轨迹蒸馏或更大的选择模型。PIS 是训练外的 Scaffold,把原本要求模型反复推理的部分外置成显式数据结构与确定性生命周期。
这揭示了一个常被忽视的工程原则:不是所有“记忆能力”都应该由模型内部能力承担。只要任务本身具有可枚举状态,就应先把状态、权限和转移规则写清楚,再让模型处理边界模糊的语义判断。
#前瞻记忆需要独立于上下文窗口
长上下文能让模型看见早先承诺,却不能保证它在正确时刻想起、只执行一次,并在取消后不再触发。把意图混在对话历史里,还会随着压缩和上下文裁剪逐渐失真。
一个生产级 Agent 因此至少需要区分三类存储:过去事实的回顾性记忆、当前任务的工作状态,以及面向未来的意图队列。前两者回答“知道什么”和“正在做什么”,第三者回答“条件满足时必须做什么”。PIS 的贡献,是让第三类存储从一句提示变成可检查、可审计的运行时对象。