传统强化学习喜欢把反馈压缩成一个数字:成功是 1,失败是 0,或者由奖励模型给出连续分数。对 Agent 而言,这种信号经常太贫乏。一次任务失败可能来自目标理解错、工具选错、证据不足、执行顺序不当或最终表达不合格,一个标量无法说明是哪一环出了问题。
《The Rise of Verbal Reinforcement Learning》把正在分散发展的方法统一为“语言强化学习”:用自然语言传递意图、偏好与因果结构,并按照反馈在 Agent 生命周期中何时生效、改变什么,划分出三根支柱。
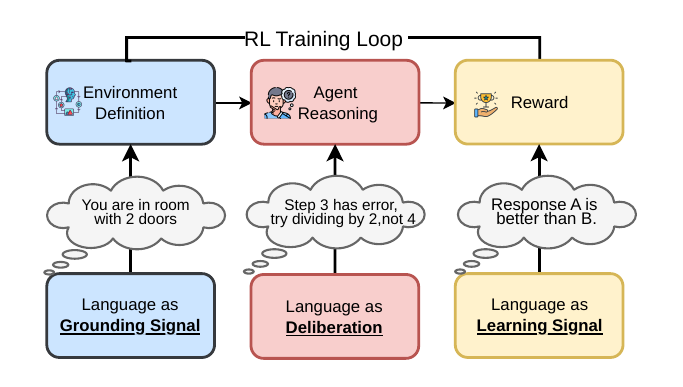 语言在 Agent 生命周期中的三种作用
#第一层:语言定义任务世界
语言首先可以成为 Grounding Signal。它不一定评价一次行为,而是定义目标、状态、动作和奖励。
例如,“整理收件箱”只是宽泛目标;补充“保留所有账单,把会议邀请放入待确认,不要自动发送回复”后,语言就把任务边界、动作权限和结果条件一起写进环境。类似方法还会把文本要求编译成奖励函数或可执行检查,让模糊偏好变成机器可验证的约束。
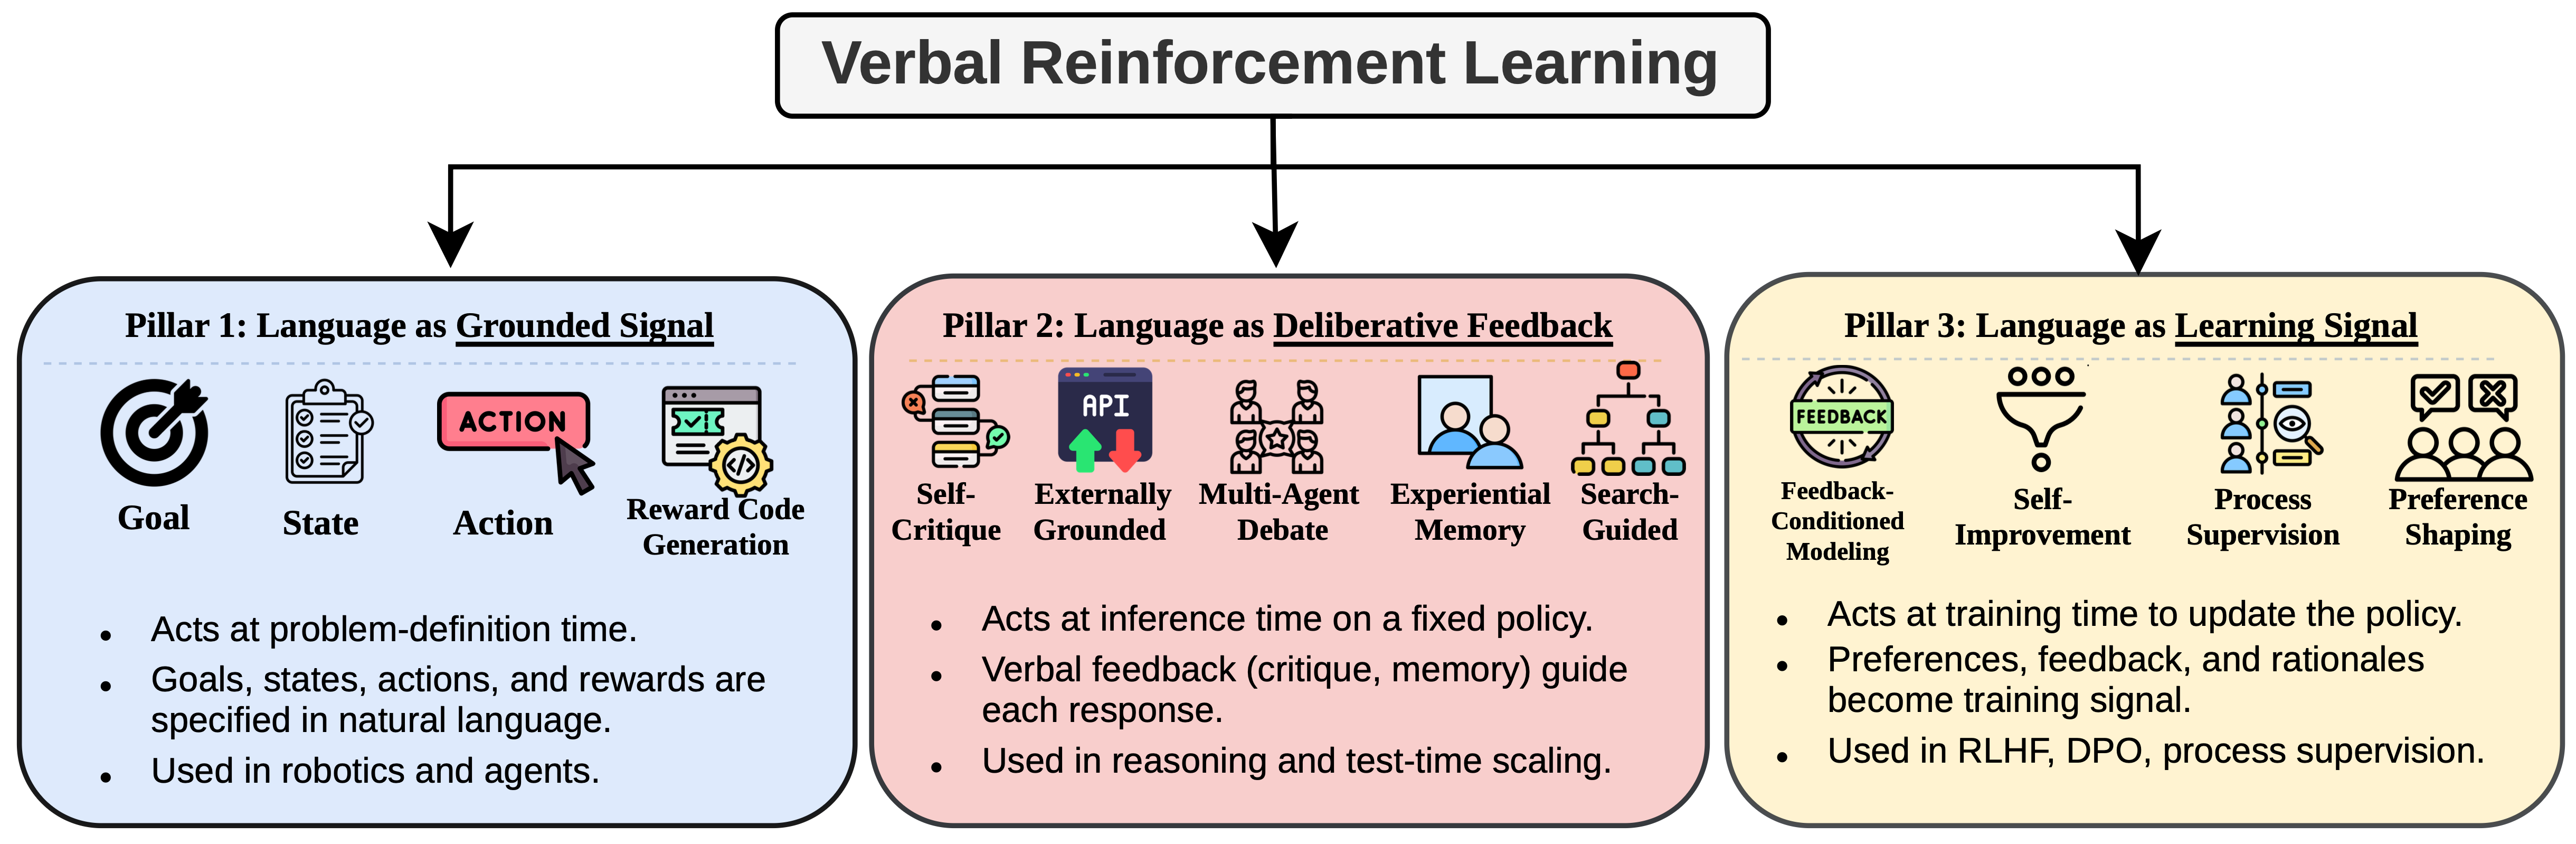 语言如何落到目标、状态、动作与奖励
这一层的关键是把“用户想要什么”与“系统怎样判定完成”连接起来。它能减少奖励函数手工设计,却也会引入歧义、规范漏洞和语言到代码的转换风险。
#第二层:语言在推理时纠偏
第二类是 Deliberative Feedback:不更新参数,只在当前或未来推理中改变行为。常见形态包括自我批评、基于工具结果的外部批评、多模型辩论、把经验写入记忆,以及在候选路径之间搜索和剪枝。
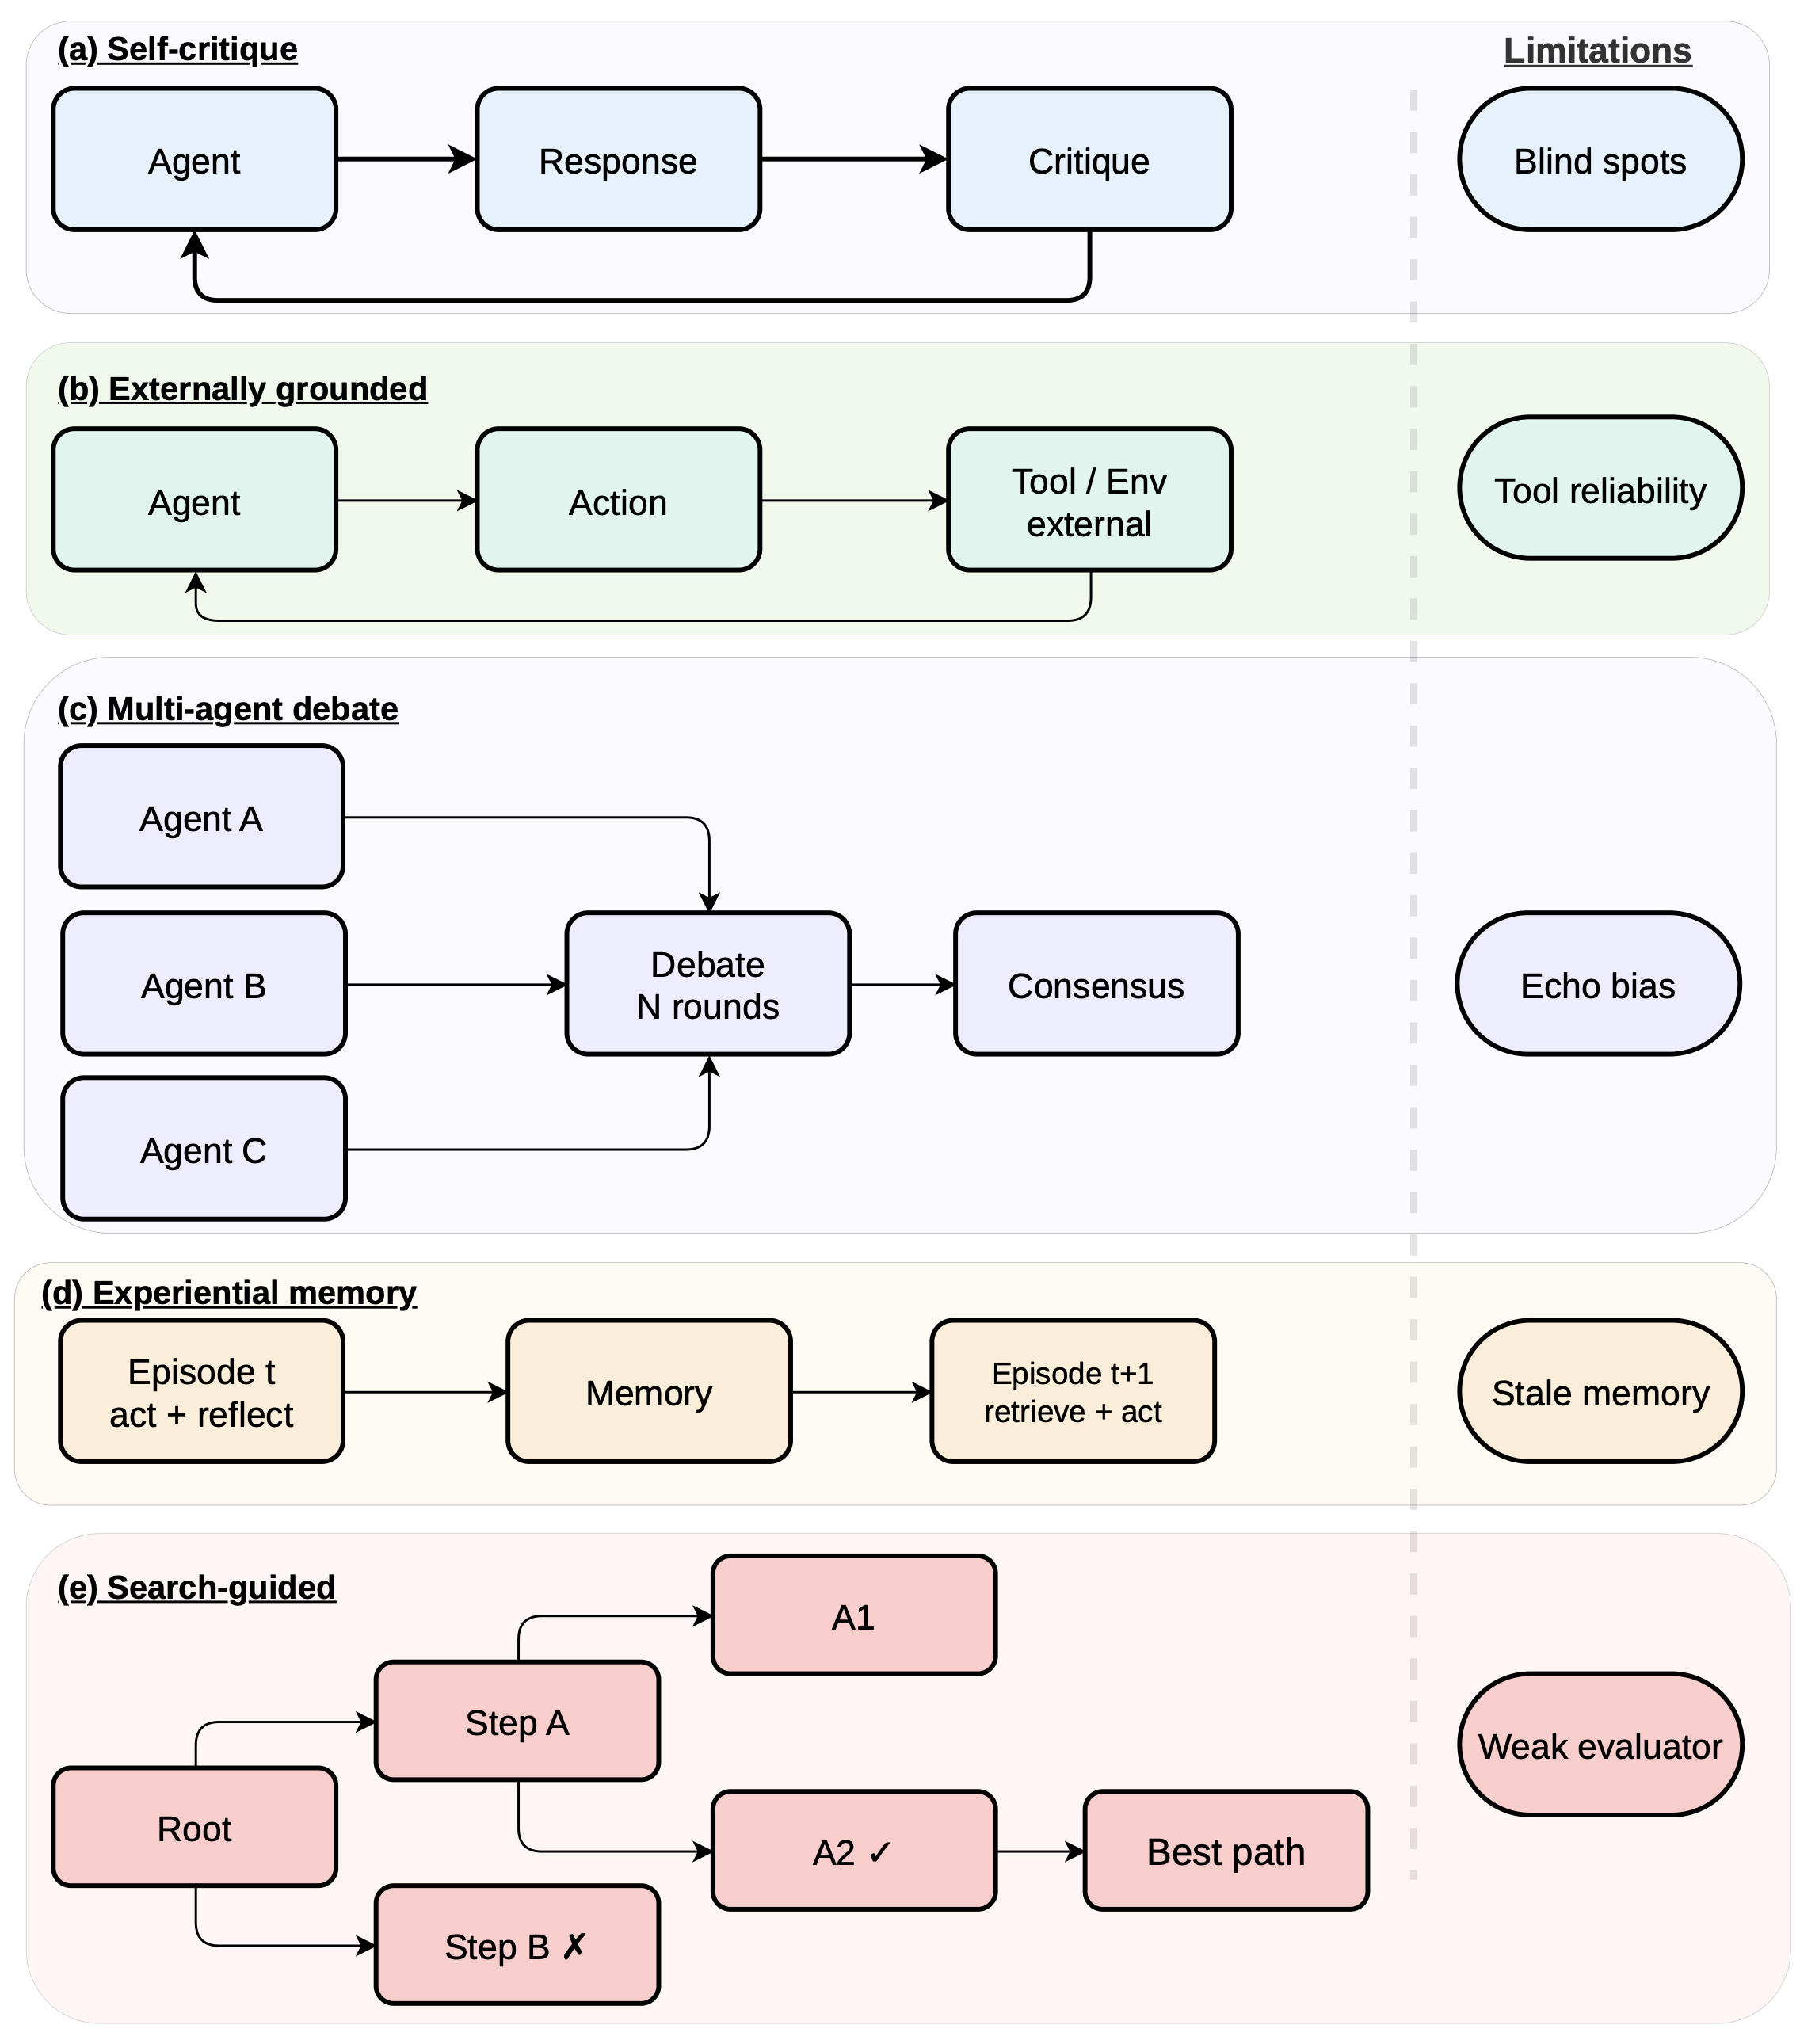 五种推理时语言反馈循环
这些方法的共同点是反馈仍以可读语言存在。与“得分下降 0.2”相比,“你引用的页面只证明了相关性,没有证明因果关系”能够直接指出缺失证据,并指导下一次检索。
但语言反馈并不天然可靠。自我批评可能重复原来的盲点,多模型讨论可能形成共识偏差,长期记忆会把偶然经验固化成错误规则。高质量反馈最好连接外部可验证信号,而不是只让同一个模型换一种口吻评价自己。
#第三层:语言进入训练
第三类是 Learning Signal,反馈最终改变模型参数。不同方法保留语言信息的程度不同:有的直接训练模型生成和遵循完整批评,有的先把语言压缩成偏好对或过程标签,最后才降维成标量奖励。
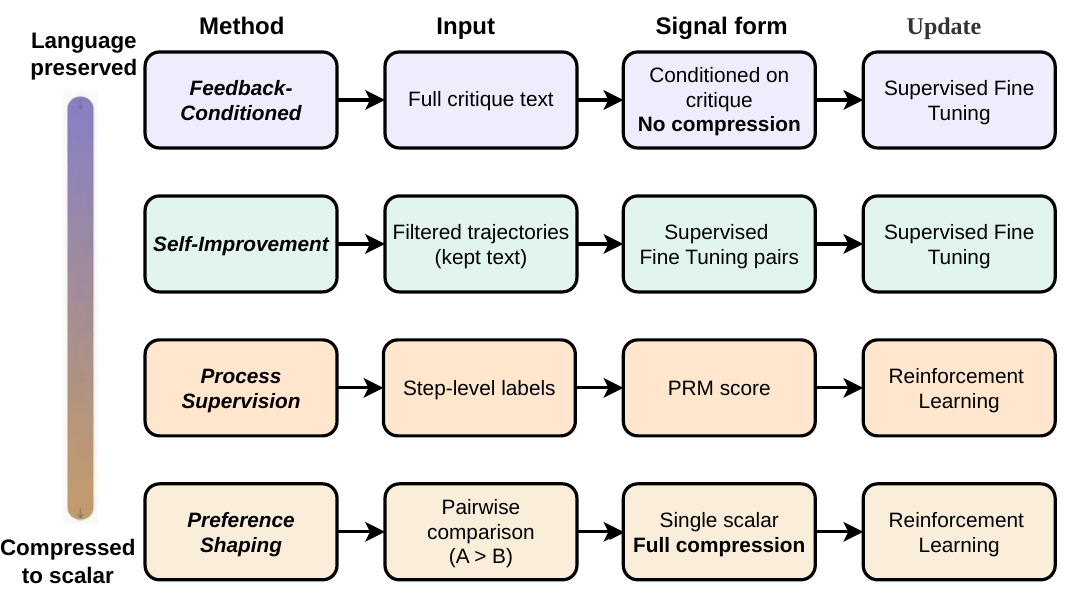 训练时语言反馈从完整文本到标量压缩
信息保留与训练稳定性之间存在张力。完整语言包含原因和改进建议,却难以统一比较;标量方便优化,却丢失反馈结构。一个值得关注的方向,是同时学习“做得好不好”与“为什么”,再让系统根据任务类型选择反馈粒度。
这套分类的价值,在于把提示、反思、记忆、批评模型和强化学习放进同一张生命周期地图。它也提醒产品团队:用户的一句修改意见不应只服务当前对话。只要能可靠归因、过滤噪声并控制更新范围,语言反馈可以依次成为任务规范、运行时纠偏信号和长期学习数据。