代码竞赛是一个苛刻但干净的训练场:问题有明确约束,程序可执行,隐藏测试能给出客观奖励。NVIDIA 团队用这套反馈结构训练 Nemotron 系列,展示了监督微调、强化学习和错误修复循环如何逐步放大算法能力。
#2.2 万道题构成训练底座
数据覆盖约 2.2 万道竞赛题,并对题目质量、难度、解答和测试进行处理。监督微调先建立稳定的算法与代码生成能力,强化学习再利用可执行判题器优化。GenCorrect 则针对失败程序生成、验证并学习修复路径。
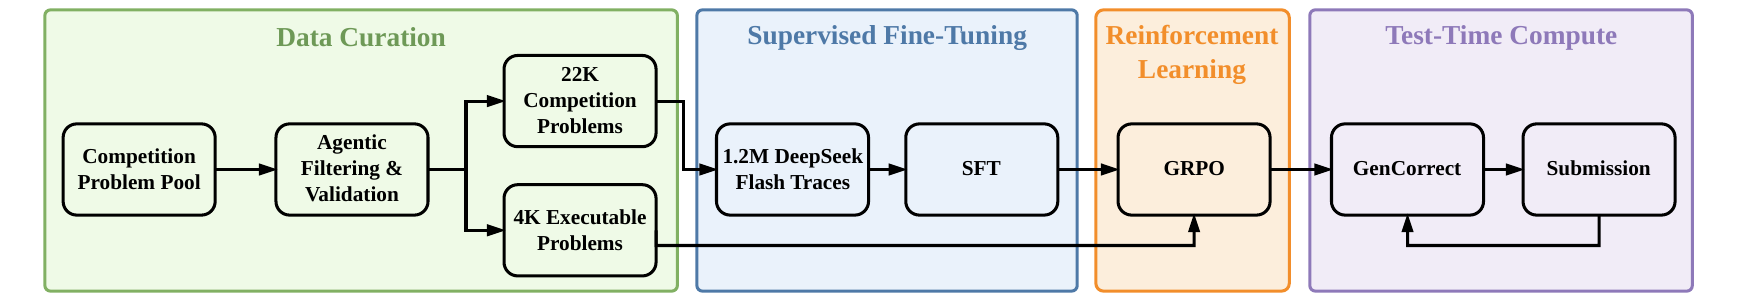 Nemotron 代码推理的后训练流程
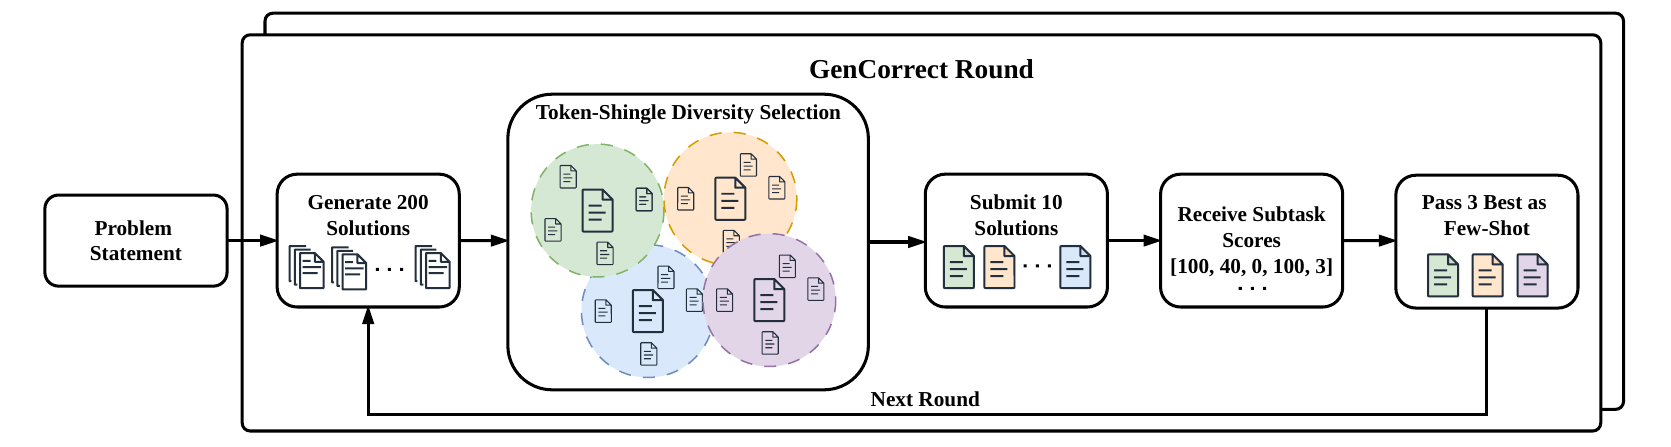 GenCorrect 从错误程序到可验证修复的流程
#每一阶段都留下可测的增量
在 IOI25 设定中,Nano 基础模型约 130 分,完成 SFT 与 RL 后 Score@1 达到 291 分,再经过五轮 GenCorrect 升至 468 分;Ultra 经过五轮 GenCorrect 达到 502 分。分阶段曲线说明提升并非只来自更大模型,而来自训练数据、可执行奖励与测试时修正的组合。
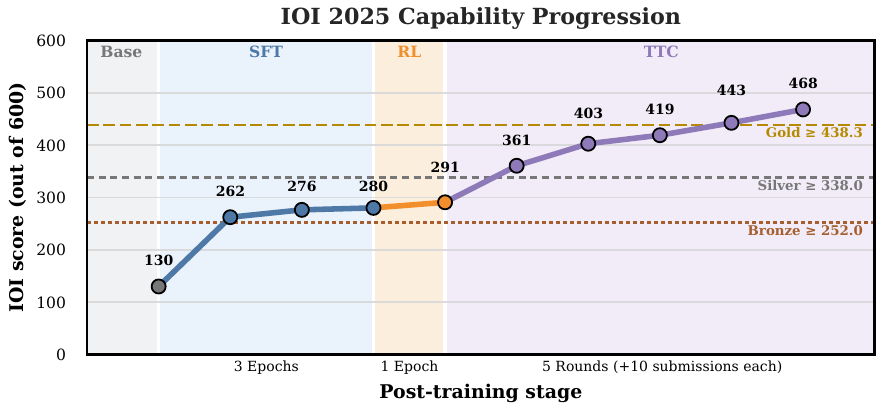 基础模型、监督微调与强化学习后的能力 progression
更强的证据来自前瞻评测:在模型训练后才出现的 IOI26 题目上,系统取得 535.4/600,而人类最高分为 498.27。 因为赛题没有进入训练数据,这比在历史题库上重放更能检验泛化。
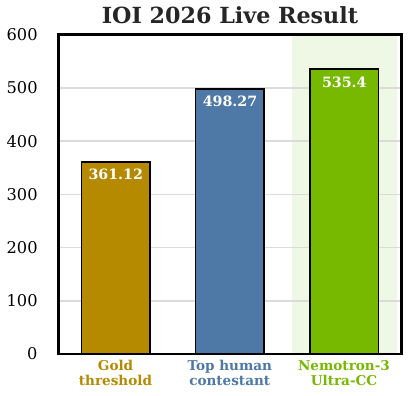 Nemotron 与人类选手在 IOI26 上的分数对比
#高分不等于完整 Coding Agent
竞赛任务缺少真实仓库中的需求歧义、依赖管理、多人协作和长期维护。它更准确地测量算法设计、实现与测试驱动修复。把结果外推到软件工程时,仍要通过仓库级基准和生产轨迹验证。
不过,这项研究证明了一个强趋势:当任务有可靠验证器,模型可以通过大量可执行反馈持续自我纠错。未来 Coding Agent 的提升,很大一部分将来自更好的环境与奖励设计,而不只是更大的预训练模型。