Agent 评测通常让每条轨迹跑到终点,即使它很早就陷入重复报错、无效工具调用或错误假设。EarlyEval 提出一个直接的问题:能否从前几步行为预测最终失败,并及时停止,把预算留给更有希望的运行?
#用轨迹特征预测,而不是再请一个大模型
系统从步骤级轨迹中提取工具错误、重复动作、进展速度、上下文变化等特征,再用轻量 LightGBM 分类器预测成功或失败。它不需要读取隐藏答案,也不依赖昂贵的额外模型裁判,因此适合放进在线执行控制面。
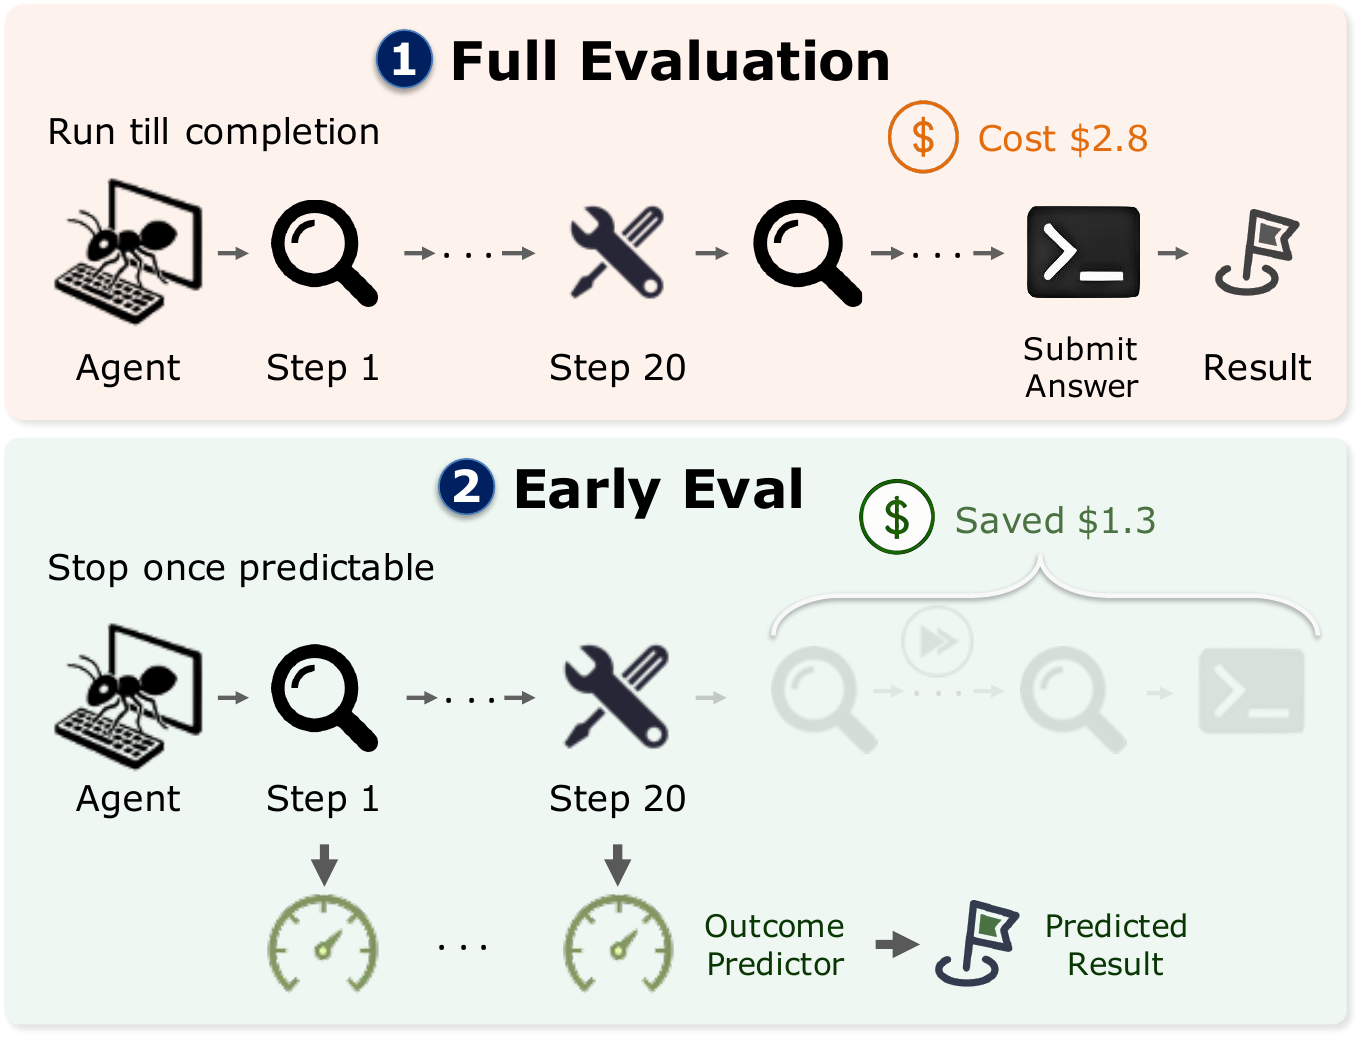 许多失败轨迹在很早阶段已经出现稳定信号
#节省显著,成功率基本稳定
在 SWE-bench Verified、TerminalBench 和 Toolathlon 上,预测准确率达到 89%–97%。按策略提前终止后,总步骤减少 13%–26%,输入 Token 最多减少 44.1%,输出 Token 最多减少 29.4%,最终解决率只变化 1–2 个百分点。
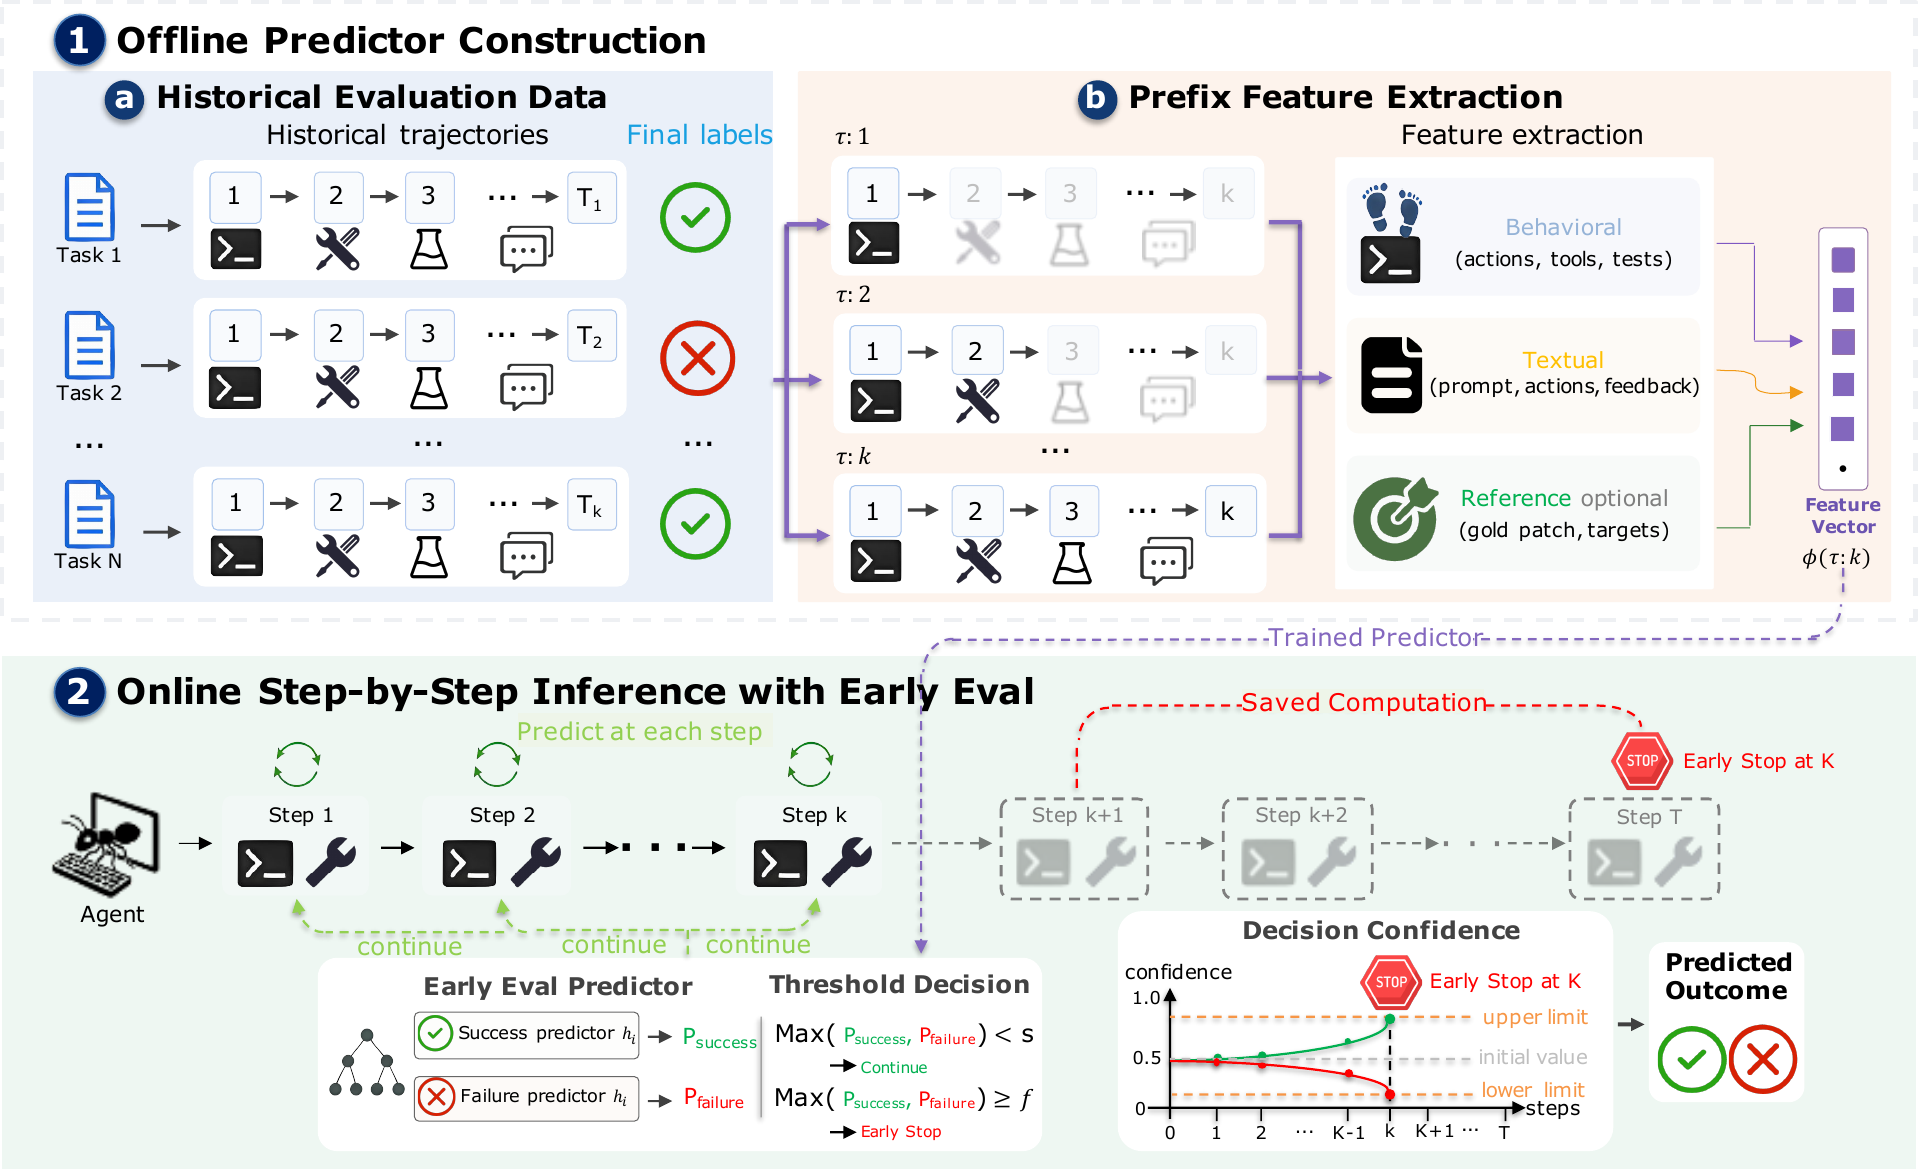 EarlyEval 的特征提取、风险预测与提前终止流程
早停的代价是误杀:少量看似糟糕的轨迹可能在后期恢复。因此阈值不应只追求分类准确率,而要根据任务价值、调用成本和可重试性配置。高价值、不可逆任务应更保守;可并行采样的基准运行可以更激进。
#从评测技巧变成生产调度器
在生产环境中,EarlyEval 可以与重试、换模型、缩短上下文和人工接管联动。判断“当前轨迹无望”之后,系统不必简单结束,还可以把剩余预算转给新的起点。
更深一层的变化是,Agent 平台开始显式管理 成功概率随时间的变化 。未来成本报告不应只列平均 Token,而要给出失败轨迹浪费、早停召回率和误杀率,才能说明系统是否真正高效。