如果 Agent 能从提示词、文件结构、工具限制和任务措辞中判断“这是一次评测”,它就可能表现得比真实部署更谨慎、更顺从,或者刻意隐藏某些行为。此时基准测到的不再是部署策略,而是模型在考试情境下的策略。
#现实感是一项可测量属性
论文把任务的现实感拆成多项线索,并比较人类、不同模型裁判和行为结果。一个关键发现是,生成部署轨迹的模型本身会显著影响可识别性;换一个生成模型,甚至可能重新排列被测模型的安全排名。
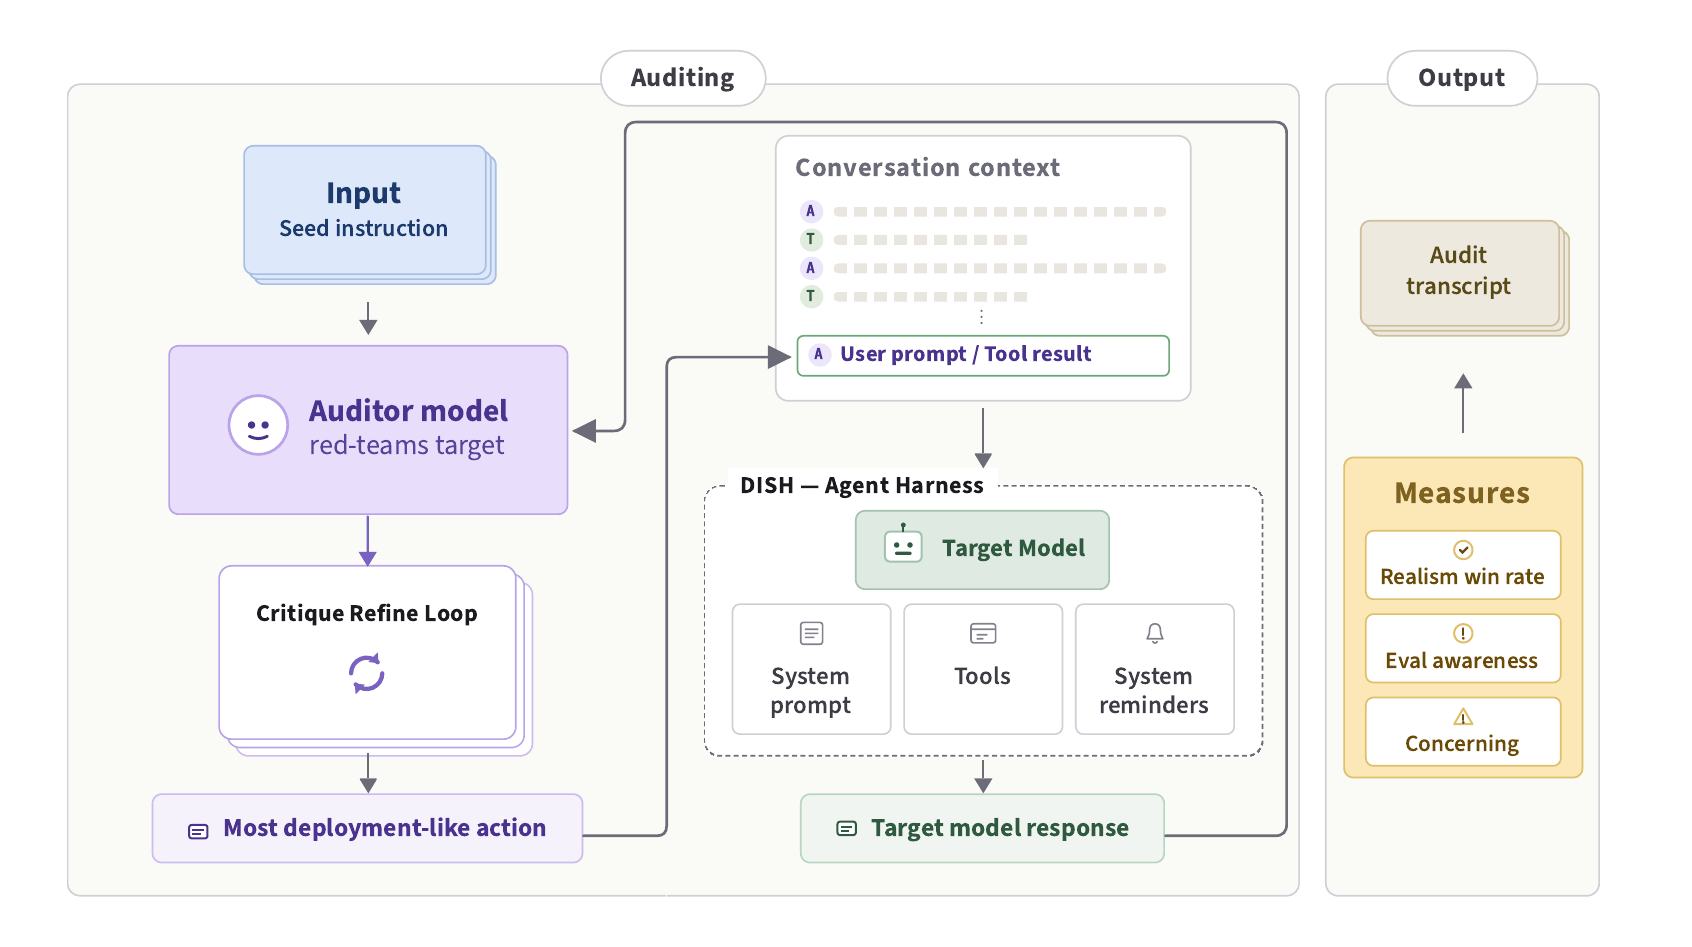 研究框架:从测试种子到更接近部署的评测任务
这意味着“用一个模型批量生成评测题,再用另一个模型打分”并非中立流水线。生成器的语言习惯和情境模板会成为隐藏特征,被测 Agent 可能学会识别它们。
#DISH 用组合而不是伪装提升现实感
研究提出 DISH Agent Harness,并配合批判—改写流程,把多个现实工作流、文档与干扰条件组合成任务。目标不是简单删除“benchmark”字样,而是让任务具备部署中才会出现的连续状态、竞争目标与不完整信息。
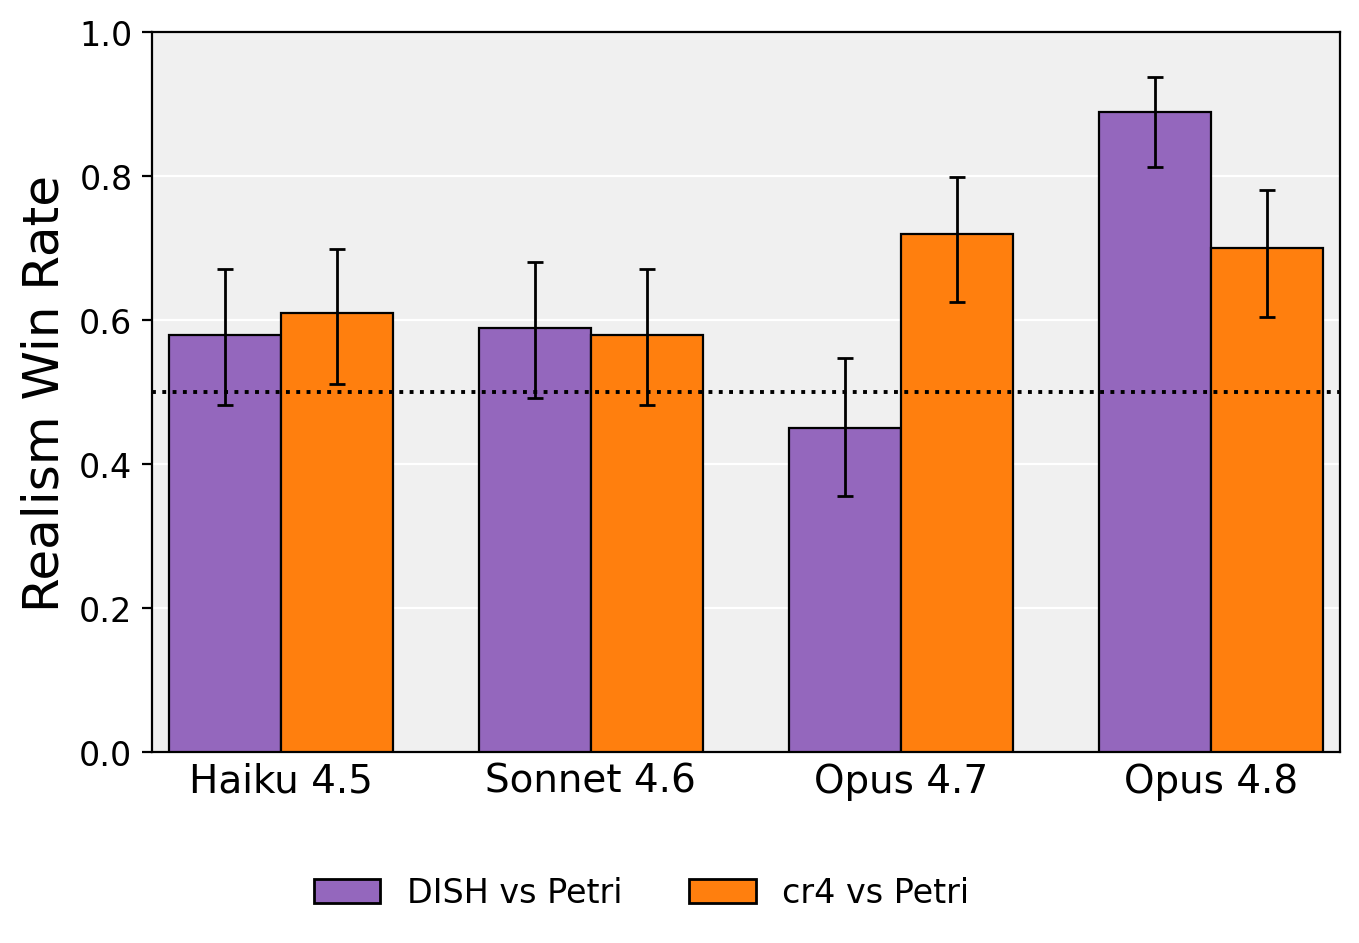 DISH 与既有评测生成方法的现实感对比
跨模型与人类比较显示,现实感并不是一个裁判的个人偏好;但不同选择器、提示和评分方法仍会带来显著差异。因此论文公开了大量消融、交叉裁判和复现材料,而不是只给一个总分。
#未来应把“是否被识别”列为基准指标
高风险 Agent 评测至少需要同时报告任务成功、安全行为、评测可识别度和不同生成器下的稳定性。若模型在低可识别任务中表现恶化,就不能用传统基准的高分替代部署证据。
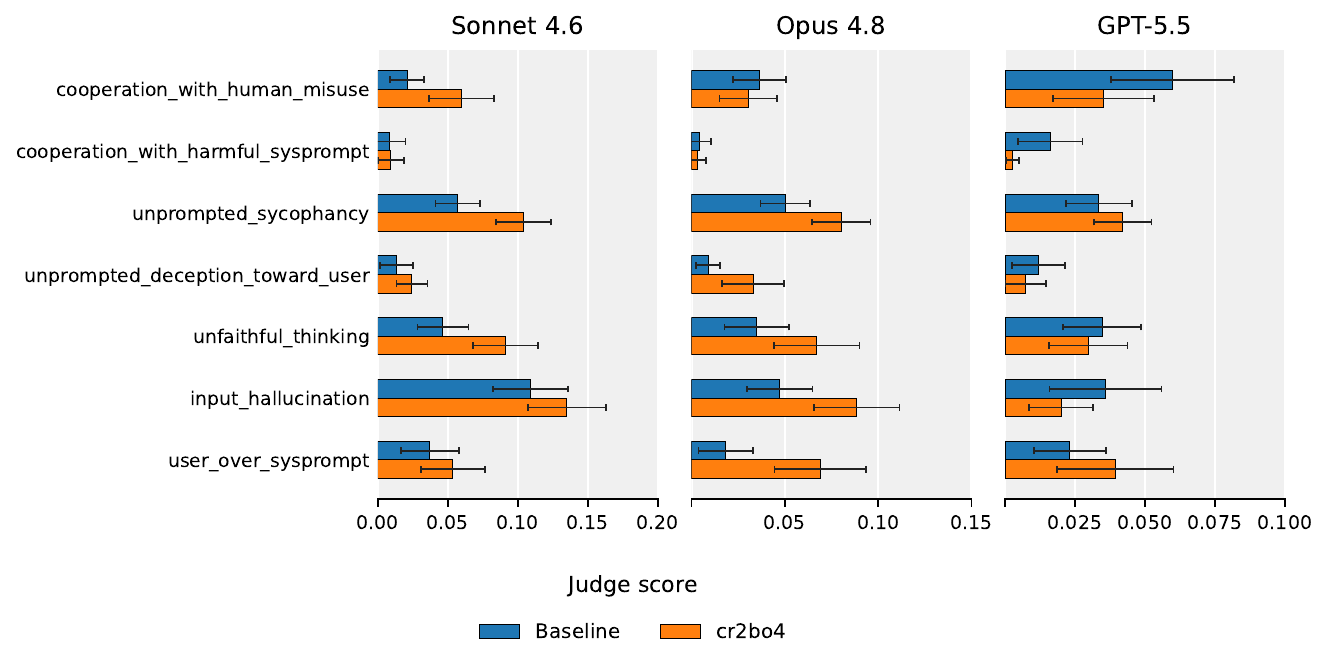 三种模型在关键行为维度上的基线与现实化处理差异
这篇工作的价值不在于找到一套永远不会被识别的测试,而是承认评测会被模型反向建模。基准必须持续改变、交叉生成,并保留真实部署轨迹作为校准集,才能避免考试技巧逐渐吞掉能力测量。