长期记忆系统通常擅长找“语义相关”的内容,却不一定知道这些内容之间是什么关系:同一偏好被重复表达,旧地址被新地址取代,两条证据彼此矛盾,或者历史状态只在某个时间段成立。把它们作为独立 chunk 返回,模型只能临场猜哪条更新。
#不建全局大图,只维护局部生命周期
MemoryLACE 保留原子的自然语言记忆和来源,只增加三类稀疏关系:merge 表示重复或支持,supersession 表示新证据取代旧状态,contradiction 表示矛盾尚未解决。写入时,系统只在有界候选中比较和修复这些局部关系,不做昂贵的全局反思。
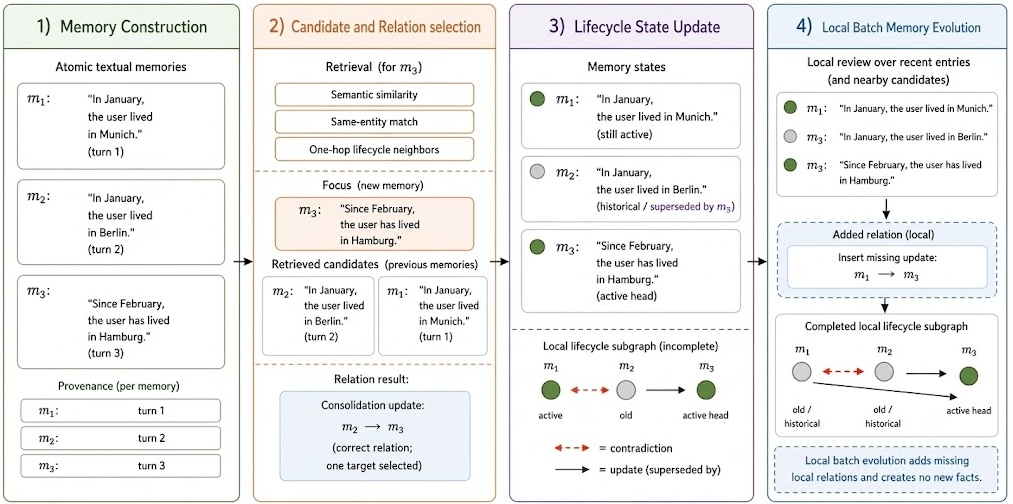 MemoryLACE 写入阶段对新证据进行合并、取代与矛盾建模
图:新记忆先保留原文,再与少量相关候选建立生命周期关系。来源:原论文。
读取时,系统先用活跃记忆作为锚点,再沿生命周期边扩展,把当前、历史、支持和冲突证据重组成 relation-aware evidence unit,最后在上下文预算内重排和打包。给模型的不是一袋相似文本,而是一组带演化结构的证据。
 检索从当前记忆出发,展开相关历史与冲突证据
图:生命周期展开让模型同时看到“现在是什么”以及“它如何变成现在”。来源:原论文。
#局部关系换来更强结果和更低成本
论文在 BEAM 100K 和 StructMemEval 上使用开源与闭源模型测试。BEAM 覆盖 20 段十万 Token 会话和 400 个问题,考察更新、矛盾、时间、多跳与偏好等十类能力;StructMemEval 则测状态跟踪、树结构、计数和推荐。
在相同 backbone 的比较中,MemoryLACE 取得最高综合表现。相对使用 retain–recall–reflect 全局反思流程的 Hindsight,它把 BEAM 端到端运行时间降低 66.6%,相当于 2.99 倍加速。最大节省来自记忆构建阶段:有界局部整合替代了昂贵的全局反思。
消融显示,生命周期展开和时间意识贡献最大。这个结果把 Agent Memory 的重点从“存得更多”转向了让证据的更新、替代与冲突可见 。当系统需要处理持续变化的用户事实时,这比单纯升级向量检索更接近真正的问题。