让 Agent 根据论文生成代码,最常见的流程是先写一份计划,再开始创建文件。问题在于自由文本计划很容易被后续步骤忽略、重述或压缩:公式中的条件消失,评测协议被替换,跨文件依赖也在局部实现中断裂。
PaperCompiler 把中间产物从“建议”变成 可追踪的仓库规格 。
#先判断每条信息的证据等级
系统抽取与实现有关的论文证据,并区分四类状态:论文明确支持、工程推断、交给外部组件,以及仍未解决。每条要求保留来源位置,避免 Agent 把合理猜测伪装成论文事实。
随后,它把方法约束编译成 non-degradation requirements:生成代码不能为了方便而弱化的算法语义和评测条件。规格继续分配到具体文件、公开 API 和跨文件依赖,明确哪个模块拥有某项责任。
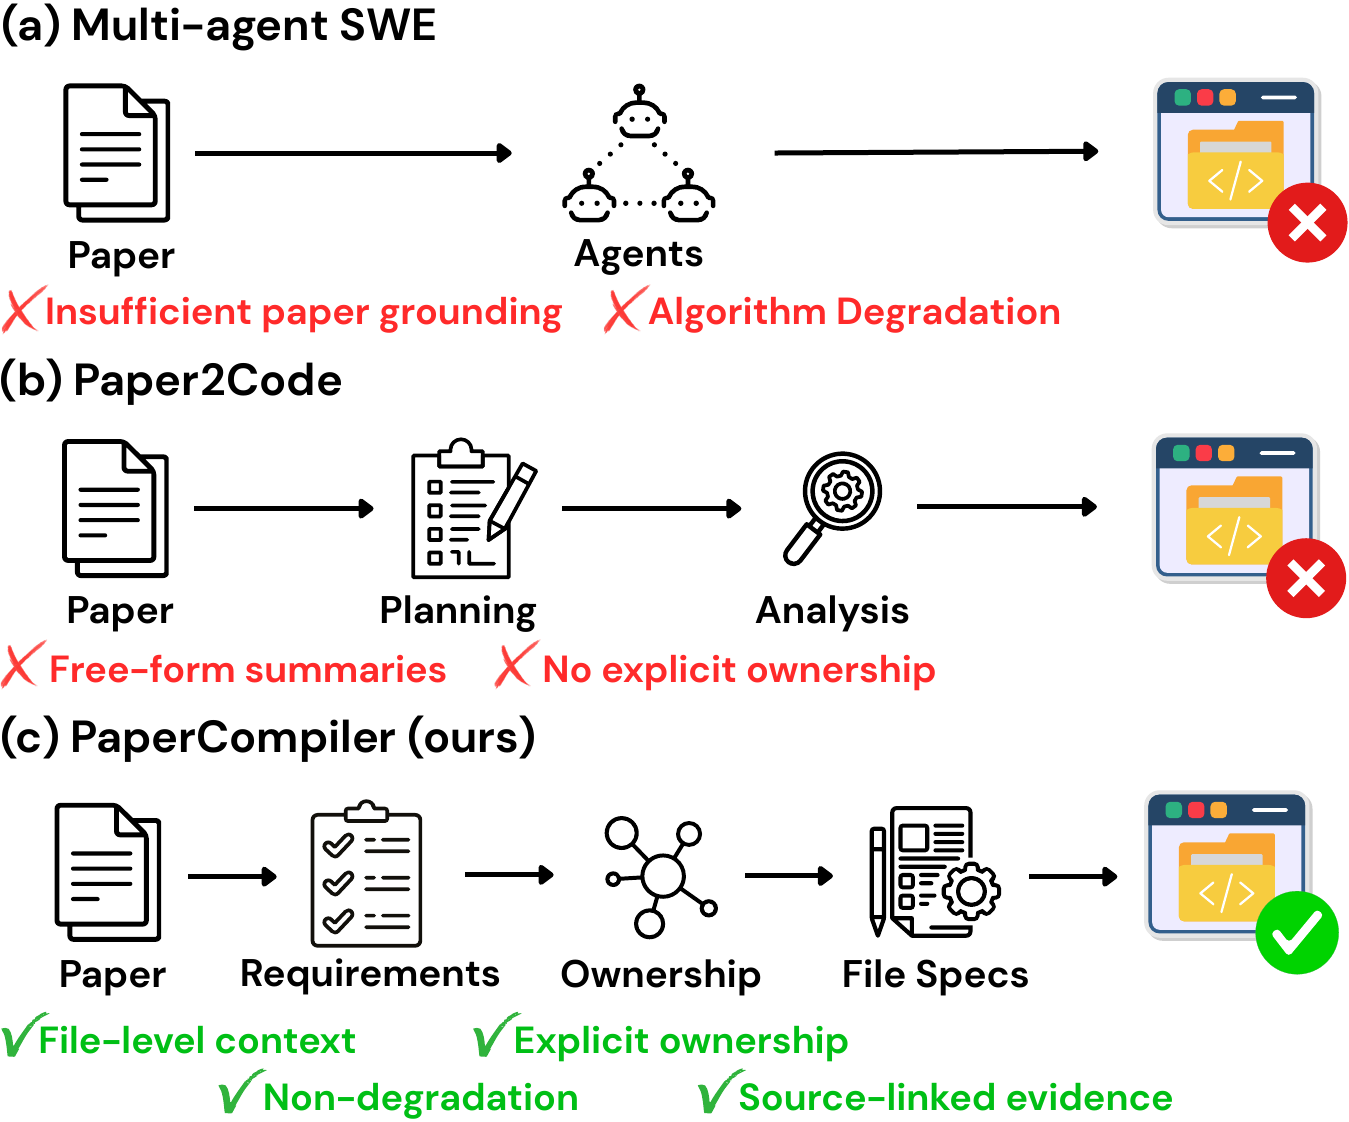 PaperCompiler 从论文证据生成可追踪的仓库级实现规格
这与传统“先做计划”的差别在于可检查性。一个计划可以说“实现论文模型”,规格必须说明注意力矩阵在哪个文件计算、输入输出是什么、哪些维度不能被简化,以及哪些信息仍需要确认。
#给局部编码自由,但守住全局语义
PaperCompiler 不要求逐行复刻参考仓库。它固定论文已经决定的部分,把局部工程选择留给 Coding Agent。这样既避免把生成过程锁死,也降低 Agent 用熟悉模板替换新方法的倾向。
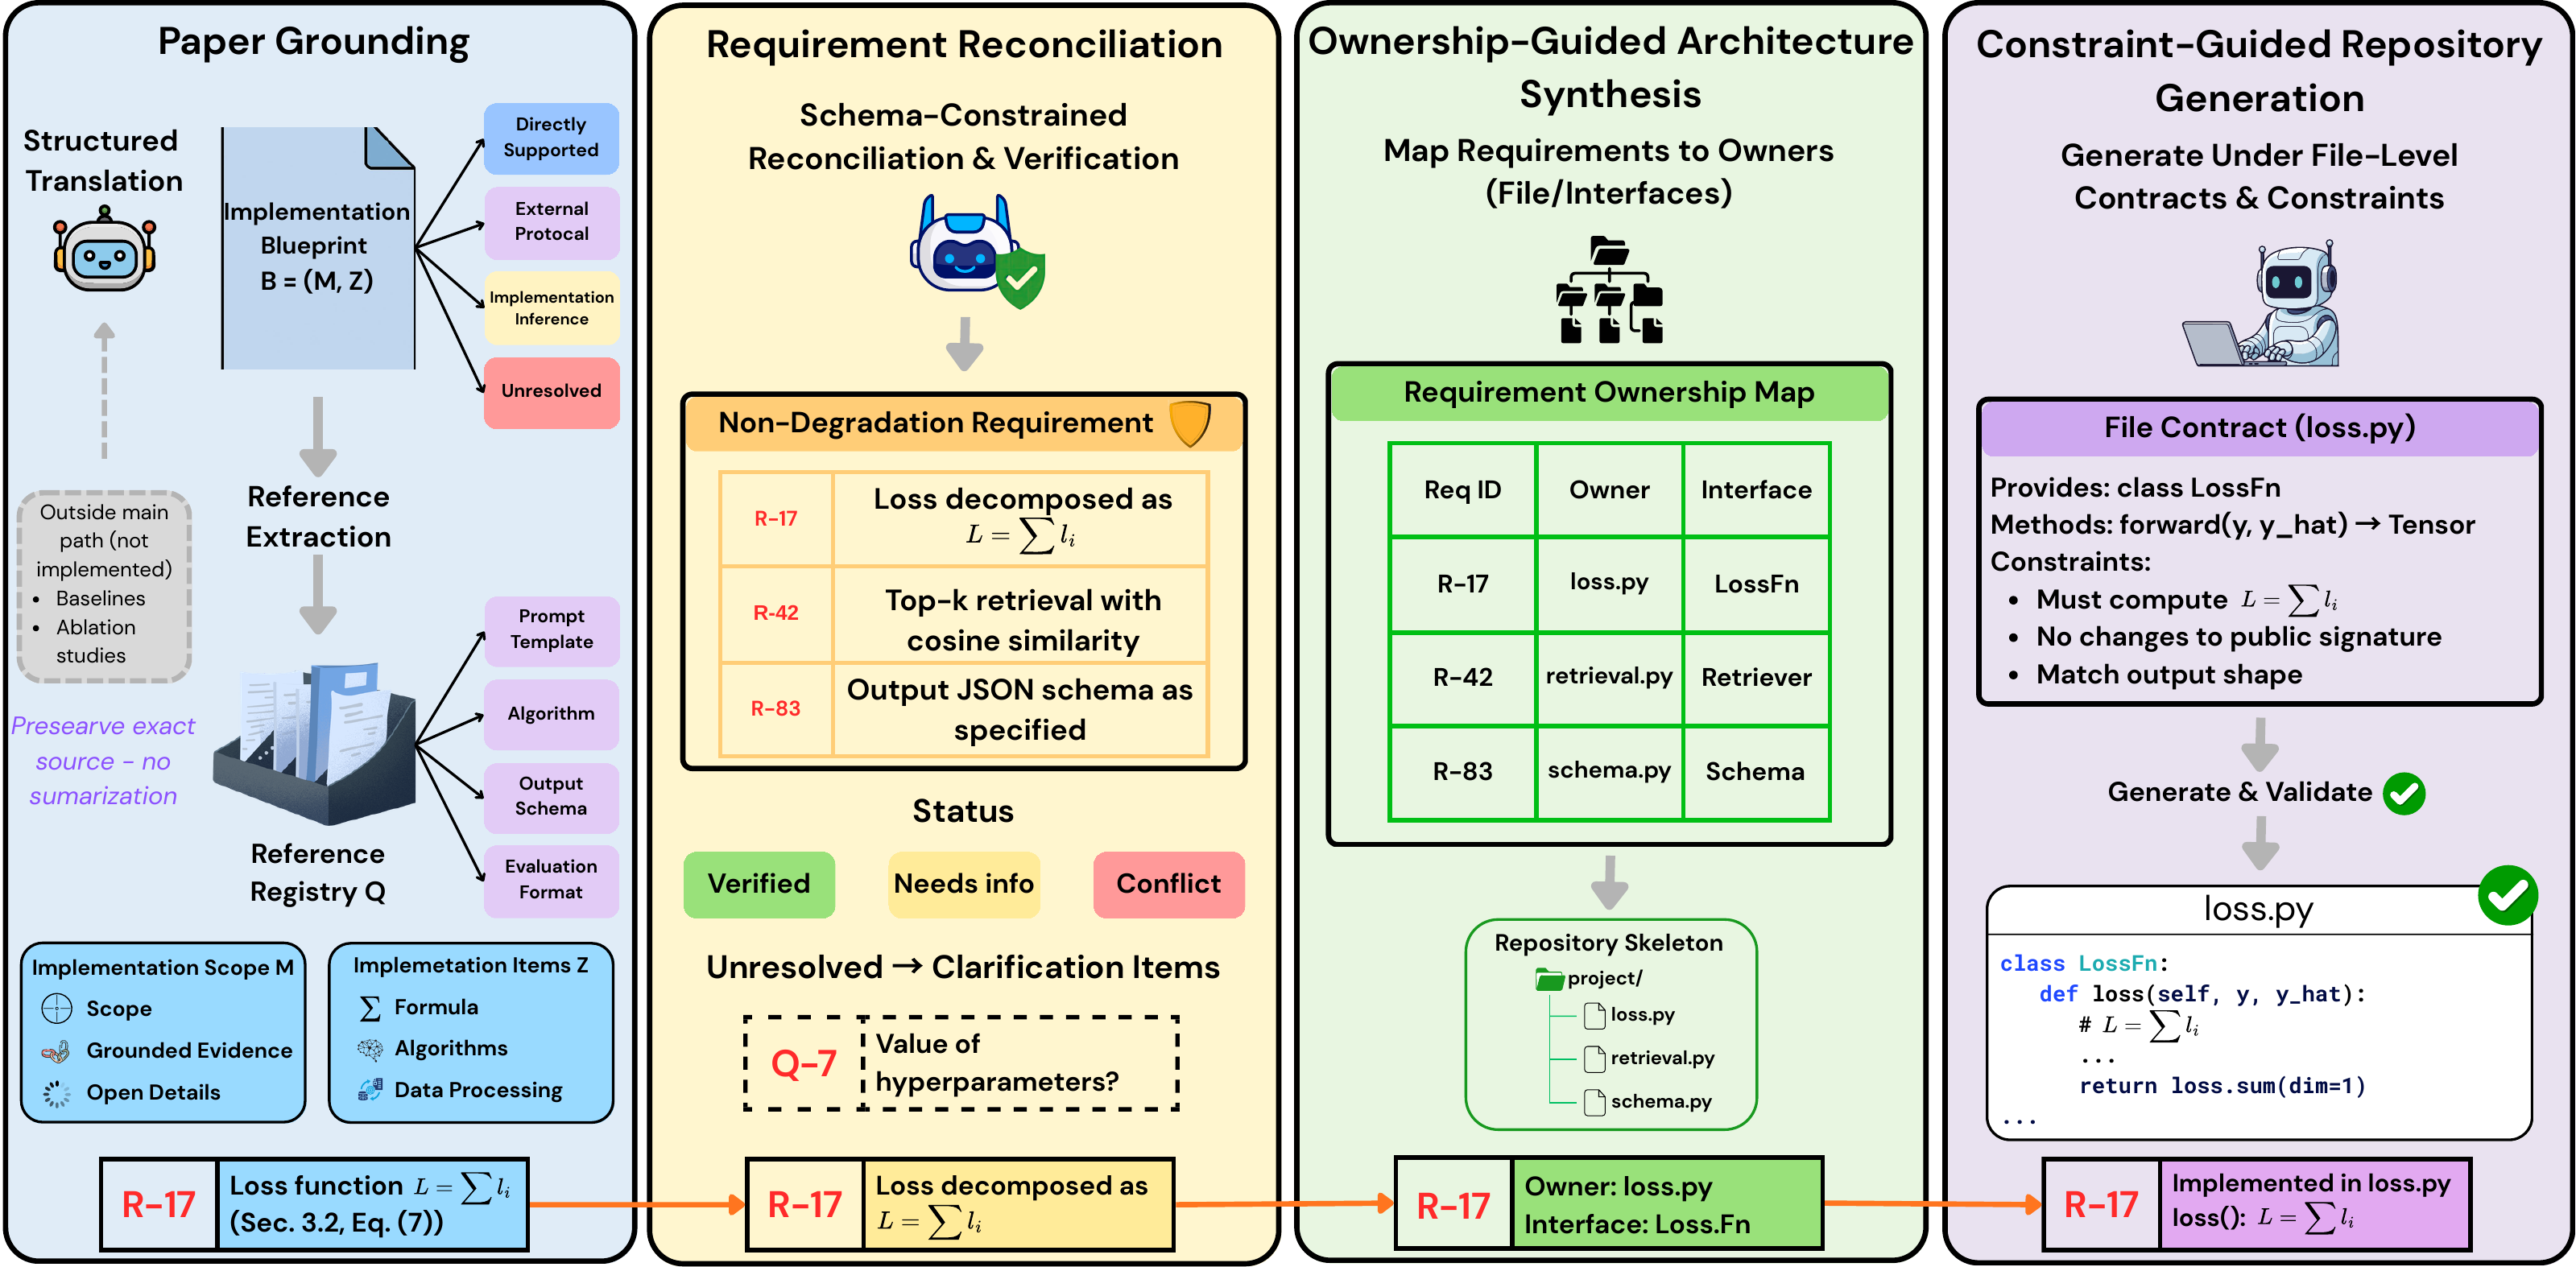 论文证据、仓库规格与代码文件之间的追踪链
在 Paper2CodeBench 上,系统的参考实现忠实度从 3.64 提升到 4.15,相对增加 13.8%;高严重度评审问题从 13.2% 降到 6.1%。提升不是来自更长的最终代码,而是中间层减少了算法简化、文件职责错配和评测协议丢失。
#规格也可能自信地编错
编译式流程并不会自动保证正确。证据抽取器可能漏读附录、把推断标成事实,或者把实现责任分给错误模块。因此规格本身必须能回链到原文,并接受人工或独立 Agent 的差异审查。
更实用的落地方式是先对高风险部分使用:核心公式、数据预处理、训练目标、评测脚本与跨文件接口必须编译成显式约束;样板代码和局部组织仍交给 Agent 自由完成。
PaperCompiler 指向一种更普遍的 Agent 工程模式:面对复杂来源,不要直接从自然语言跳到代码。先生成一个带证据类型、所有权和验收条件的中间表示,再让执行层实现它。