GitHub 上的大量能力对 Agent 来说仍然是“看得见、用不好”:README 说明组件,却很少给出针对具体目标的完整过程;依赖、入口、数据格式和验证条件散落在多个文件中。DisCo 试图把一个仓库编译成可复用的 Agent Skill 。
#从代码仓库到经过验证的程序知识
流程先分析仓库提供的能力与任务家族,再生成候选工作流;随后在真实环境中执行、修复和验证,只有能完成目标并留下可检查结果的过程才进入技能库。最终技能包含适用条件、操作步骤、工具接口和验收方式,而不是对 README 的摘要。
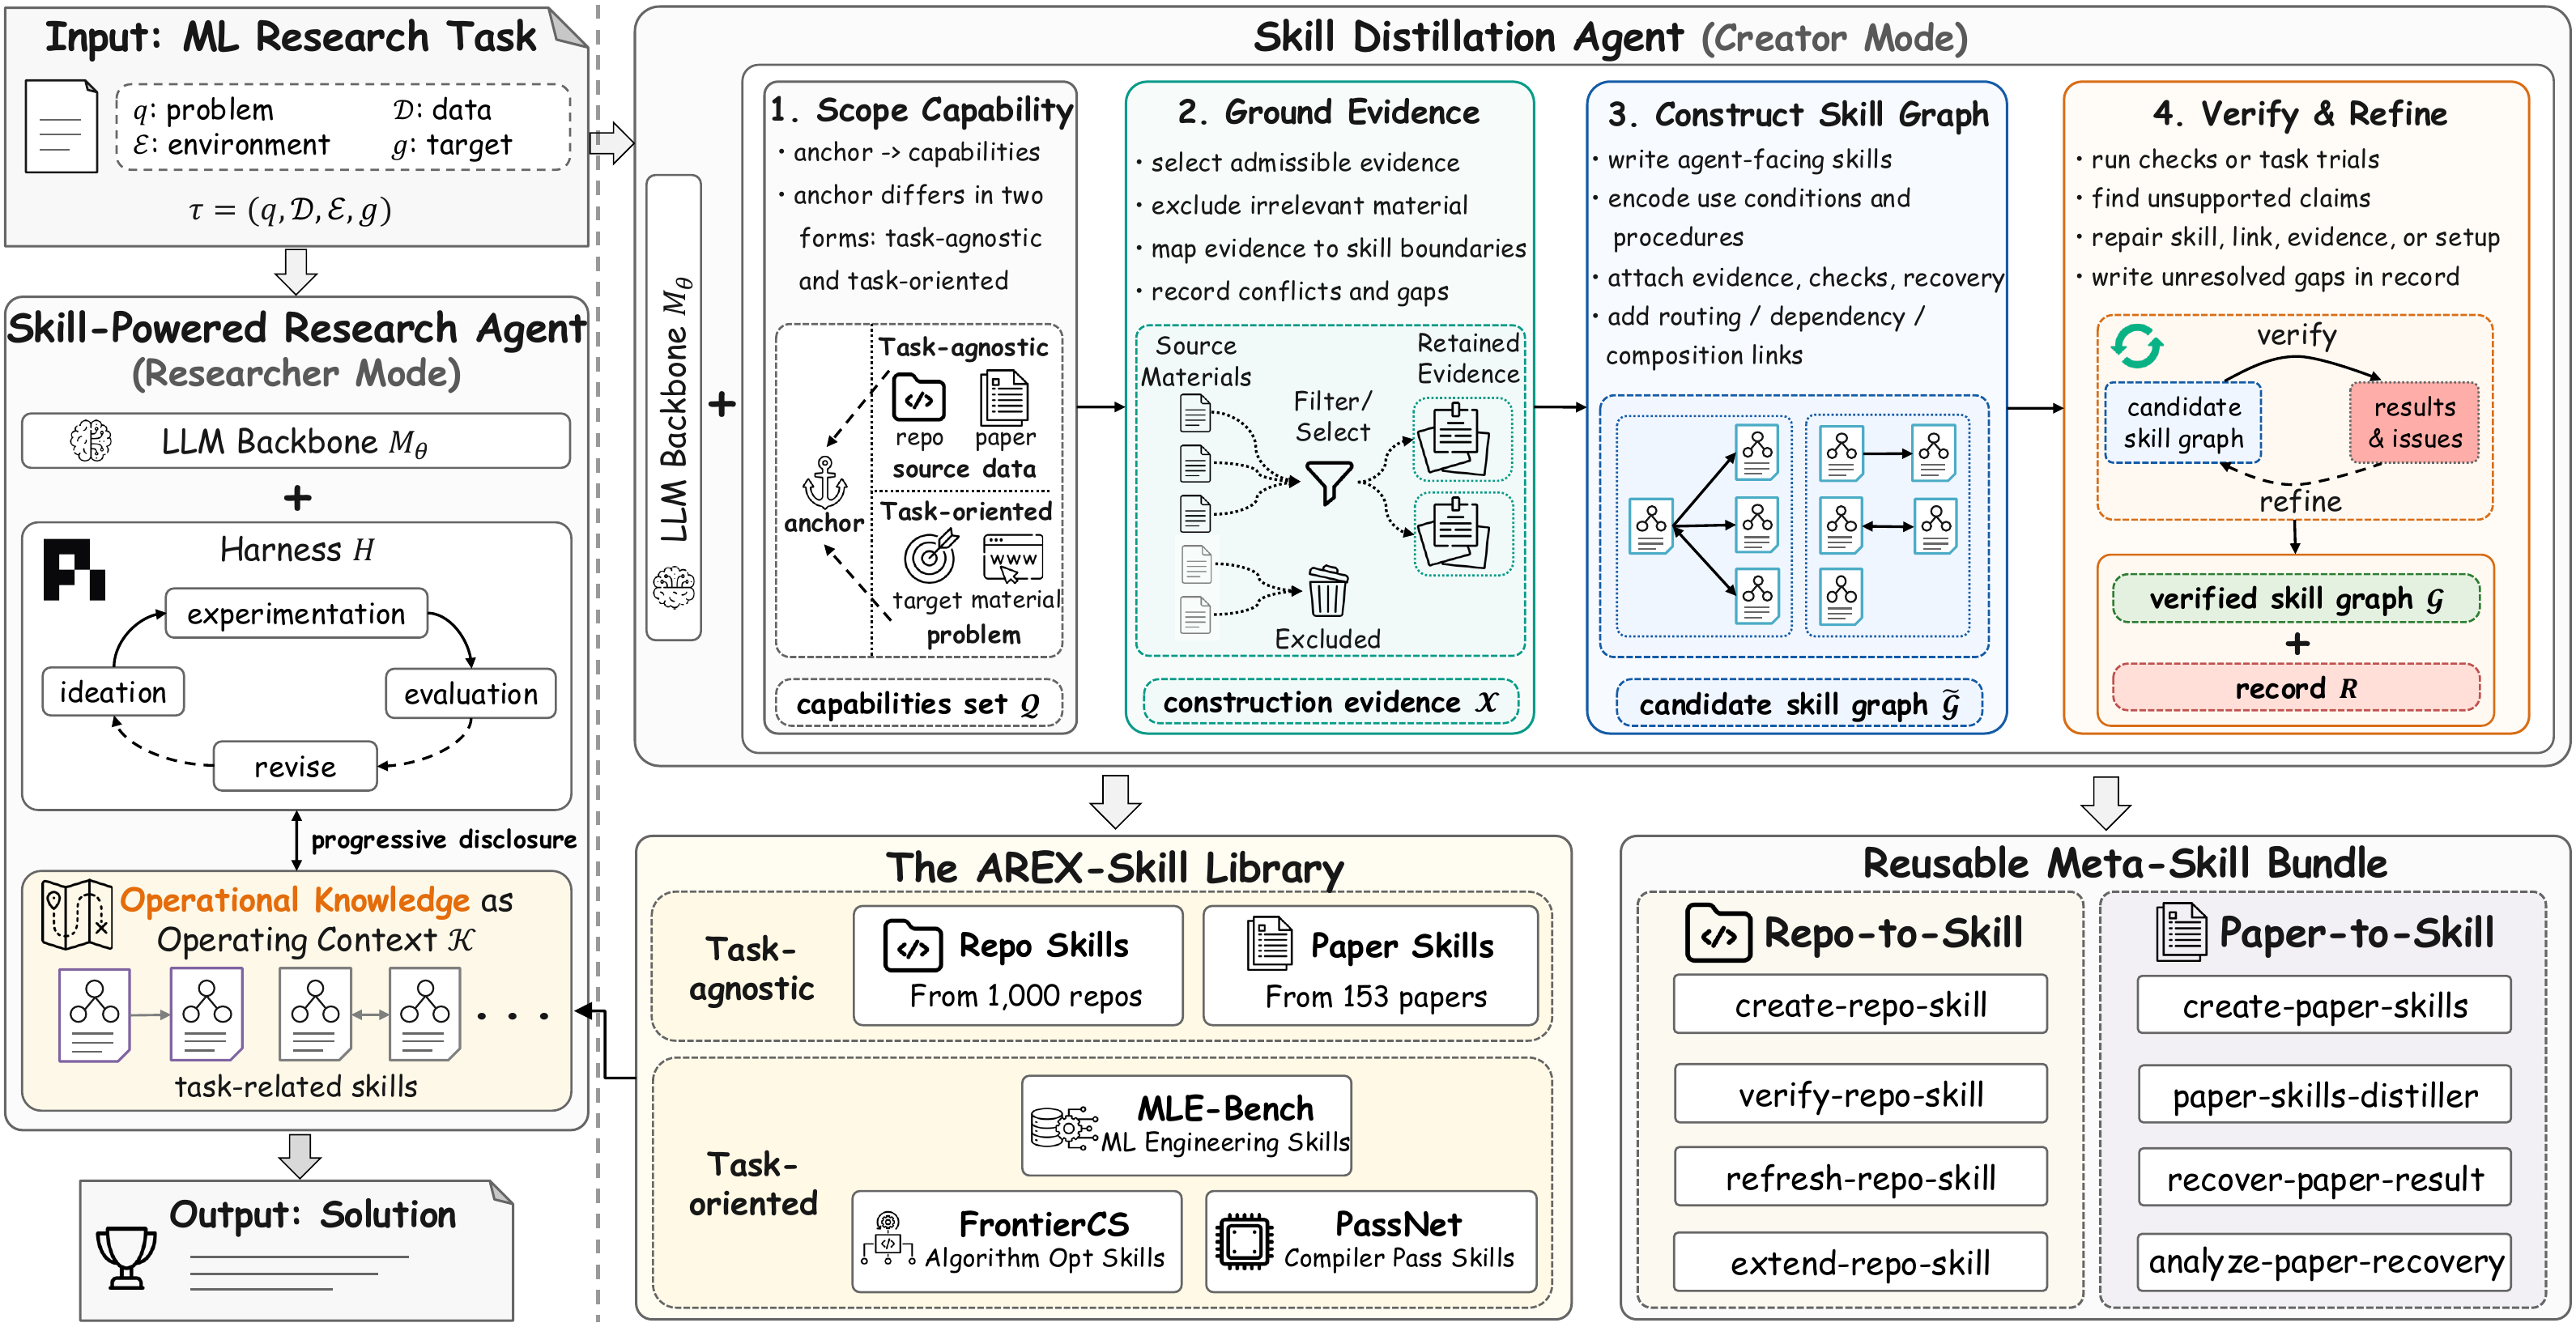 DisCo 从仓库发现到技能生成与执行验证的流程
研究从 1000 个 GitHub 仓库中生成 5000 多个验证技能,覆盖 20 个技术领域与 178 个任务家族。规模的重要性不在于文件数量,而在于这些技能来自真实软件生态,并经过统一流水线检查。
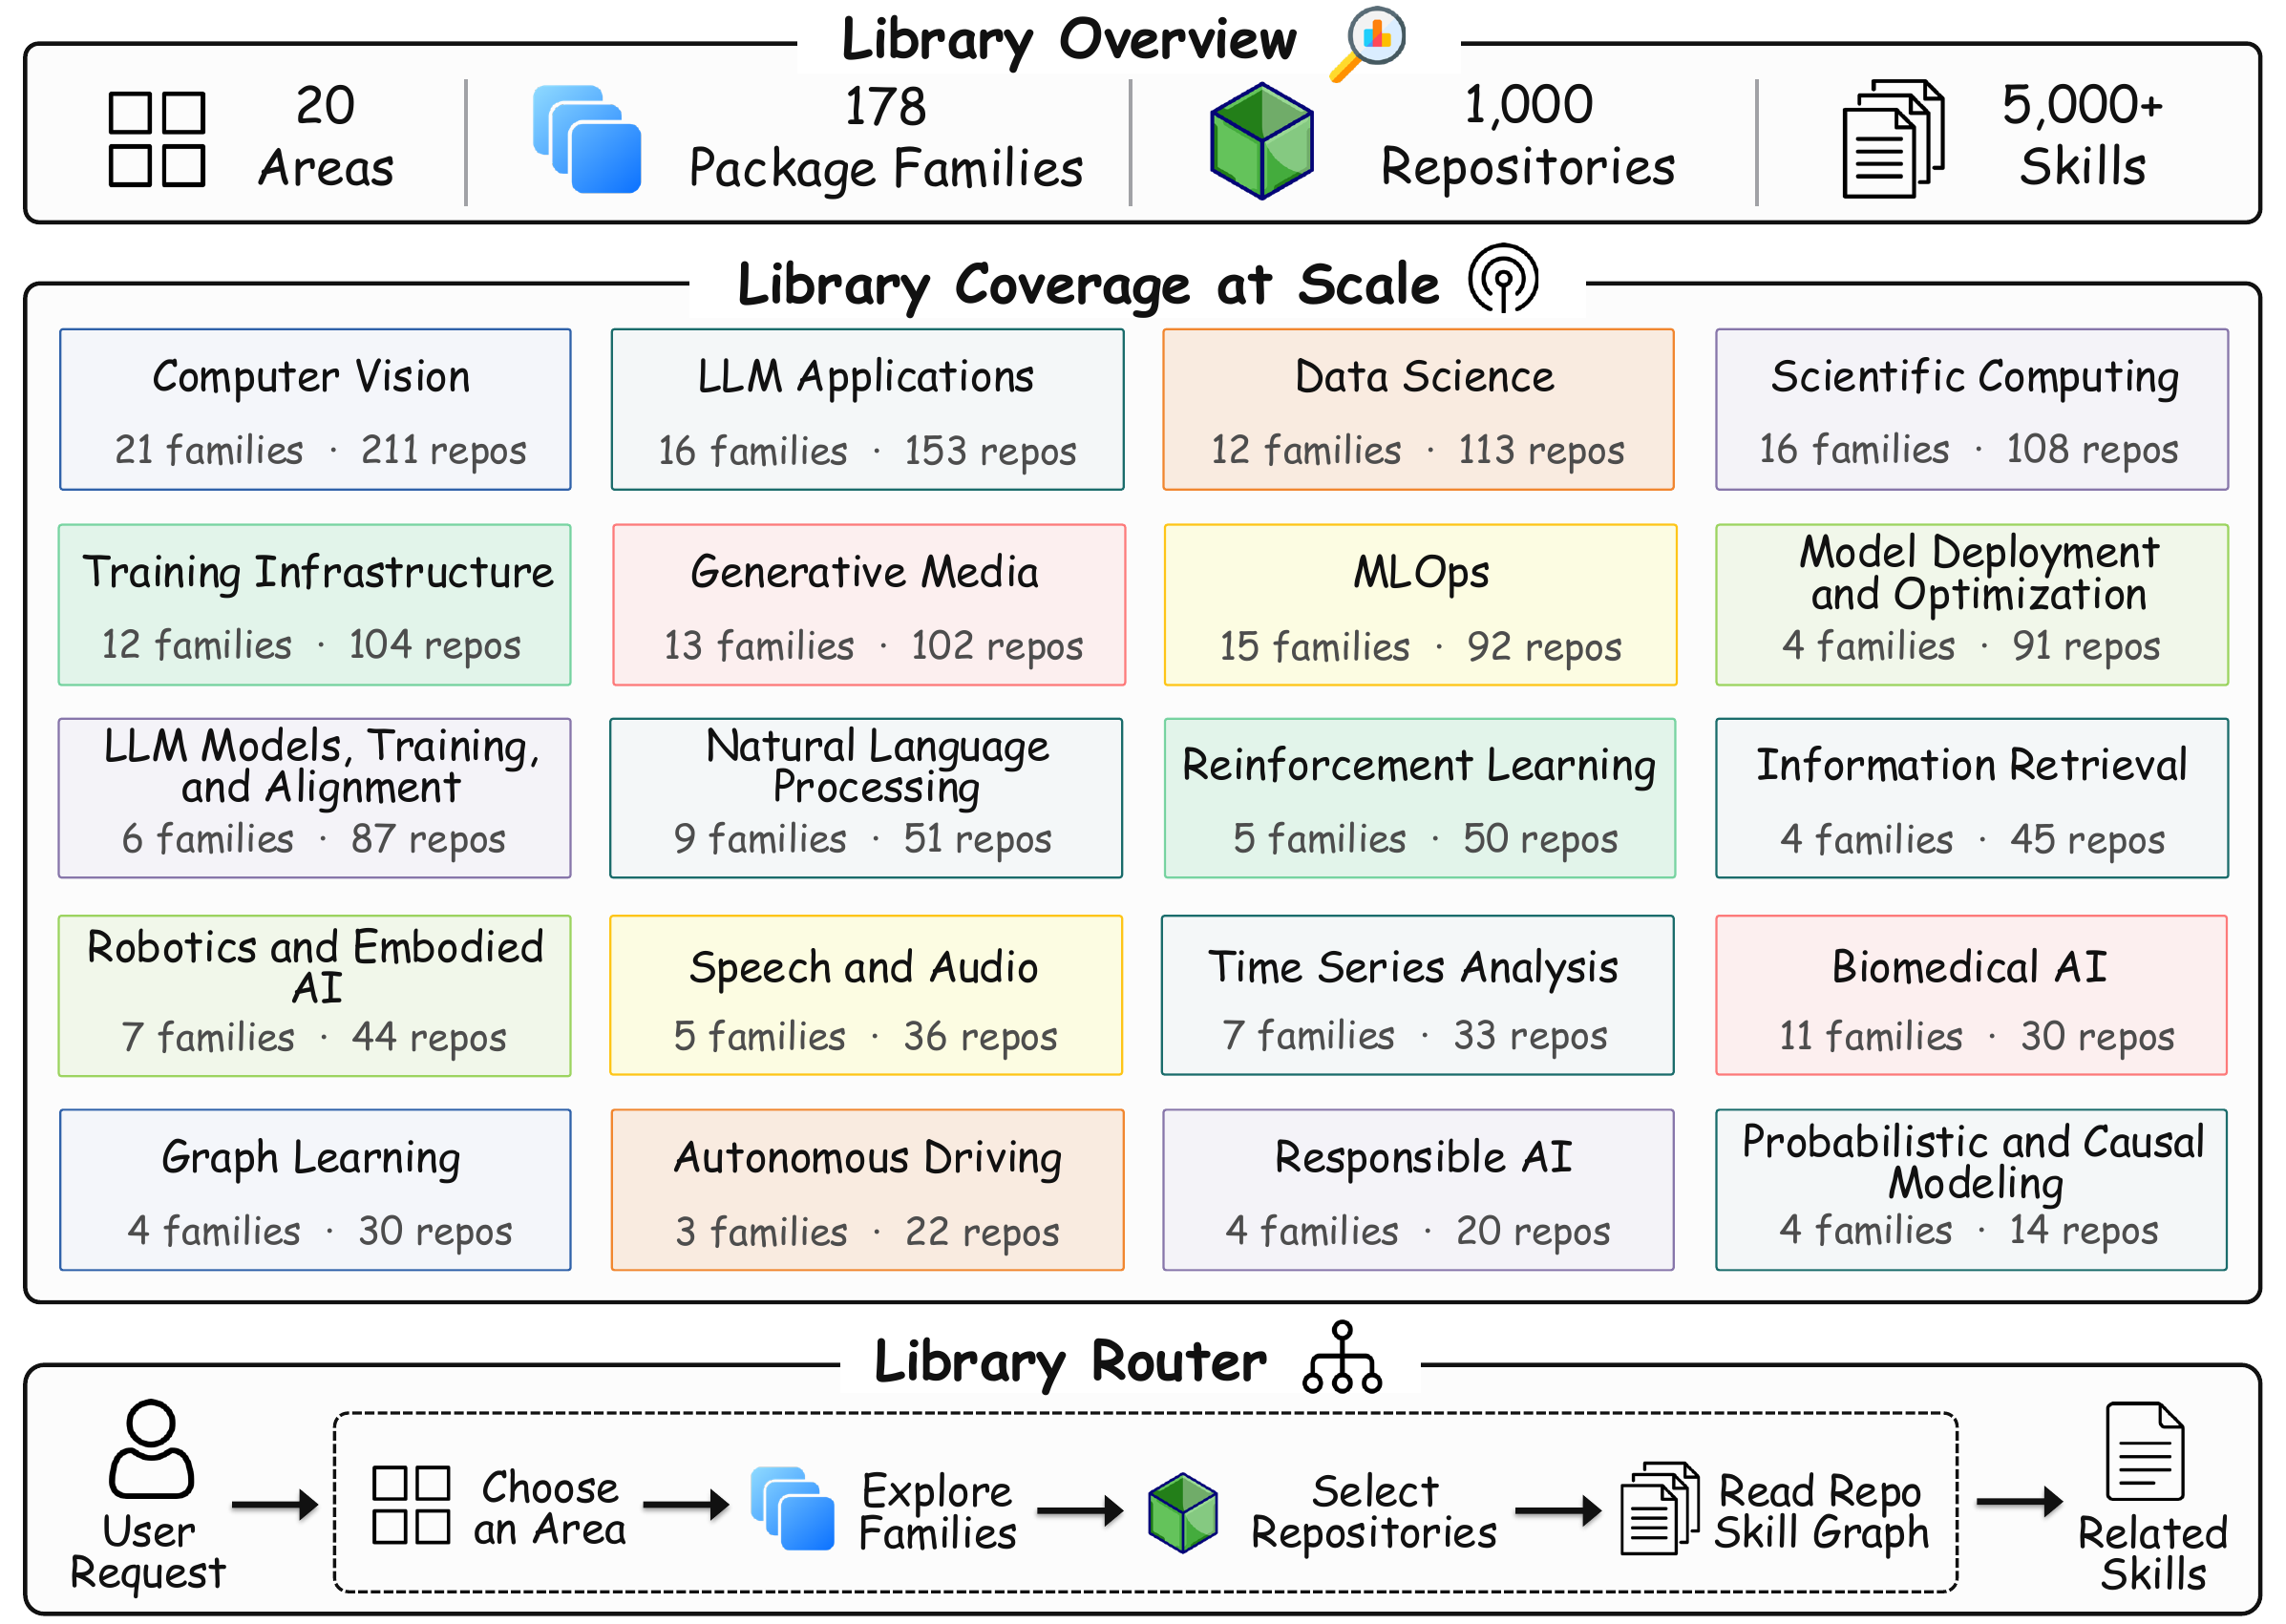 由 1000 个仓库构成的技能库及其领域分布
#固定模型后,技能仍带来显著增益
研究固定 GPT-5.5、Agent Harness 和推理预算,只改变是否提供 DisCo 技能。在 MLE-bench 上相对提升 134.3%,PaperBench 提升 34.4%,FrontierCS 提升 9.2%,PassNet 增加 14 个百分点。控制变量很关键:提升不能被解释为换了更强模型或给了更多调用预算。
#技能生态需要构建系统
Repo-To-Skill 把技能生产拆成发现、生成、执行、修复、验收和版本化,这更接近软件包构建而不是提示词市场。未来技能仓库至少需要标注依赖、权限、适用版本、测试环境和失败边界;否则“可安装”仍不等于“可运行”。
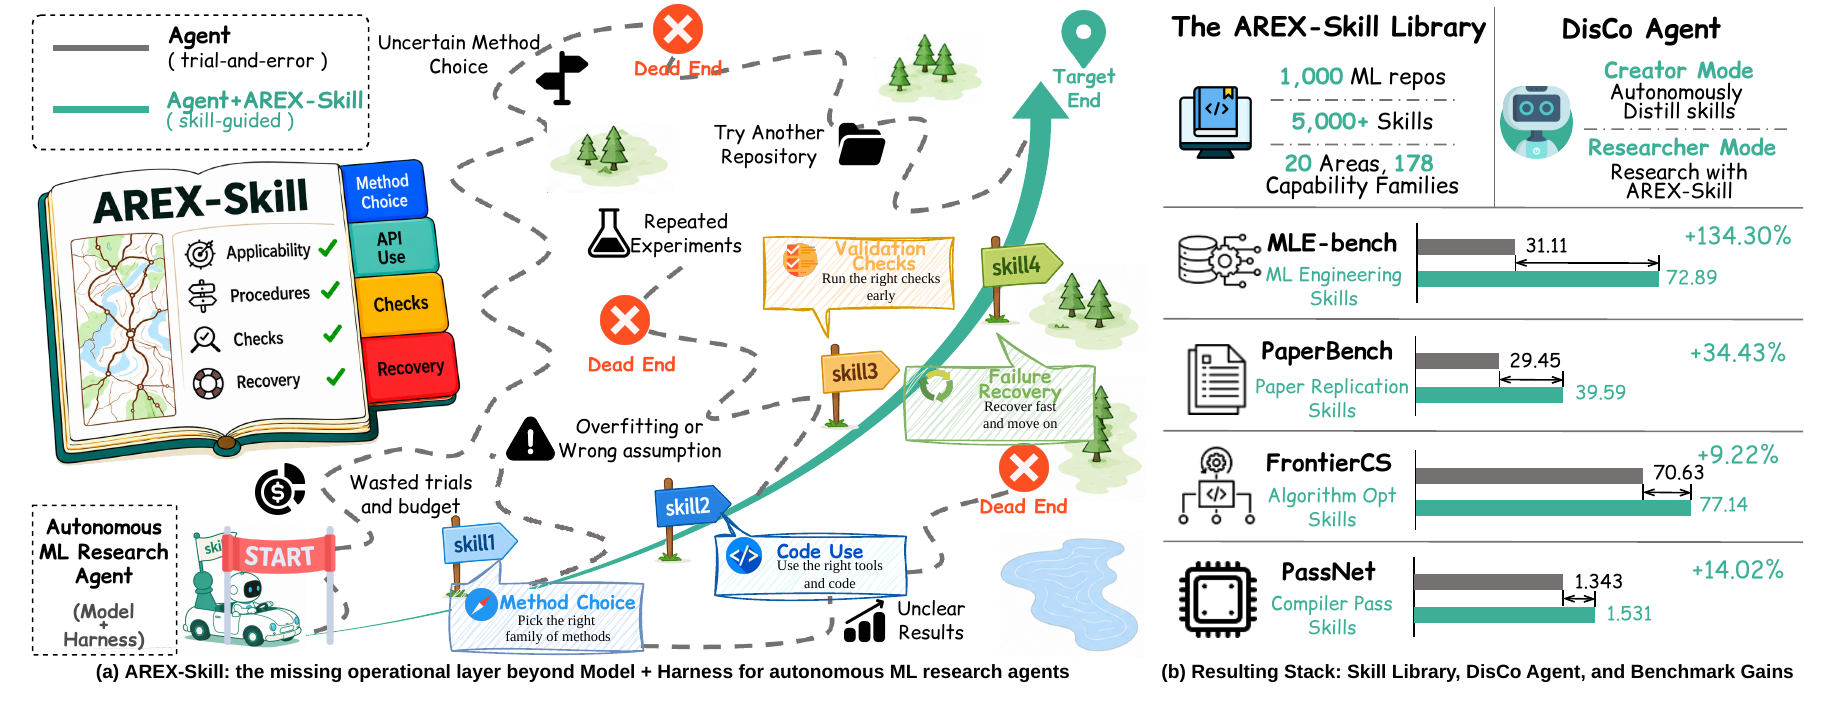 Repo-To-Skill 的研究设定与能力增益概览
这项工作也提示了新的供应链问题:自动生成的技能必须追踪来源并可复现验证。规模化只有与可审计性一起出现,才会把开源仓库真正转化为 Agent 能稳定调用的能力层。