可验证奖励在代码、数学等任务里很好用,因为答案能被测试或规则检查。但真实 Agent 会操作应用、协调多步流程、处理中间失败,常常没有一个可靠的终点验证器。常见替代方案是让 Judge 按多条 rubric 给整条轨迹打分,可这个总分覆盖几十步,无法指出真正贡献或拖累结果的动作。
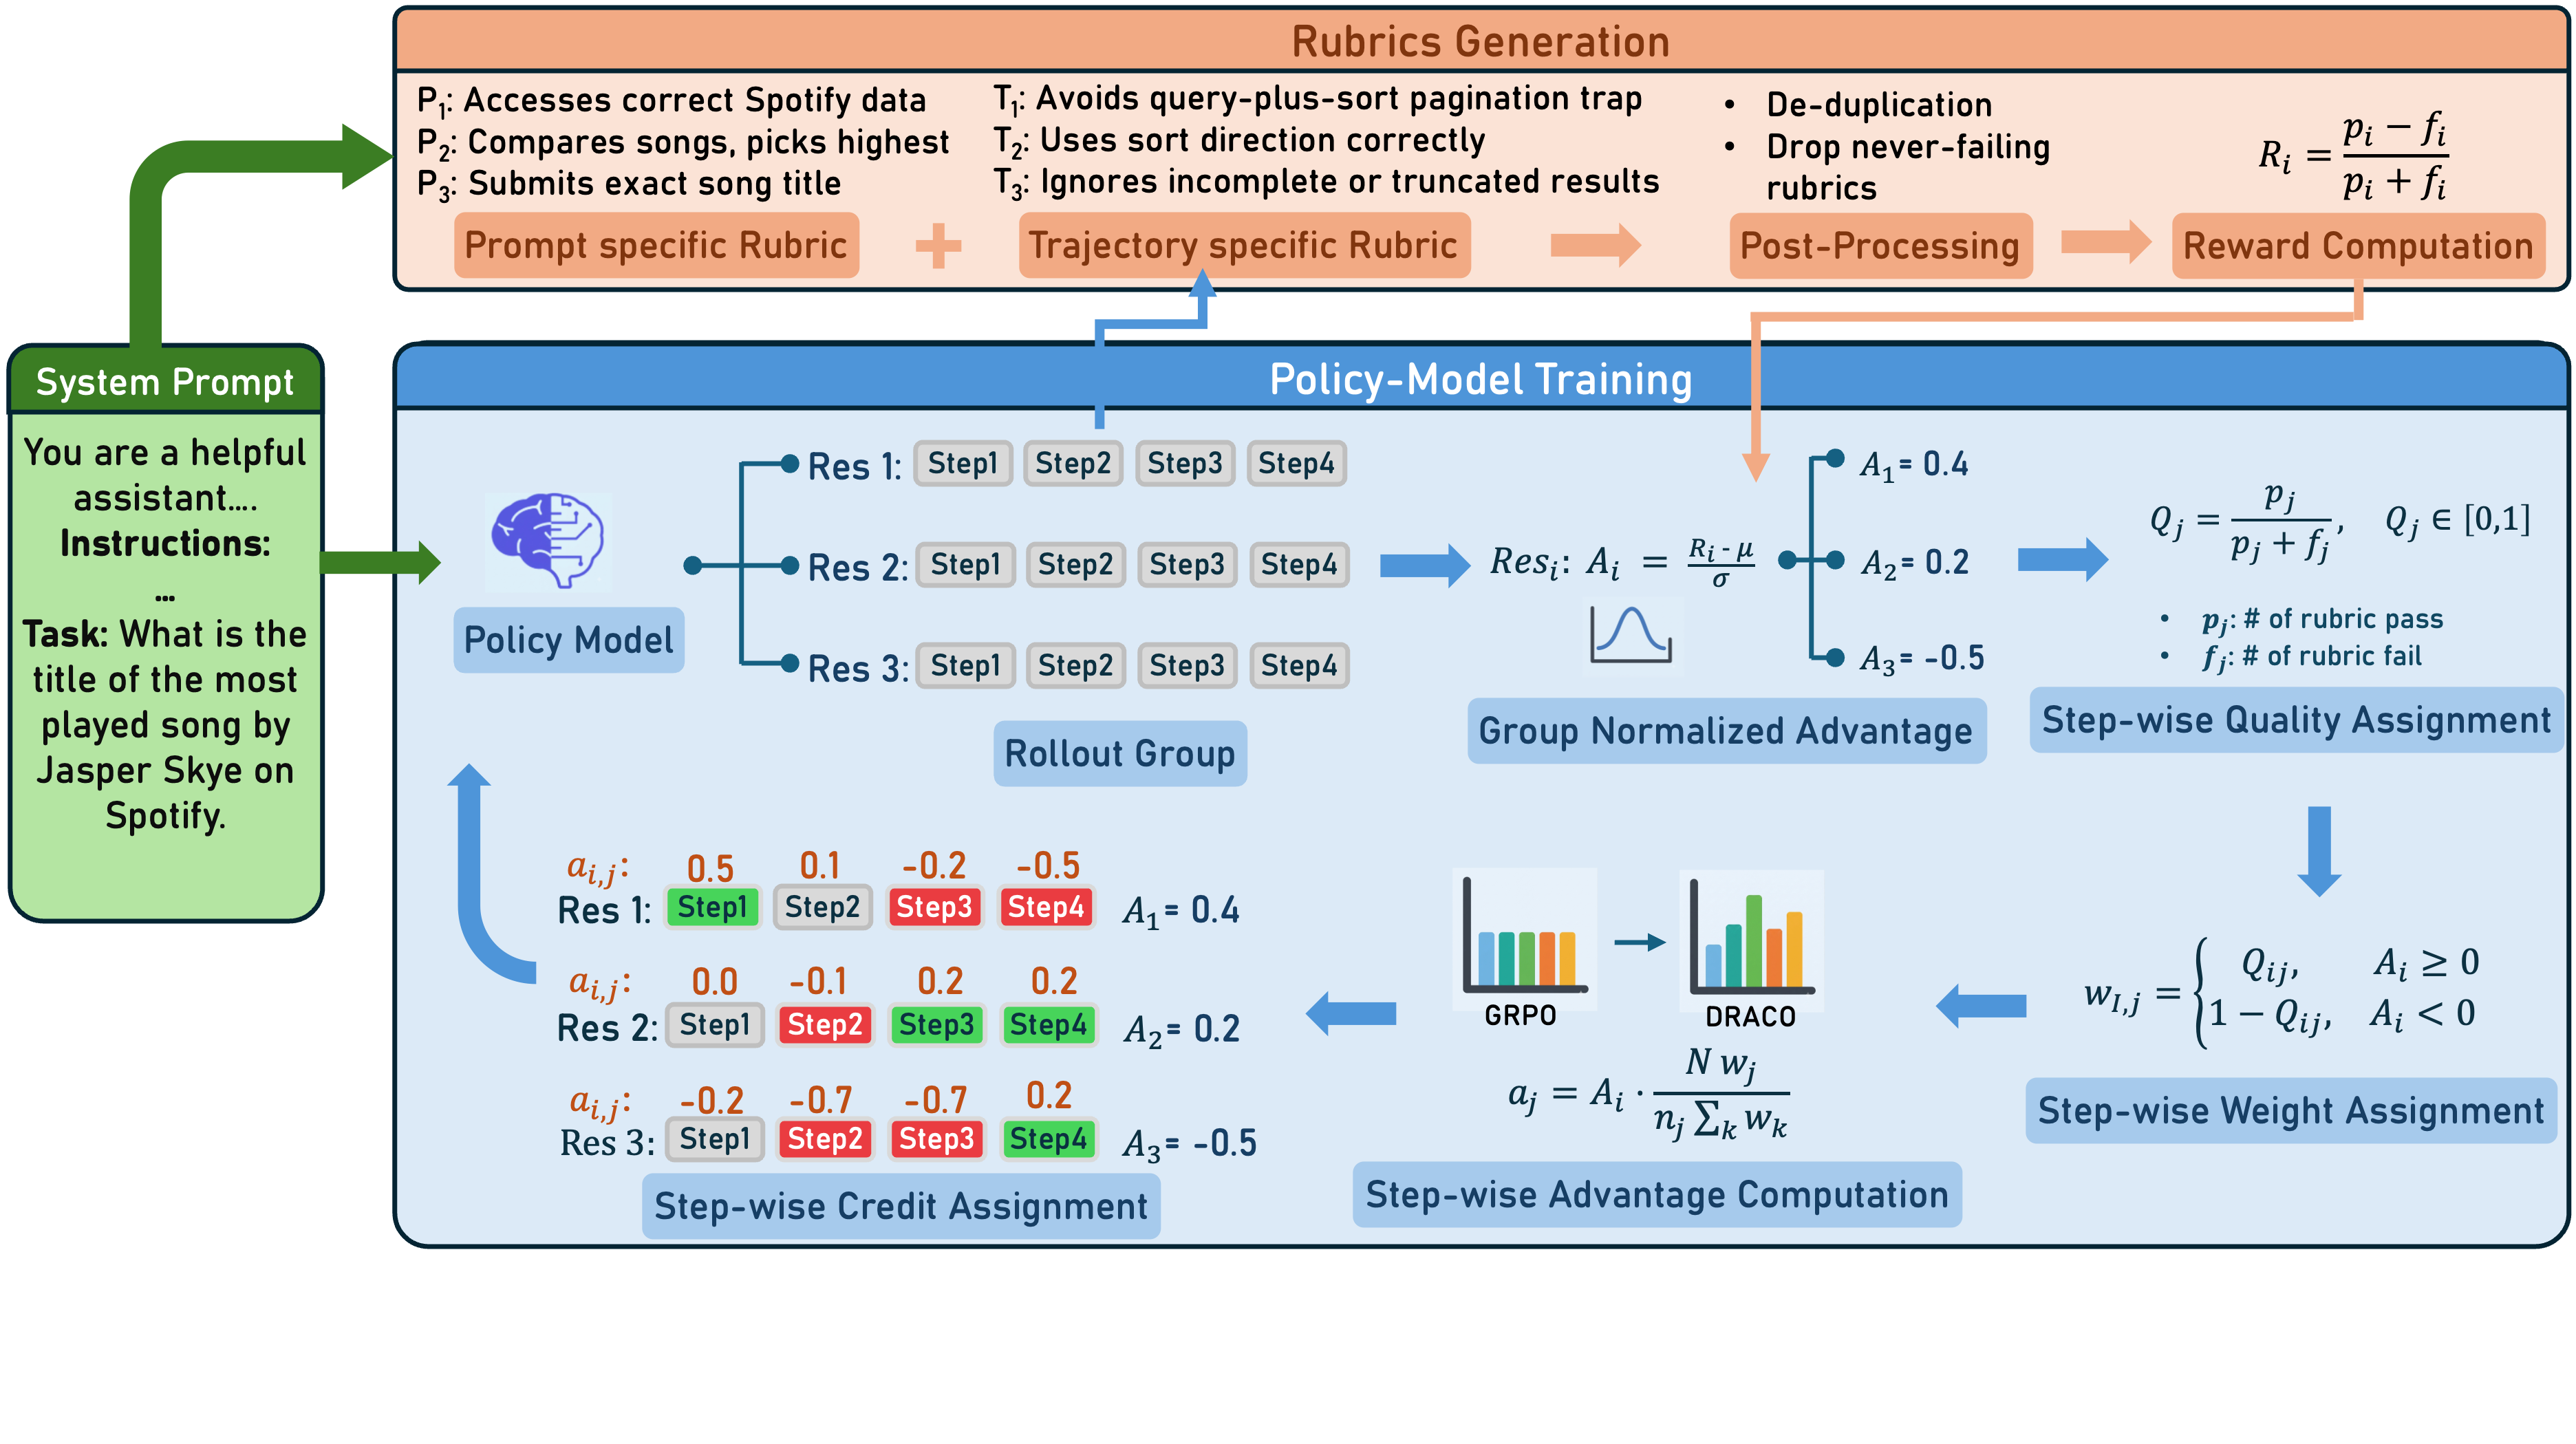 DRACO 从动态 rubric 到逐步 credit 的训练流程
图:DRACO 只在轨迹级调用 Judge,再将各项 rubric 的判断分配到相关步骤。来源:原论文。
#动态 rubric,闭式归因
DRACO 在训练中持续生成并更新 rubric,让评价标准跟随策略能力变化;轨迹完成后,Judge 只需对每条标准评分一次。随后系统根据 rubric 与步骤的对应关系,把总判断重新分配为不同的逐步 advantage,再交给 GRPO 更新策略。
关键是,这个重分配有闭式解:不需要每个时间步再调用一次 Judge,也不需要训练一个额外的 attribution 模型。它保留轨迹级评价的低调用成本,同时给长链条中的动作提供差异化信号。
#没有验证器,也能超过稀疏真值奖励
在 AppWorld 上,DRACO 比基础模型提升 15.9 个百分点,比使用稀疏 ground-truth reward 的 GRPO 还高 5.3 点。迁移到域外的 Tau-Bench 时,即使不使用前沿 Judge,它仍比基础模型提高 5.3 点,并超过真值奖励训练与其他 rubric 方案。
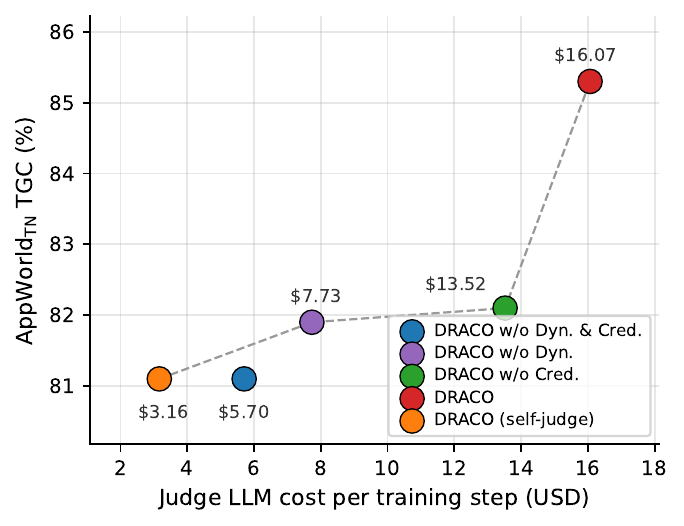 不同训练方案的效果与 Judge 成本边界
图:DRACO 在训练收益和评价成本之间形成更好的 Pareto 边界。来源:原论文。
100 步训练后,Qwen3.6-27B 在 AppWorld 的任务级指标从 69.4 提升到 85.3,场景级指标从 41.1 提升到 70.6,同时单次评估成本下降。论文的消融还说明,动态标准和逐步归因需要一起工作:只改 rubric 不解决 credit assignment,只把一个粗糙总分拆开也不会自动得到高质量训练信号。
这项工作的真正价值,是为“结果不可直接验证”的 Agent 领域提供了一条可扩展路线:少量高质量轨迹判断,加上结构化的步骤归因 ,可能比昂贵的逐步监督更实用。