Coding Agent 以惊人的速度生产代码,传统 Code Review 正被推到一个尴尬位置:坚持人工逐个审查,评审很快成为交付瓶颈;放弃审查,又像是在主动拆掉软件质量的最后一道防线。
Christian Kästner 认为,真正值得怀疑的不是“代码审查还能不能保住”,而是“今天这套审查方式是否本来就值得保住”。现代 Code Review 并非软件工程的永恒标准,而是在特定成本条件下形成的历史平衡。Agentic Coding 同时改变代码生产、返工、风险和评审的成本后,这个平衡自然会被打破。
#现代 Code Review 本来就是一次妥协
代码审查过去比今天重得多。上世纪七八十年代流行的 Fagan Inspection,会让多名评审者、主持人和作者一起逐行阅读少量代码,有时还要开会朗读和讨论。研究显示,这种方法发现缺陷的能力甚至可能超过测试,但代价极高:审查大约 400 行代码,可能消耗三名评审、主持人和作者合计超过八个开发小时。
它因此只适合高风险系统的关键部分,不可能覆盖所有修改。
后来,开源项目逐个 Patch 审查的方式逐渐进入公司,并最终演化成今天与 CI、测试和静态分析结合的 Pull Request 流程。现代 Code Review 对发现深层缺陷其实并不擅长,常见成果是找出浅层错误、可读性问题和规范偏差;但它足够便宜,可以覆盖几乎所有代码变更。
更重要的是,审查还带来许多并非“找 Bug”的收益:迫使开发者写出别人能理解的代码,建立集体代码所有权和团队认知,支持学习与指导,发现优化机会,并维持约定。Code Review 从缺陷检测活动,变成了集体解决问题的过程。
可以把这种状态看成 AI 之前的一个均衡点:它降低的风险和产生的间接收益,刚好足以证明它的成本合理。
#用四个变量重算审查的价值
文章提出一个简单模型,把争论拆成四个变量:
- P :每行代码的生产成本;
- L :每行代码未来可能产生的责任成本,包括内部返工,以及安全事故、声誉损失、客户赔偿等外部伤害;
- R :每行代码的审查成本;
- E :审查降低责任成本的有效程度。
总成本可以理解为:生产成本,加上审查后仍残留的责任成本,再加审查本身的成本。理性的团队会持续投入审查,直到新增一单位审查成本不再能抵消相应风险。
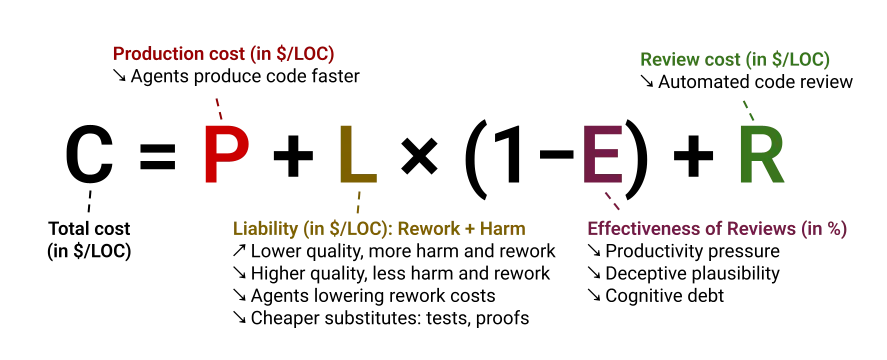 代码生产成本、责任成本、审查有效性和审查成本模型
对高风险代码来说,L 很高,一次安全或金融事故就可能造成真实伤害,因此花更多 R 换取更高 E 是合理的,甚至可能重新接近重型检查。普通低风险软件的主要责任成本则是返工;现代语言、静态分析、测试与 CI 已经提前消灭不少问题,所以轻量审查以适中成本换取适中收益,也显得合理。
Agentic Coding 的复杂之处,在于它不是只改变 P,而是同时推动四个变量变化。
#代码便宜九成,不等于软件便宜九成
Agent 最直接的作用是大幅降低生产成本 P。但如果审查和责任成本不变,软件总成本的降幅会远低于代码生成速度带来的直觉。
作者举了一个简单例子:如果生产代码原本只占总成本的三分之一,那么即使 P 降低 90%,总成本也只会下降约 30%。这可能解释了为什么开发者经常感受到十倍的代码产出速度,而学术研究测得的整体生产率提升往往不超过 30%。
当 P 快速下降、R 没有同步下降时,Code Review 必然显得越来越像瓶颈。问题不是评审突然变慢,而是代码到达评审队列的速度变了。
#Agent 生成代码的责任成本可能升,也可能降
对于 L,今天还没有确定方向。
一方面,已有研究和现实事故显示,Agent 可能生成质量低于人类的代码,需要更多返工,也可能制造安全和业务损失。这会提高责任成本,并支持更严格的审查。
另一方面,Agent 通过反复迭代和工具使用,也可能产出高于普通人工水平的代码。即使初始质量较差,自动调试和修复也能让返工变便宜,从而降低 L 中的内部成本。测试生成、静态分析、自动审查,甚至未来的大规模形式化验证,也可能在人工审查前就提前消除风险。
低风险场景最可能先发生变化:自审 Agent、更多自动测试和廉价返工,可能让传统人工审查的边际价值迅速下降。但在安全、医疗、金融等高风险场景中,真实伤害发生后再让 Agent 修补生产系统,并不能撤回已经造成的损失。返工变便宜,不代表外部伤害也变便宜。
#更多代码正在让人工审查失效
审查有效性 E 也受到两类压力。
第一类是生产率压力。Agent 提交越来越多代码,团队又被要求更快交付,评审者只能加速处理。结果常常不是高效审查,而是 Rubber-stamping:流程仍在,批准动作仍在,真正的检查已经被掏空。
第二类来自 AI 代码本身。它通常表面合理、表达整洁,容易触发自动化偏见,让人降低警惕。与此同时,没有参与生成过程的评审者缺少设计背景和问题上下文,必须重新建立对代码的理解。这种 Cognitive Debt 会降低判断质量,或者迫使团队投入更多时间才能维持原来的 E。
所以,强制保留人工审查政策,同时要求同样的人吞下更多 Diff,并不能保护 Code Review,只会保留它的仪式外壳。
#自动审查降低成本,但没有解决所有问题
让 Agent 自动审查,可以降低 R。现代 Code Review 常发现的浅层问题,机器本来就适合系统化检查,而且不受人力容量限制。自动评审还能使用清单逐项深入,某些场景下可能比匆忙的人类更接近重型检查。
但成本降低不能单独评价。自动审查的 E 是否高于人类、擅长哪些缺陷、会漏掉什么,目前仍未解决。机器可能深入发现复杂问题,也可能错过人一眼就能识别的业务错误;过多误报还会增加修改与验证成本。只是当 P 已经很低时,处理一些误报或许仍然划算。
未来很可能不是“人工审查”与“自动审查”二选一,而是根据 L 的组成,把不同风险交给不同证据和不同责任主体。
#最容易丢掉的是审查的间接收益
四变量模型没有直接纳入学习、指导、团队协作、集体所有权和代码库认知,而这些可能才是现代 Code Review 最重要的产物。
如果开发者不再阅读彼此的修改,他们对代码库的理解会逐渐下降,也更难写出高质量 Prompt 指挥下一轮变更。初级工程师失去观察资深工程师判断过程的机会,团队也可能不知道系统正在怎样变化。最终,这些认知损失又会以更高的责任成本回到系统中。
但这并不意味着必须保留旧流程。更有效的站会、AI 生成的变更摘要、专门设计的反馈与导师机制,或许能更直接地提供认知同步和人才培养。关键是先明确想保留哪一种收益,再寻找成本更低的替代机制,而不是把所有目标继续塞进 Pull Request 审查。
#人类控制可能上移,而不是消失
重型检查因为太贵而没有成为日常标准,轻量 Code Review 则用严谨性换来了覆盖率。Agentic Coding 改变了成本结构,下一次形态变化已经不可避免。
作者预计,Coding Agent 会越来越擅长在生产代码的同时自我审查,传统评审和静态分析能发现的浅层、可预测问题会越来越少。市场对 AI 生产率的追逐,也会让现有人工审查流程很难继续充当所有变更的必经关卡。
更大的问题不是人类是否完全退出,而是人的控制应该放在哪里。与其逐行阅读大量 AI 生成代码,人类的注意力可能更适合集中在需求、架构设计、测试设计,以及安全与可靠性护栏上。
Code Review 的旧形态也许会结束,但软件仍需要风险控制、责任分配、团队认知和人才培养。真正的机会,是把这些目标从一种历史流程中拆出来,重新设计一套适合 Agent 生产速度的工程制度。