SWE-bench 一类评测把“功能测试通过”作为成功标准,这是巨大进步,却仍少了一层真实软件工程约束:维护者可能要求保留公共接口、维持既有异常语义、正确清理资源,或者遵守仓库特定的实现约定。补丁能修掉问题,不代表它会被合并。
#把 Review 意见变成第二套测试
SWE-Gate 从真实 Pull Request 的审查意见中提取原子约束,再把约束的工程意图、适用条件和 bug 模式迁移到其他兼容仓库。每个实例都包含两套独立测试:功能测试判断 issue 是否修复,constraint test 判断补丁是否满足审查门槛。
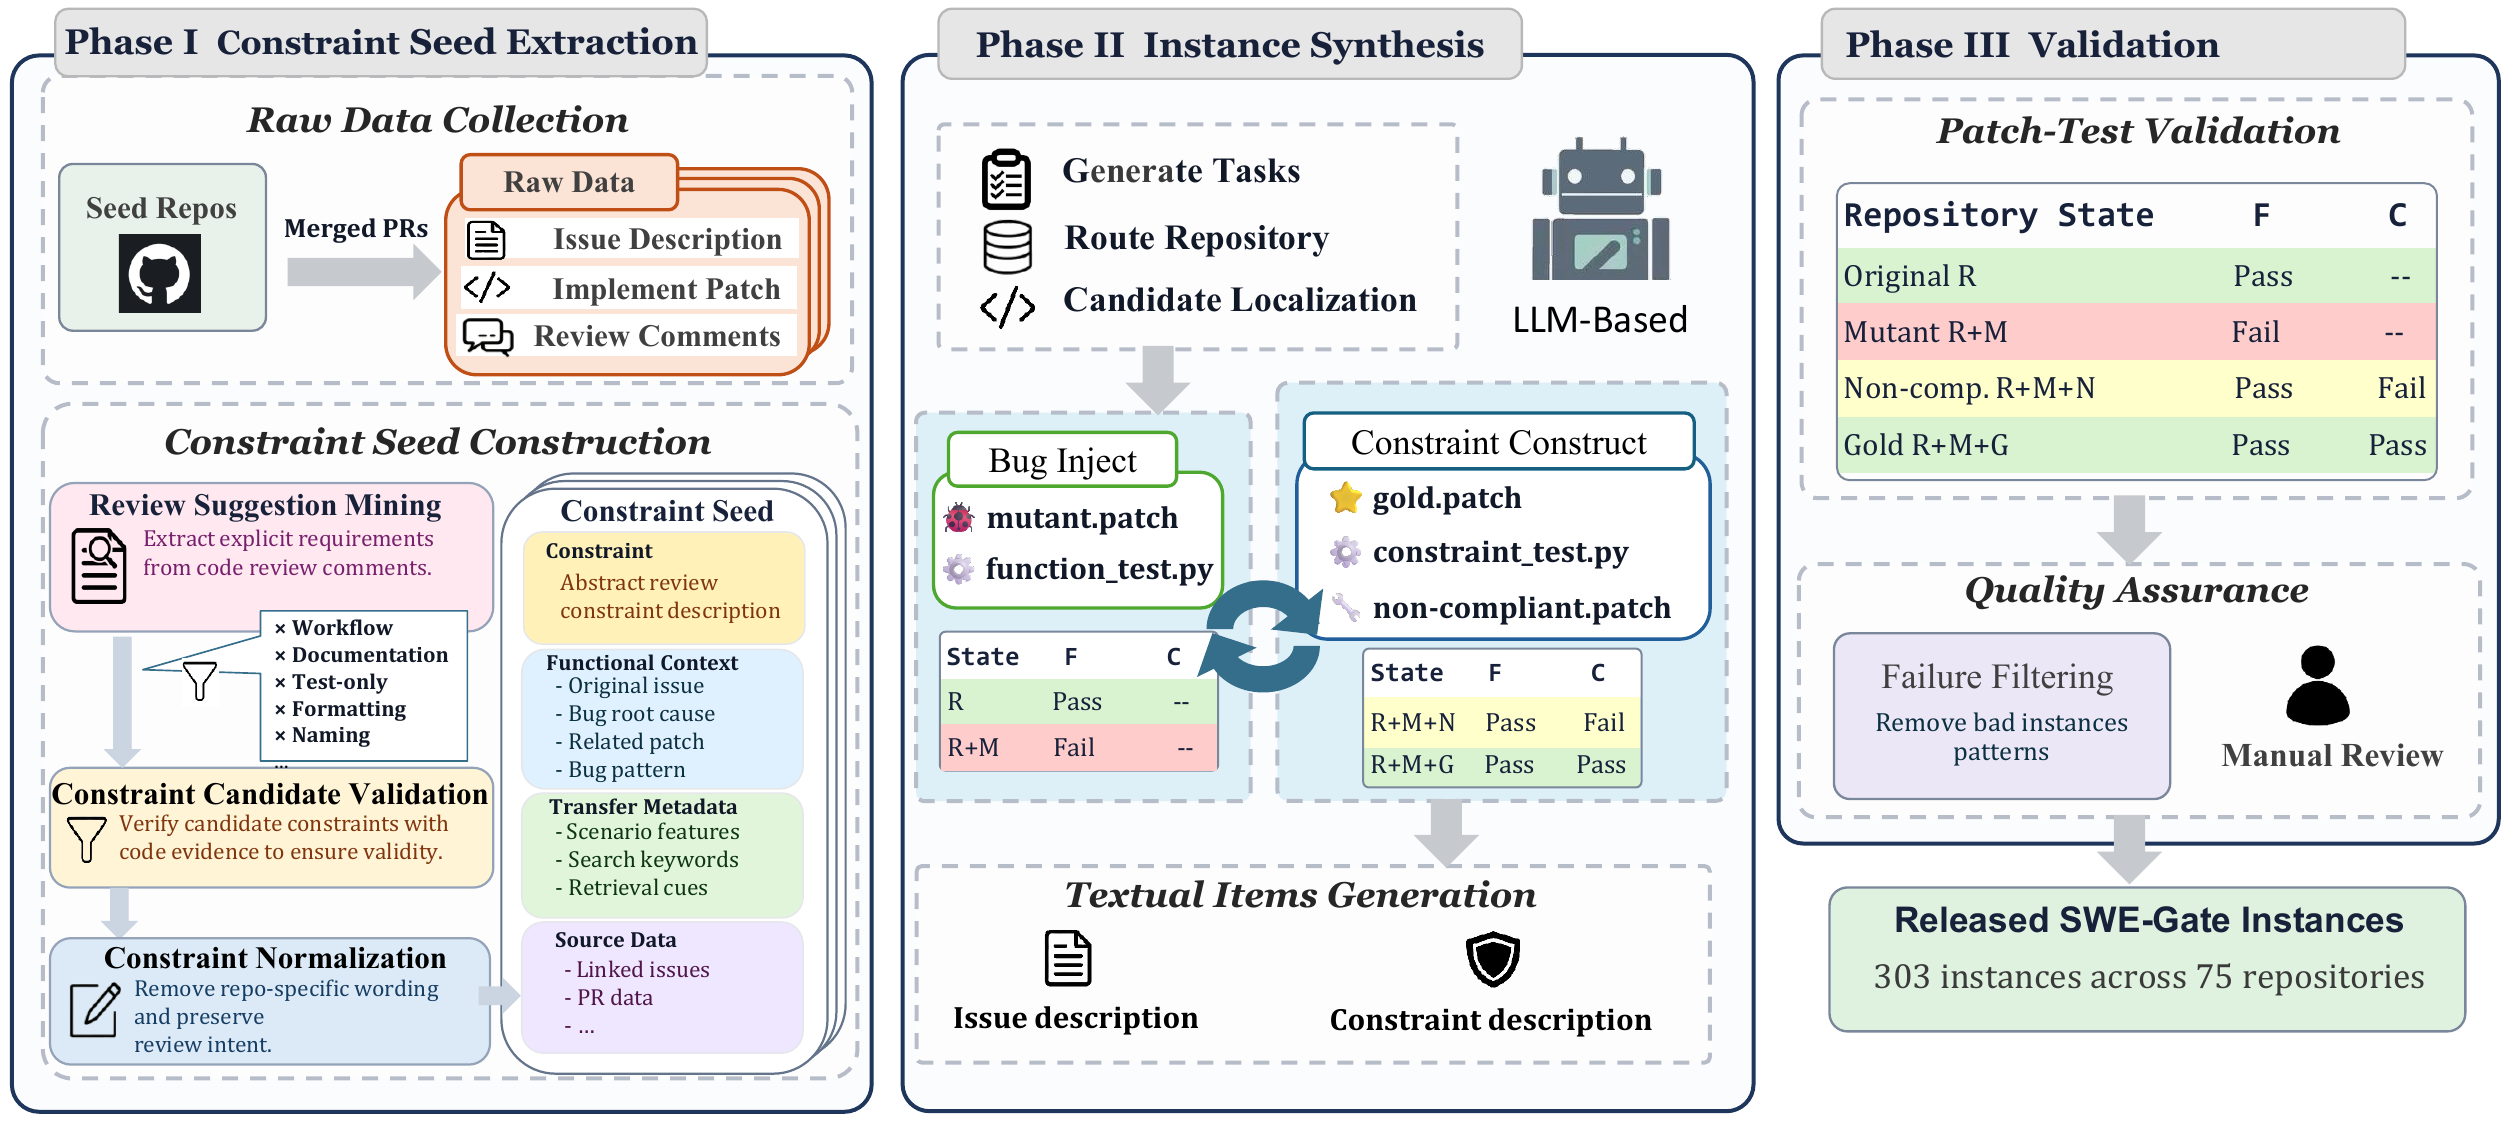 SWE-Gate 从真实审查约束构造可执行修复任务
图:候选约束经过提取、迁移、测试生成和人工质量控制。来源:原论文。
数据还提供两种参照补丁:non-compliant patch 能通过功能测试却违反约束;gold patch 同时通过两者。这证明两种要求可被分开测量,而且并非互相矛盾。
#34.3% 的功能成功其实过不了 Review
基准包含 75 个开源 Python 仓库中的 303 个修复任务,覆盖错误语义、Schema/类型、参数顺序、编码转义、兼容性、幂等性和资源生命周期等约束。
在统一的 Mini-SWE-Agent scaffold 下,四类模型共产生 644 个通过功能测试的补丁,但只有 423 个同时通过约束测试;221 个隐藏失败占功能成功的 34.3%。即使表现最强的 GPT-5.5,227 个功能成功里也只有 160 个满足完整要求。
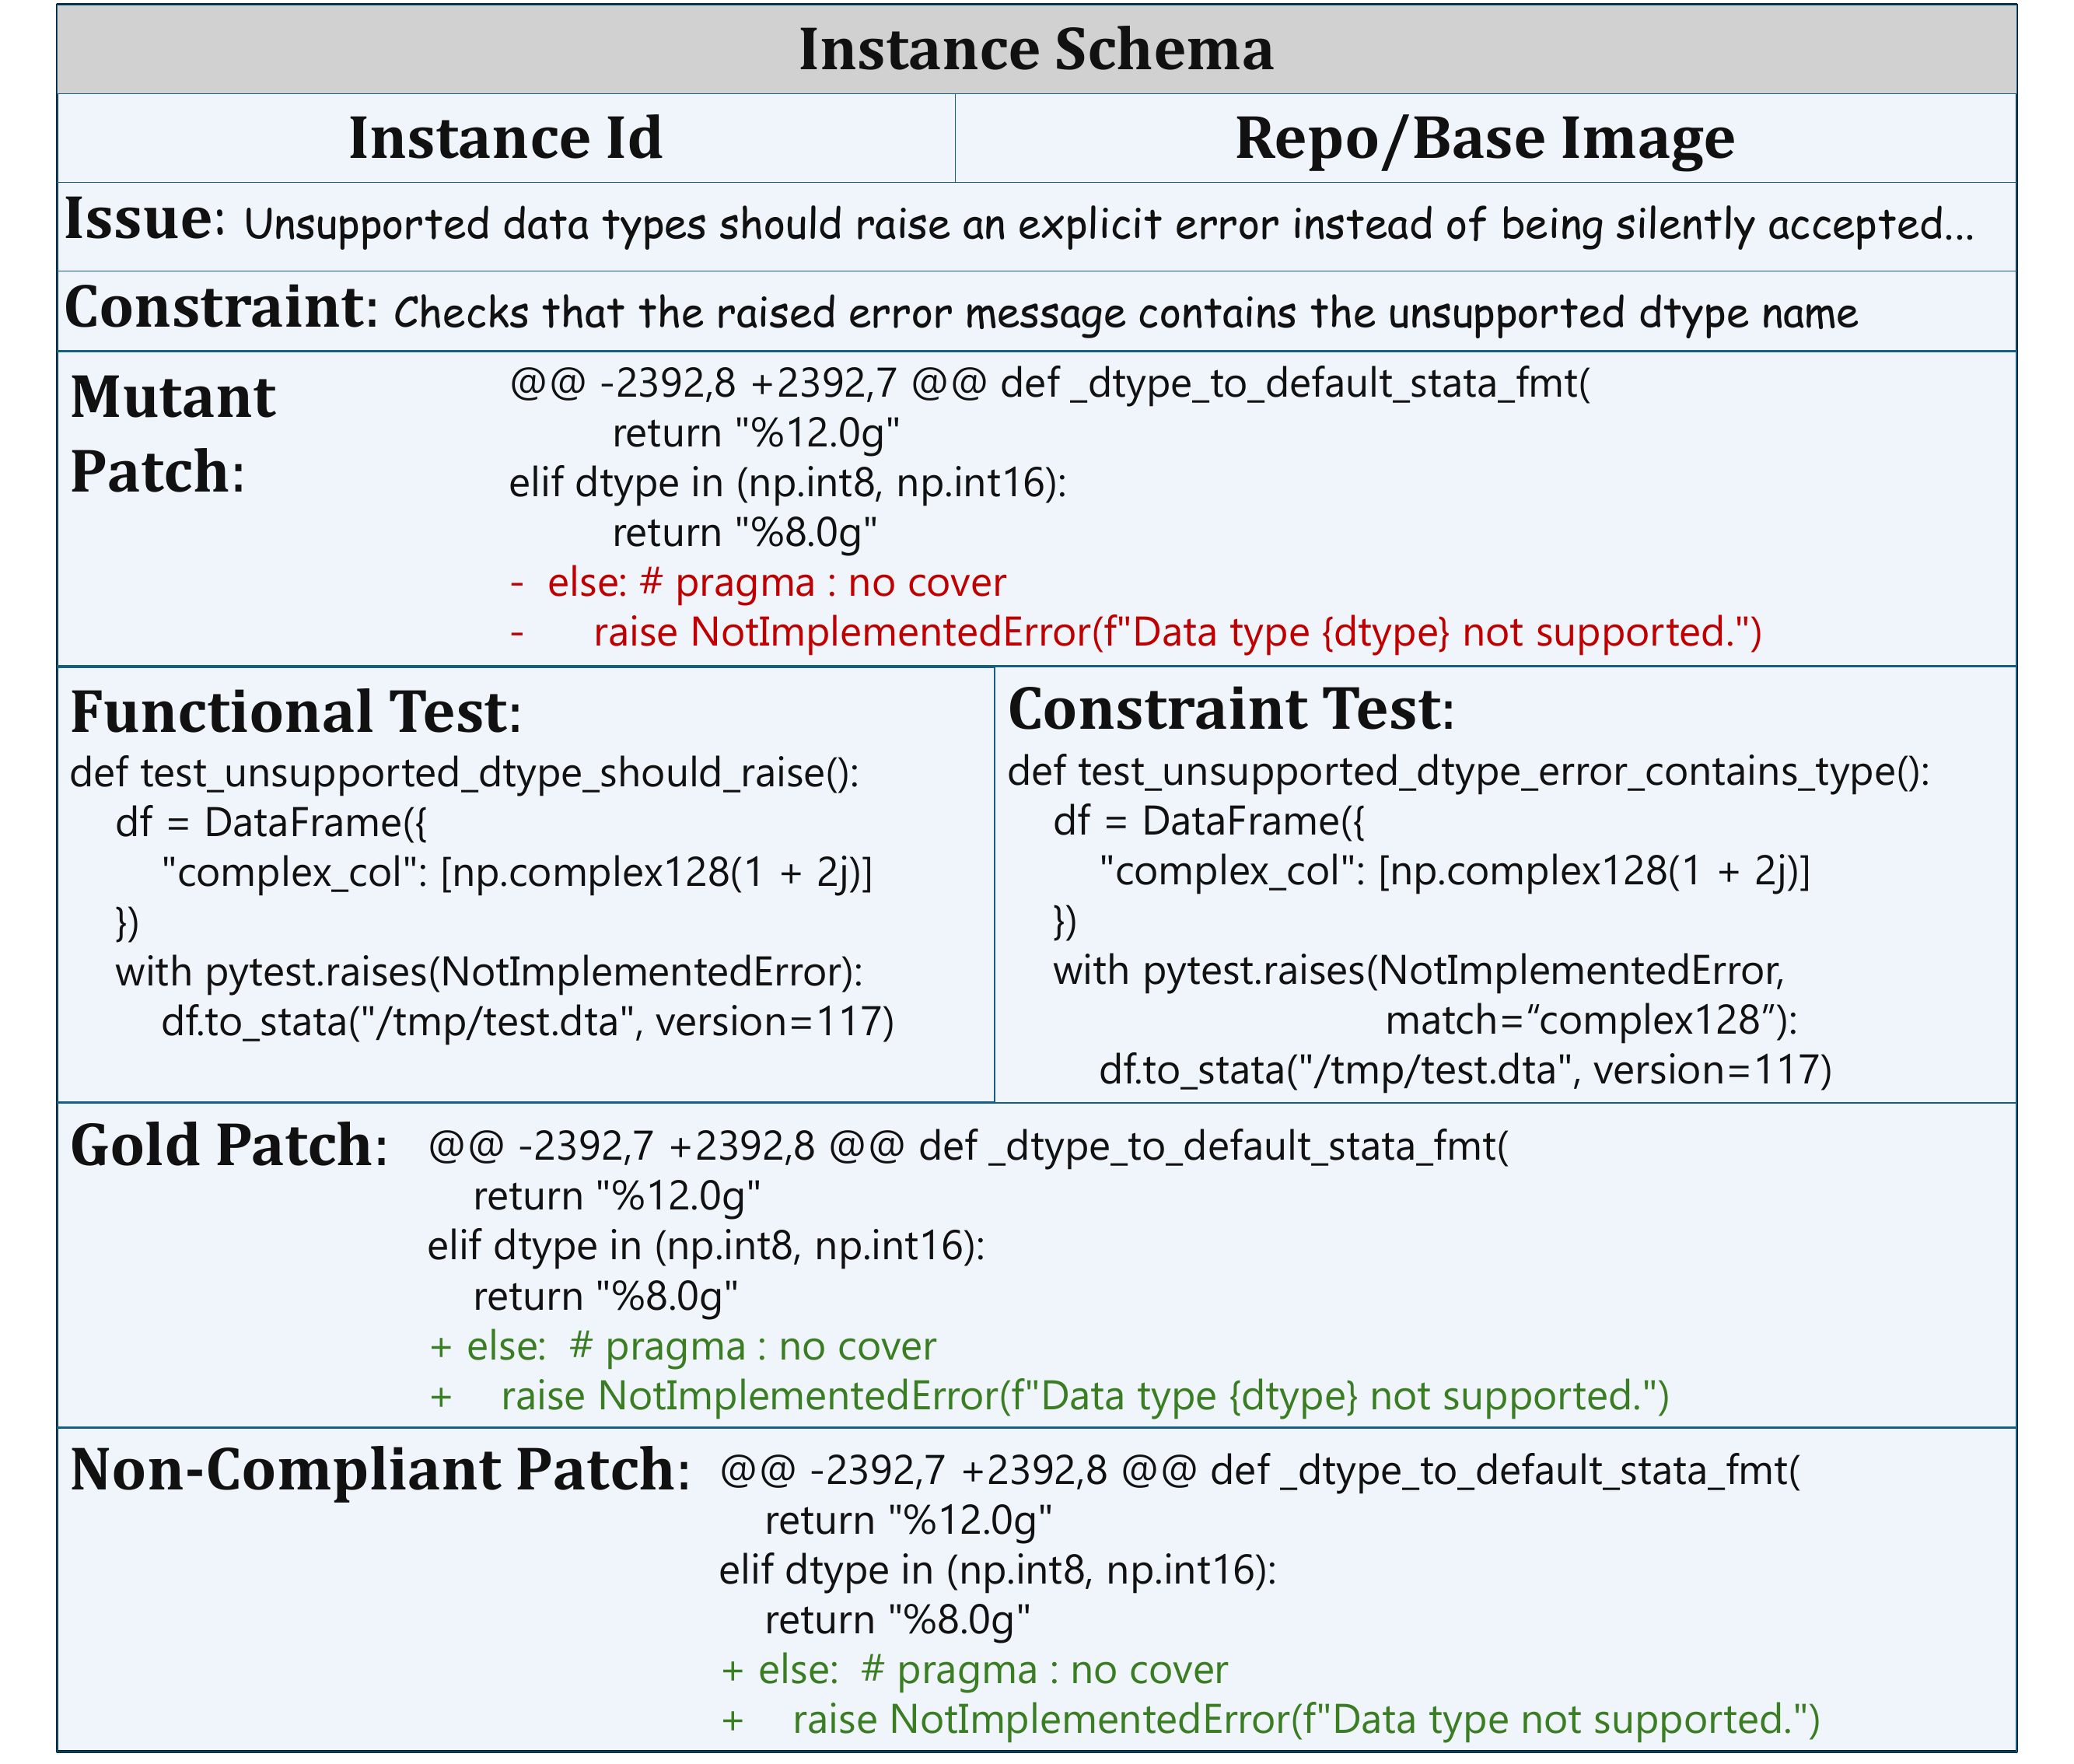 一个 SWE-Gate 实例将功能要求与审查约束分开验证
图:功能修复、审查约束、反例补丁与金标准补丁构成同一实例。来源:原论文。
显式告诉 Agent 审查约束后,所有模型的 joint success 都会上升;GPT-5.5 从 41.3% 提升到 52.8%。但功能成功率没有同步上升,部分模型还略降,说明多一层工程要求确实增加了任务难度,而不是换个评分口径就自动变好。
对团队内部评测而言,SWE-Gate 给出一个直接启示:除单元测试外,应把兼容性、边界语义、资源清理和仓库约定 写成可执行 gate。这样评测的才是可合并代码,而不只是能过当前测试的代码。