SWE-bench 能告诉你某个模型处理公开 GitHub Issue 的平均能力,却无法告诉你它是否适合公司的前端小改、跨仓迁移或内部框架。Warp 的 Factory Benchmarks 把评测对象从“模型”改成了完整的 工厂配置 :模型、Harness、提示词、Skills 和运行参数一起接受测试。
#基准任务来自真实工作
每个基准由三部分组成:从历史运行中挑出的任务、需要比较的工厂配置,以及正确性、质量、成本和效率等 Scorers。平台保存任务开始时的 Git 状态、完整对话、Agent 轨迹、PR 与生成产物,因此同一任务可以从原始状态重放,而不是拿一段脱离环境的 Prompt 做模拟测试。
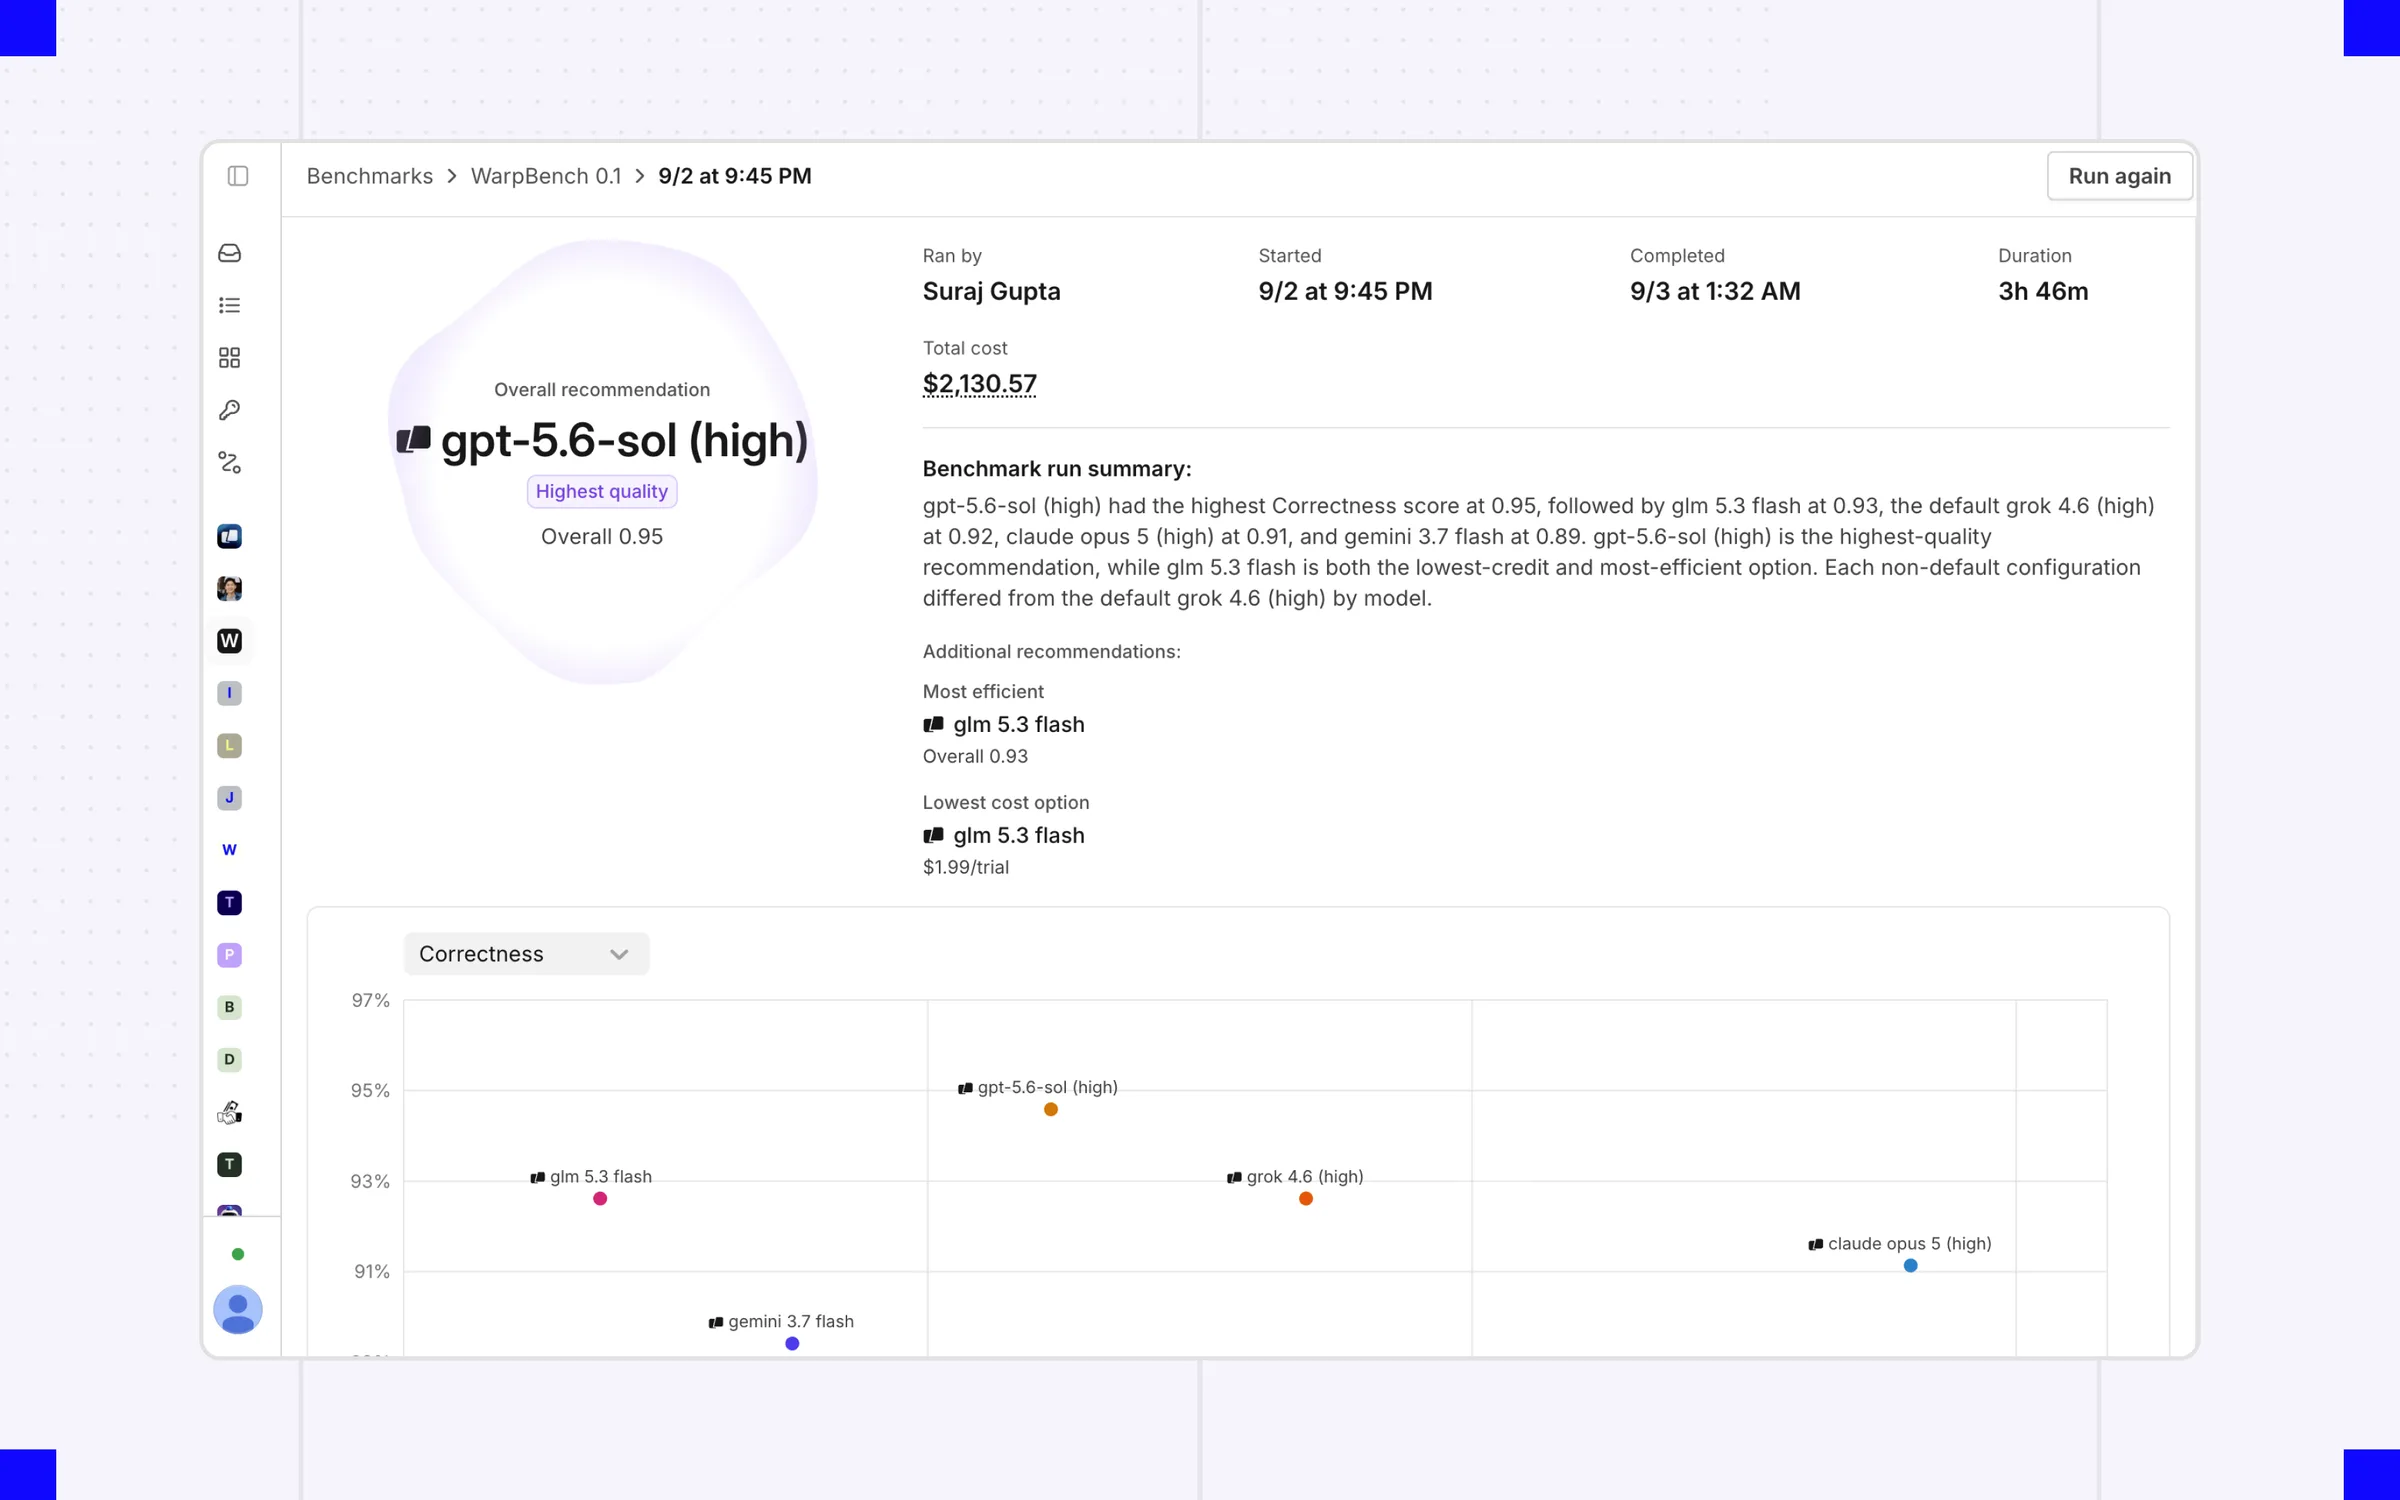 WarpBench 将真实任务、模型配置与多维评分组合成评测矩阵
这种做法最关键的不是界面,而是控制变量。模型能力、Harness 上下文管理和技能说明常常相互影响;只比较模型名称,很容易把 Harness 的优势误算成模型能力。
#把配置写进代码,才能重放
Warp 用 factory.yaml 和 Agent 定义记录完整配置。评测会执行“任务 × 配置 × 重复次数”的矩阵,再用统一 Scorer 逐项评分。重复运行很重要,因为 Agent 输出有随机性,单次成功或失败不足以支撑路由决策。
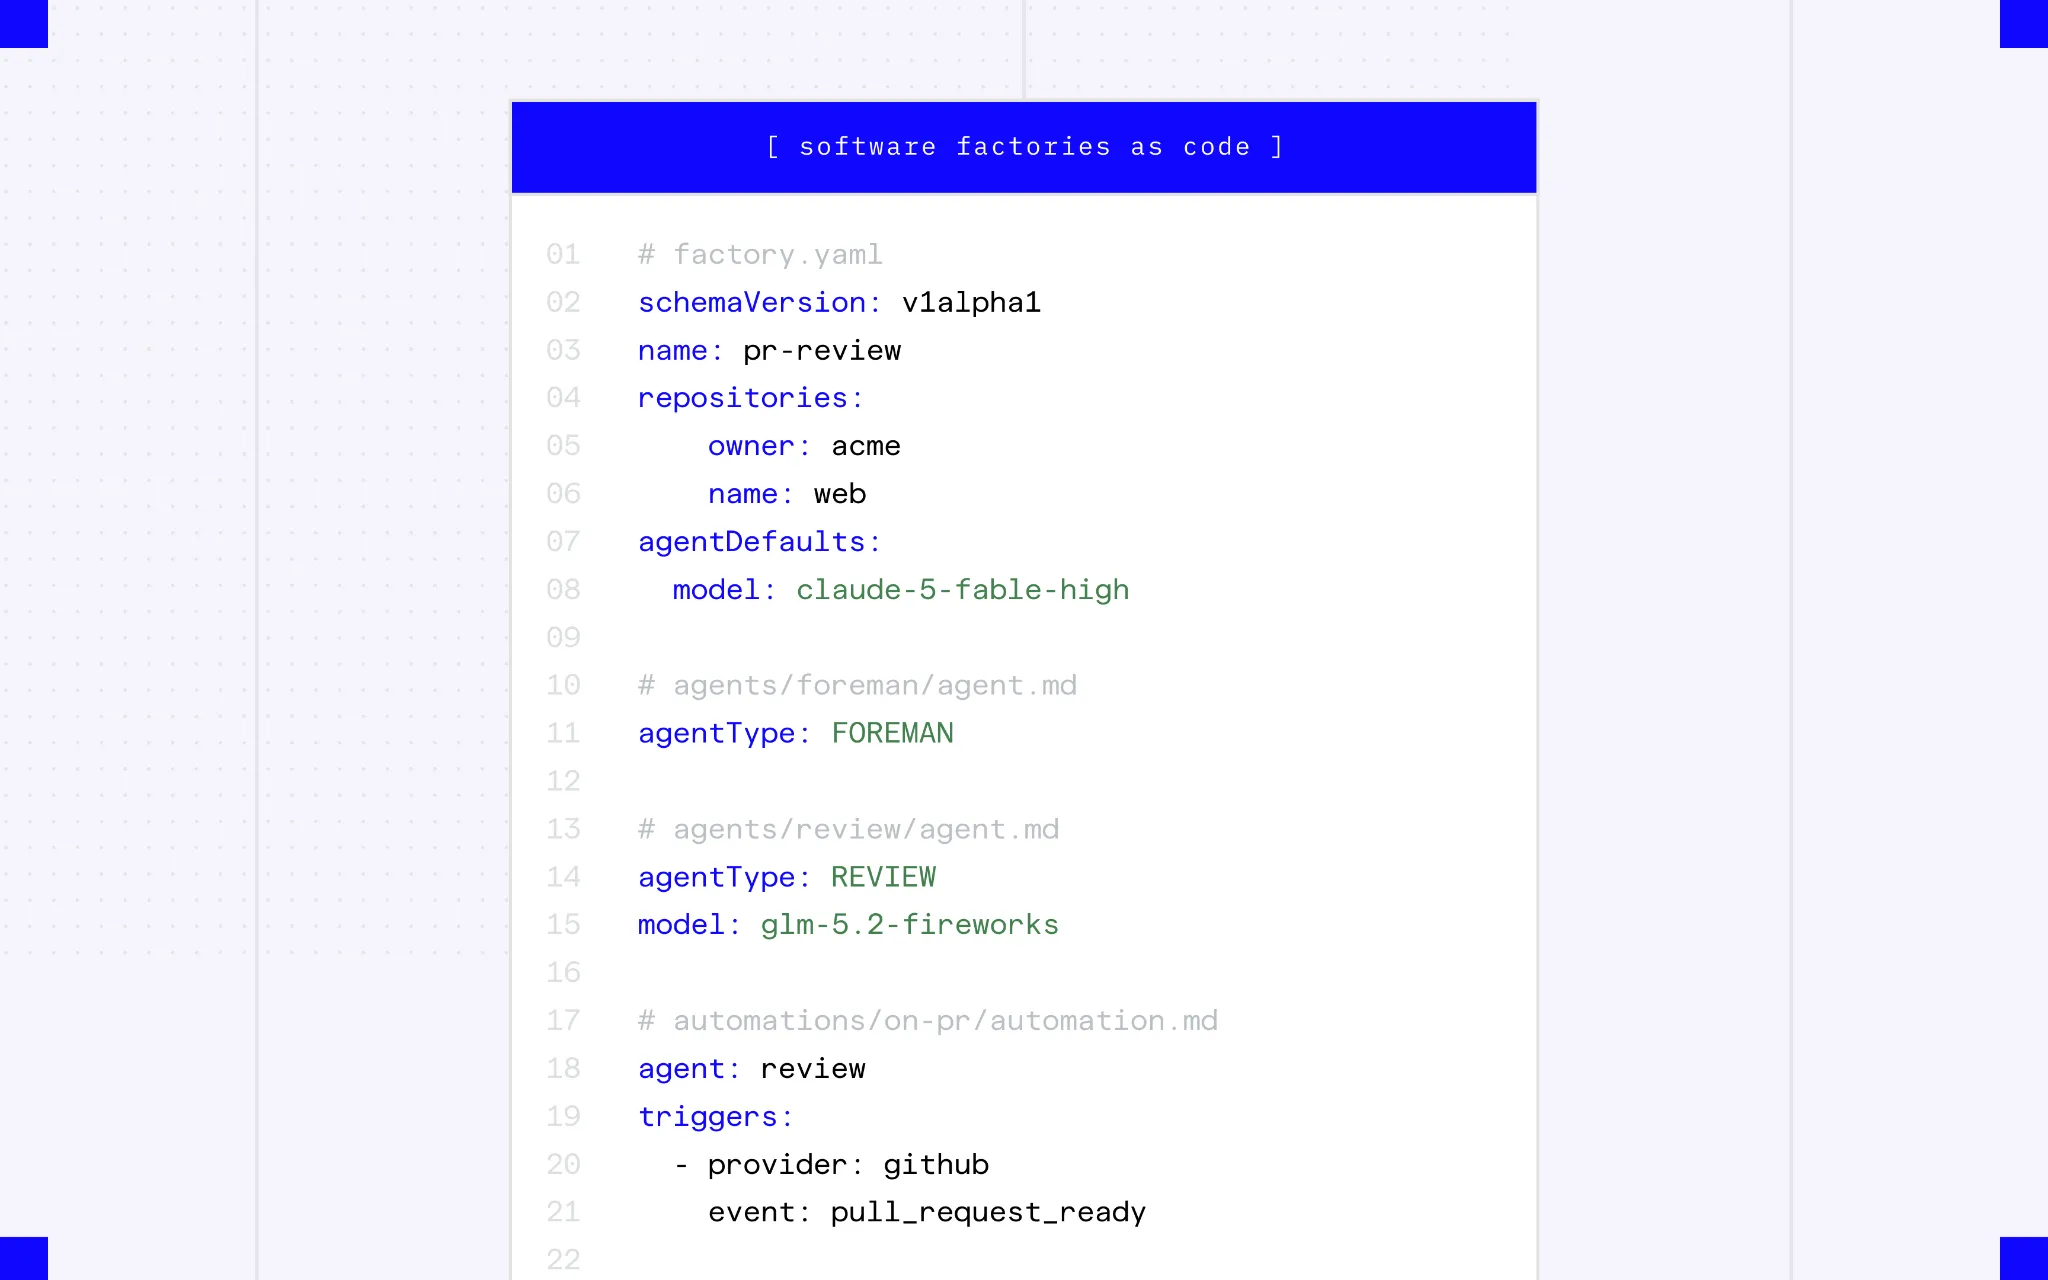 工厂配置以 YAML 记录,便于分支、重放与 A/B 测试
平台还允许 Foreman 从历史轨迹中按条件挑任务,例如找到代码改动少于 50 行的 UI 任务,自动形成测试集。评测集因此可以跟着业务分布演化,而不是长期停留在一批越来越不代表生产环境的静态题目上。
#评测最终要改变路由
Warp 展示的内部案例中,团队基于 WarpBench 调整配置,让部分任务的成本降低约 63%,同时没有观察到质量下降。结果还可以转成分类器驱动的模型路由:识别任务类型后,选择在该类任务上处于成本—质量 Pareto 前沿的配置。
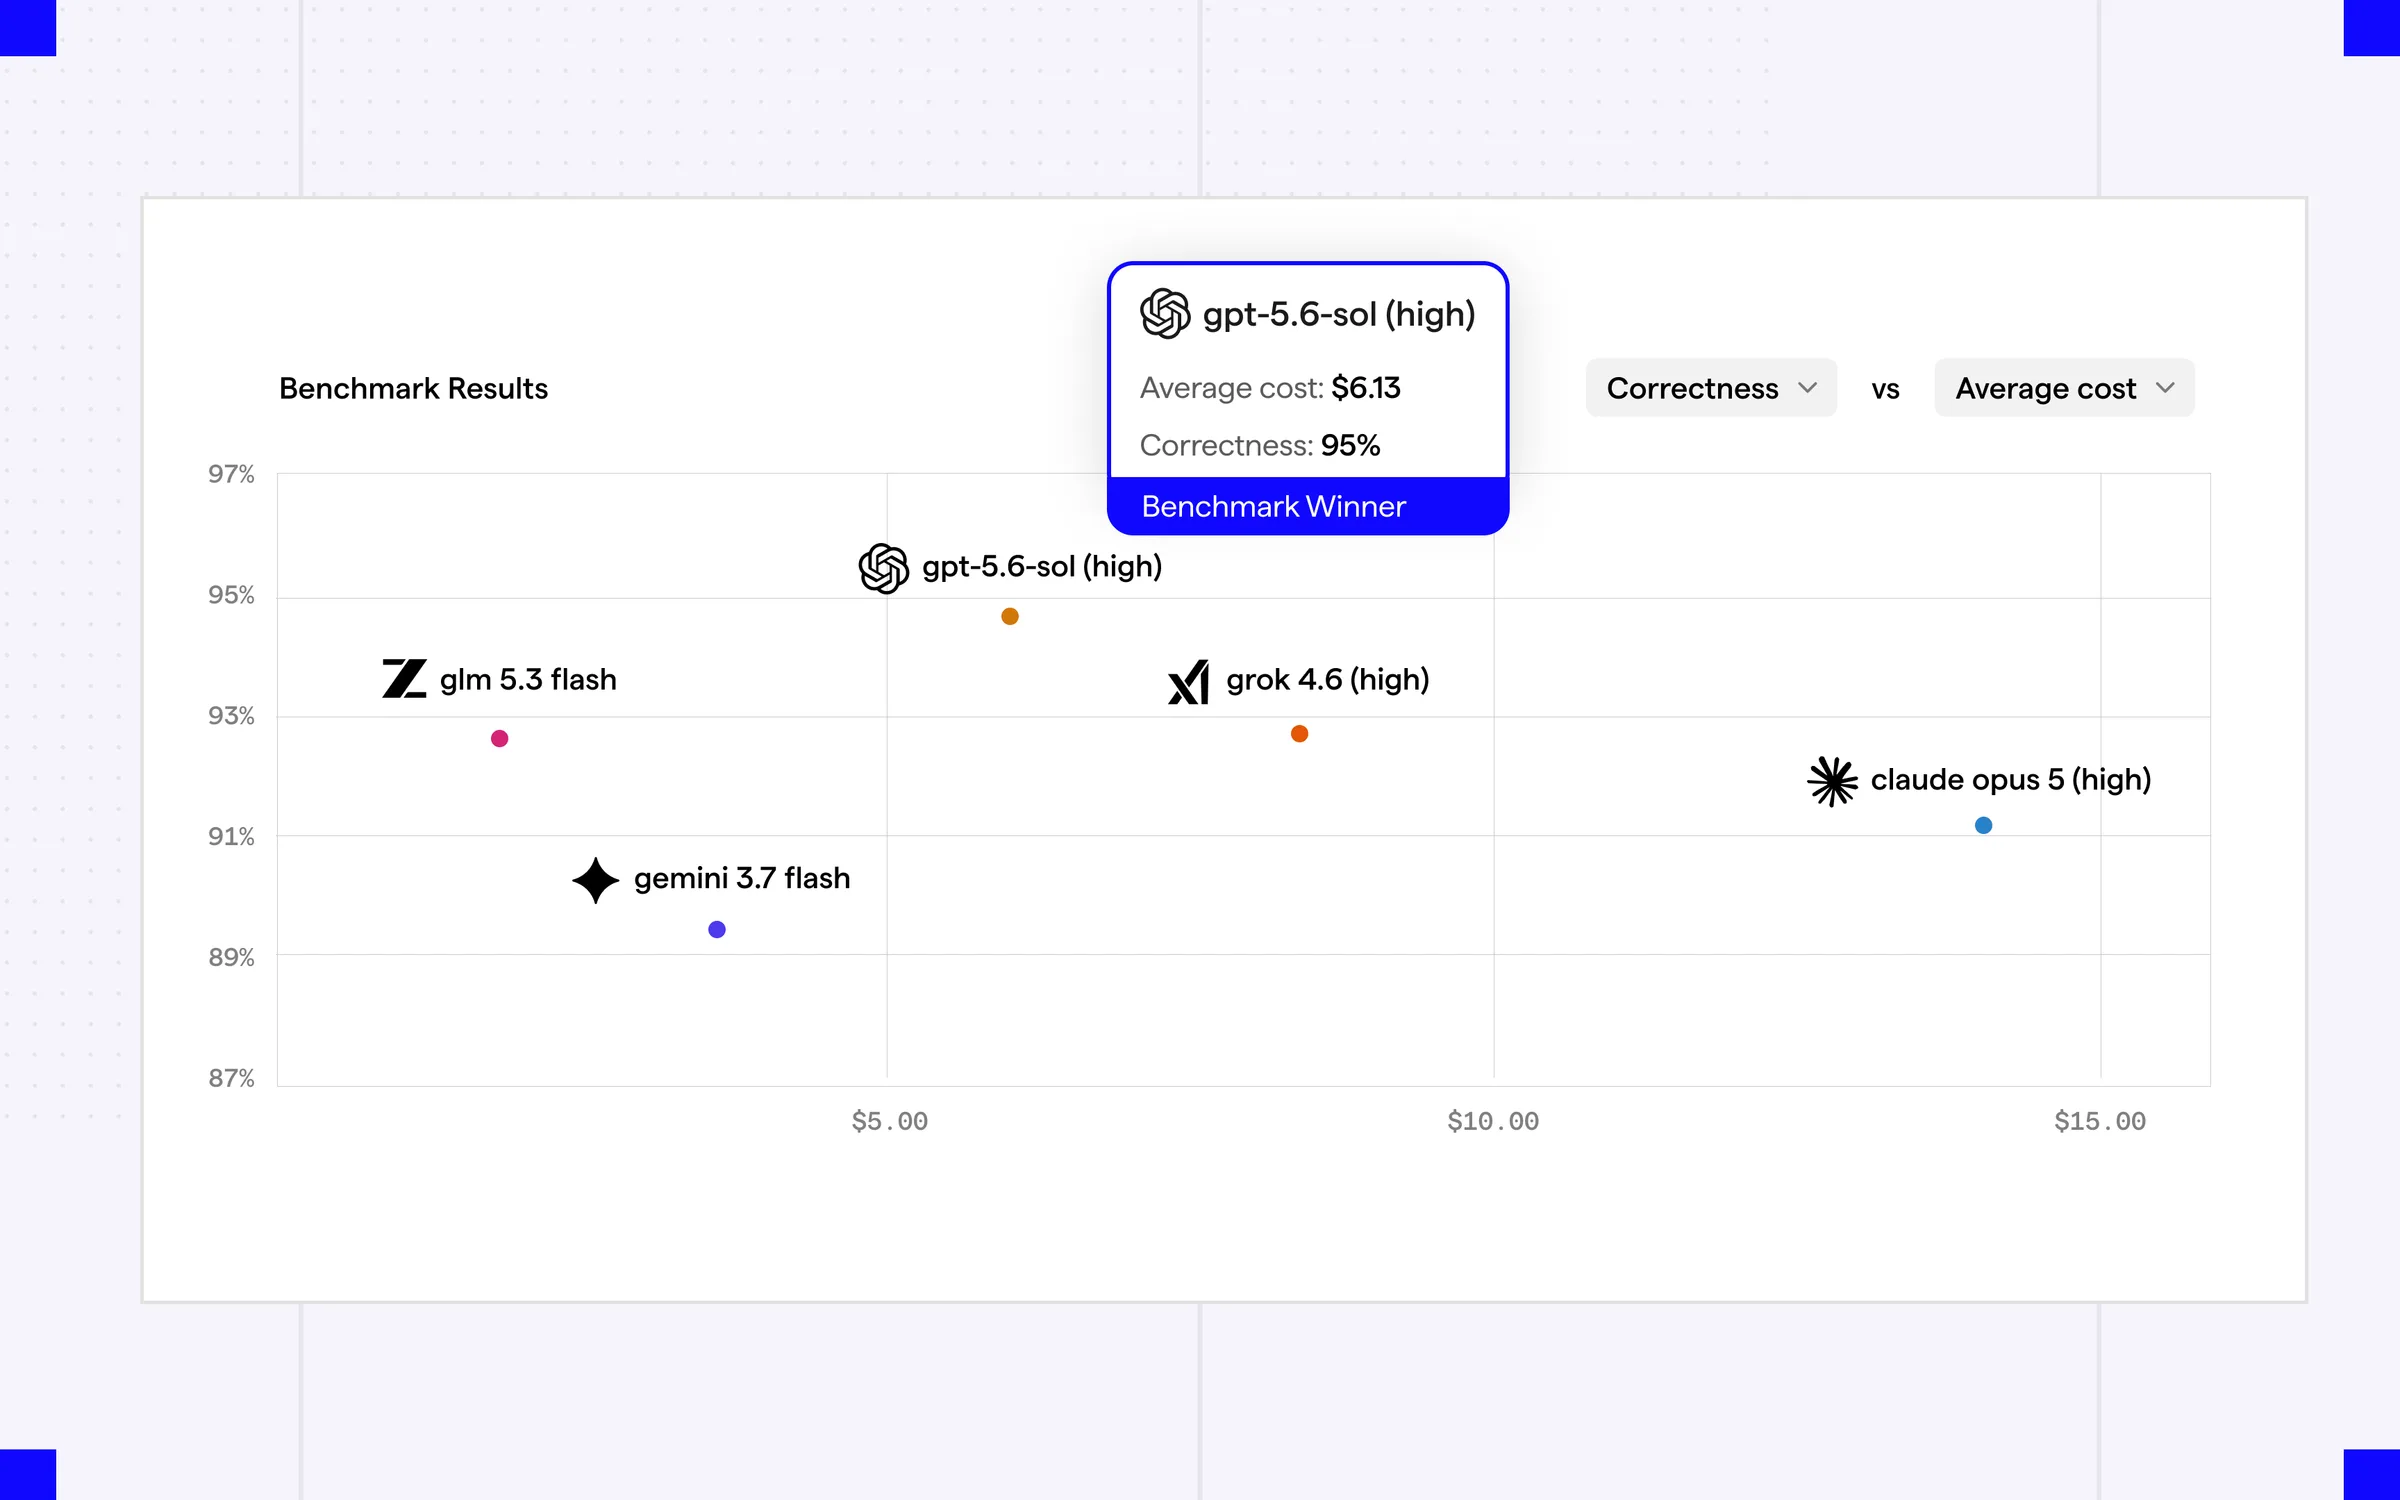 不同模型配置的成本与质量需要放在同一条 Pareto 前沿上比较
这里也有明确边界。LLM-as-a-judge 仍可能偏向某种表达风格,昂贵基准不适合每次提交都跑,历史任务还可能泄漏到训练数据中。可靠做法是把确定性测试、代码检查、人工抽检和模型裁判组合起来,并在模型、Prompt、Skill 或 Harness 发生实质变化时重跑。
Factory Benchmarks 真正改变的是优化单位:团队不再追逐“最强模型”,而是持续寻找 最适合某类真实任务的完整执行配置 。