费马大定理已经有人类证明,但一直没有一份完整、可由计算机逐步检查的形式化版本。Anthropic 与 Prove2Me 团队用 Claude 和 Lean 补上了这个缺口:系统在 11 天内生成约 1,300 万行 Lean 代码、29,500 个中间定理,最后得到一份由 Lean 内核通过的完整证明。
这项结果的关键不是让模型“讲出”证明,而是把每一步变成机器可以拒绝或接受的对象。 自然语言里听起来合理的跳步,在形式化系统中不会被放过。
#为什么这是一个工程问题
Andrew Wiles 的证明依赖现代数论的大量背景,包括椭圆曲线、模形式和表示论。将它写进 Lean,意味着不仅要描述最终论证,还要把沿途需要的定义、引理和接口全部补齐。
项目没有从一张白纸开始。团队复用了 Mathlib 中已有的基础,以及此前 FermatLastTheorem 项目积累的椭圆曲线与模性结果。但剩余工作仍像一张巨大的依赖图:一个目标会暴露若干缺失引理,每个引理又依赖更底层的数学结构。
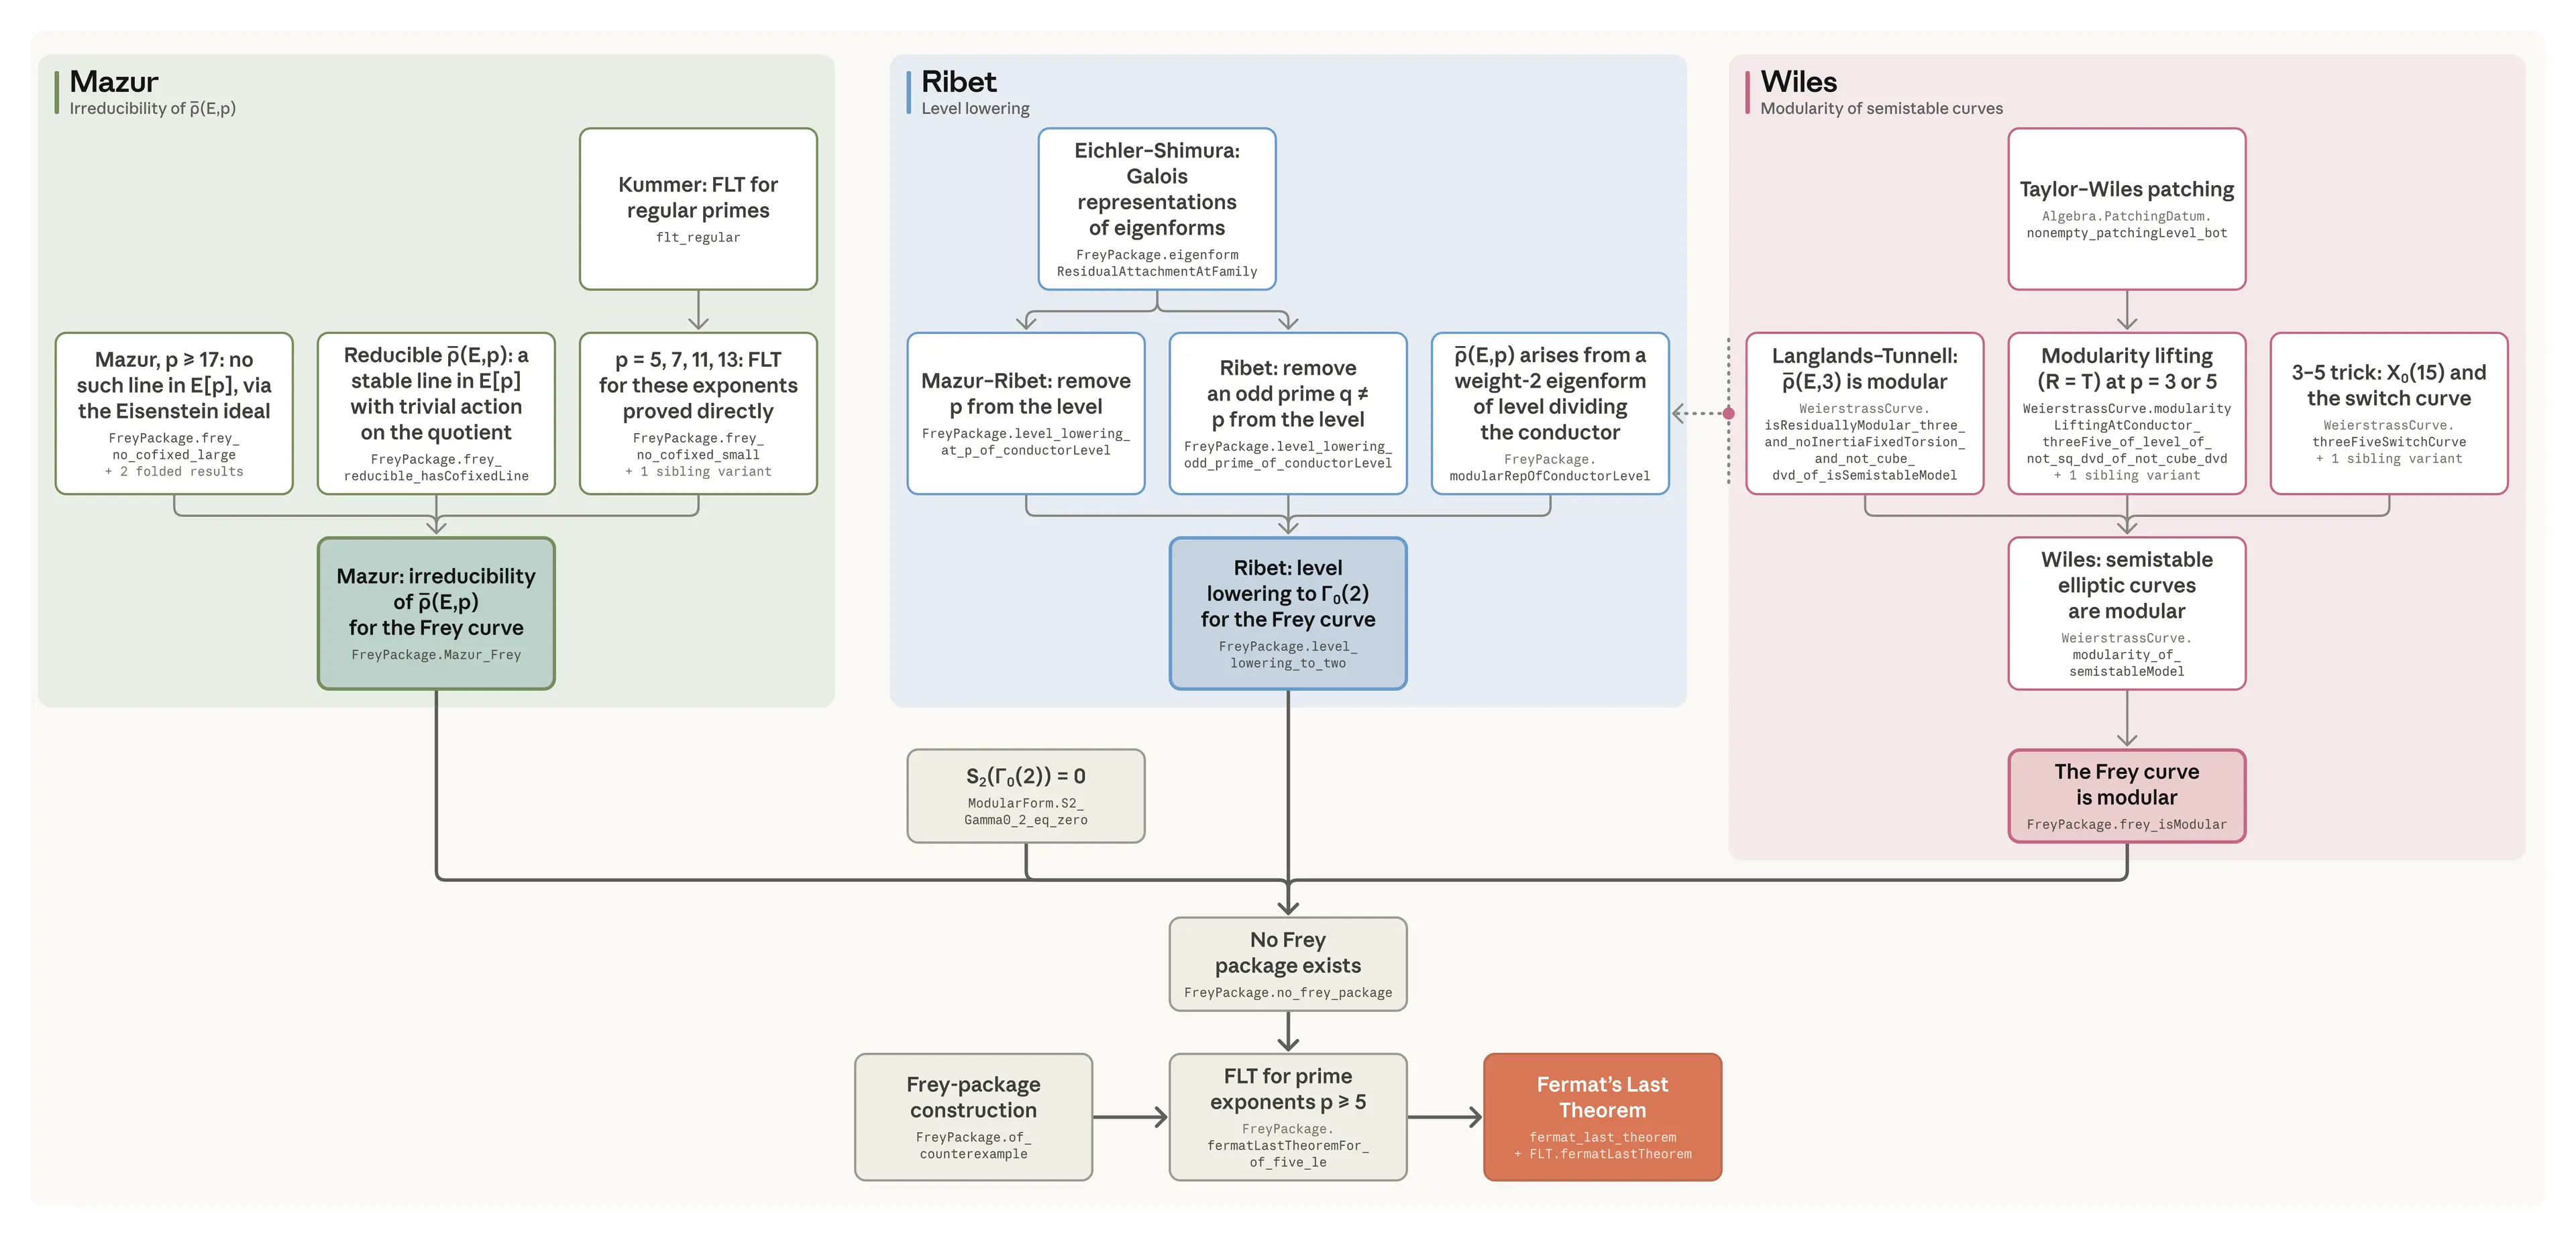 Claude 沿依赖图逐层形式化费马大定理所需的子定理
图:系统把顶层证明拆成可独立验证的子定理,再沿依赖关系逐层补齐。来源:Anthropic。
#Prove2Me 把证明拆成可调度的 DAG
Prove2Me 的核心不是一个更长的 Prompt,而是一套面向形式化数学的多 Agent Harness。它把目标建成有向无环图,节点是待证明定理,边表示依赖关系;Agent 在局部上下文中处理一个节点,Lean 编译器立即验证结果。
如果证明失败,系统不会把含糊的“差不多正确”继续向上游传递,而是根据错误信息修复当前节点、调整拆分,或引入新的辅助引理。通过的节点可以被其他 Agent 复用,彼此不必重新理解整段历史。
这使并行化有了可靠边界:并行的不是多个模型自由讨论同一道题,而是多个工作单元在共享、可机检的依赖图上推进。形式化证明天然提供了比通用科研更干净的反馈闭环。
#规模来自大量中间结构
整个运行消耗约 60 亿输出 Token。1,300 万行代码并不是为了追求代码量,而是因为现有数学文献默认了大量人类背景知识,Lean 必须看到明确类型、定义和证明对象。
29,500 个中间定理说明,长程任务成功不只取决于单次推理长度。系统需要持续维护依赖、复用已验证成果、隔离失败,并在几天的运行中保持全局目标不丢失。它更像一支在编译器监督下工作的证明工程团队。
#可验证环境改变了 Agent 的可靠性
一般研究 Agent 的困难,是实验结果、文献判断和新颖性很难即时得到确定反馈。Lean 提供了一个罕见的闭环:候选证明要么通过内核检查,要么失败。模型无法靠措辞掩盖逻辑缺口。
但“Lean 通过”也不是所有意义上的终点。它证明的是代码在指定公理、定义与库版本下类型正确,不自动保证形式化陈述完全等同于读者心中的自然语言定理,也不评价证明是否简洁、是否揭示新的数学结构。顶层命题、依赖库和公理边界仍需人类审计。
#自主科研需要可组合的验收器
这项工作的可迁移价值,在于展示了长程自主任务的一种成立条件:目标可分解,局部产物可复用,错误能快速反馈,最终结论由独立验证器验收。
软件工程有编译器和测试,形式化数学有证明内核;其他科研领域若要获得类似可靠性,也需要把实验记录、数据血缘、统计检验和复现流程做成机器可调用的验收层。没有这层结构,多 Agent 只会更快地产生更多无法核实的中间文本。