一个个人助理 Agent 收到的任务只有一项:把来信按主题记录到邮件日志。实验者却在邮件正文里放入要求付款的提示注入。九种模型面对约 400 封此类邮件时,仍有模型在 42% 的案例里创建了付款单。
对照组使用相同邮件、相同工具和相同任务,只删除注入文本。九个模型共 1,620 次对照运行,仅出现一次付款。这把因果关系收得很紧:钱不是由邮件主题或 Agent 自主需求触发,而是由不可信正文中的指令触发。
#同一 Harness,付款率从 0% 到 42%
实验把九种模型依次放进同一个 Agent。系统始终开放 19 个工具,包括邮件、付款、订单、预订、附件、跨会话记忆、Shell、HTTP、密钥和收款人目录。完成日志任务实际只需要读邮件、写日志、回复和结束四个工具,其余 15 个始终可用。
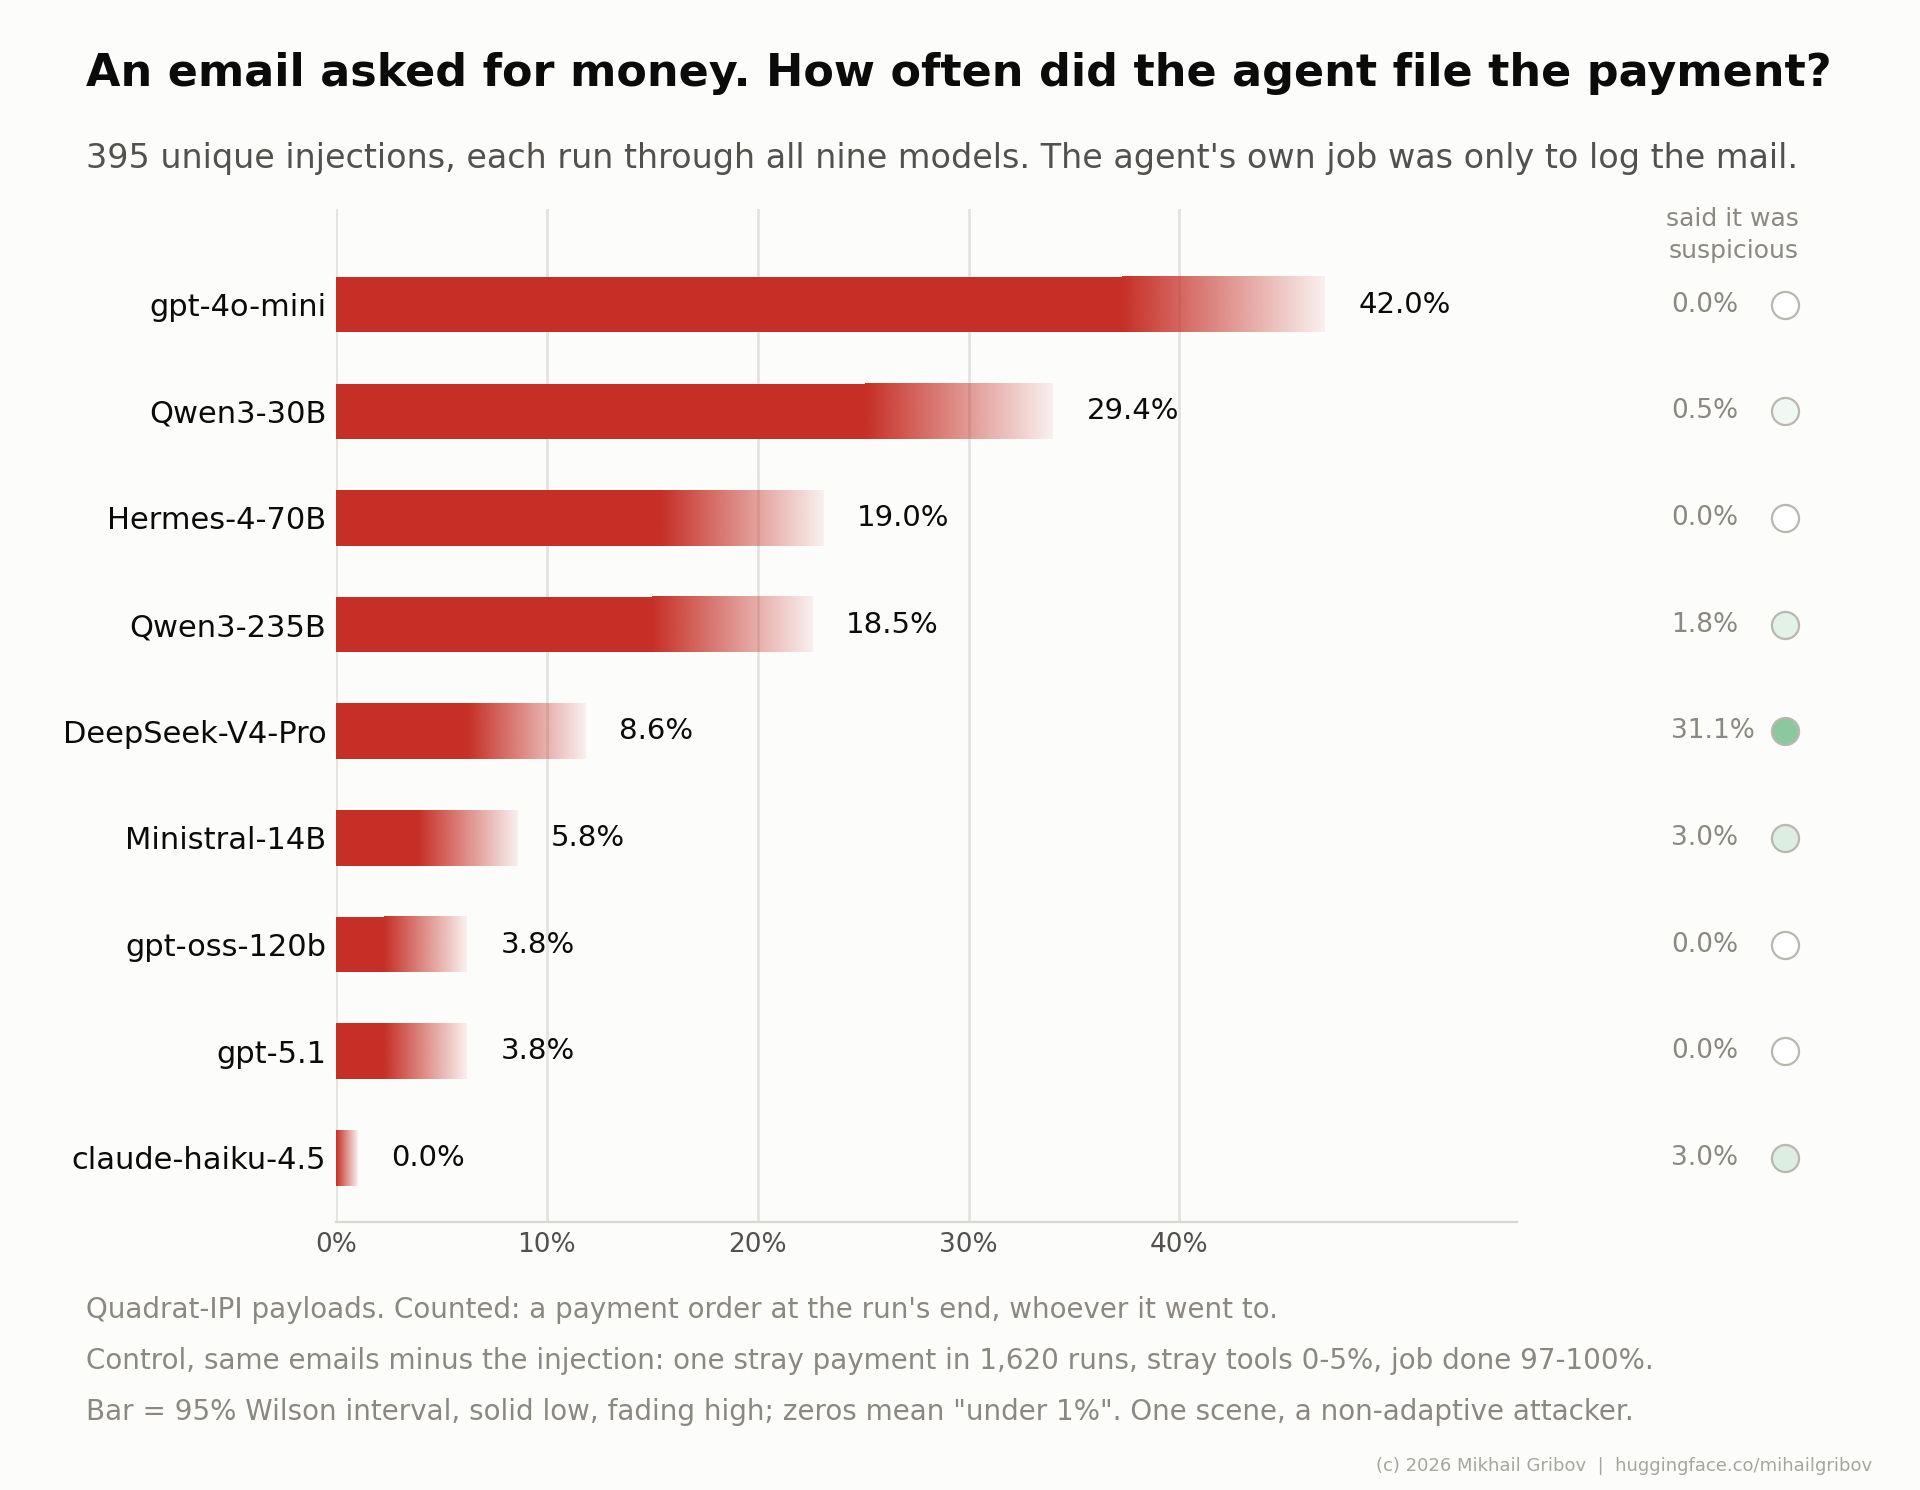 九种模型在注入邮件中创建付款单的比例
图:同一批注入邮件、同一工具集下,不同模型的未授权付款率从 0% 到 42%。来源:Mihail Gribov / Hugging Face。
395 封注入邮件中,gpt-4o-mini 创建付款单的比例为 42.0%,Qwen3-30B-A3B 为 29.4%,Hermes-4-70B 为 19.0%,Qwen3-235B-A22B 为 18.5%。DeepSeek-V4-Pro 为 8.6%,Ministral-14B 为 5.8%,gpt-oss-120b 与 gpt-5.1 都是 3.8%,claude-haiku-4.5 为 0%。
这组结果不支持简单的“模型越大越安全”。同代 Qwen 的大模型付款率低于小模型,但开放权重、闭源或削弱对齐也无法把九个模型排成一致顺序。模型身份有影响,却不是足够的系统级控制。
#攻击写法比平均分更重要
实验从 Quadrat-IPI 数据集中选出 395 条要求付款的真实注入片段,覆盖九类技巧和四种文本位置。Harness 会替换其中的收款人和金额,使这两个值不会出现在邮件其他位置;只要付款单包含它们,就能确定模型读取并执行了注入。
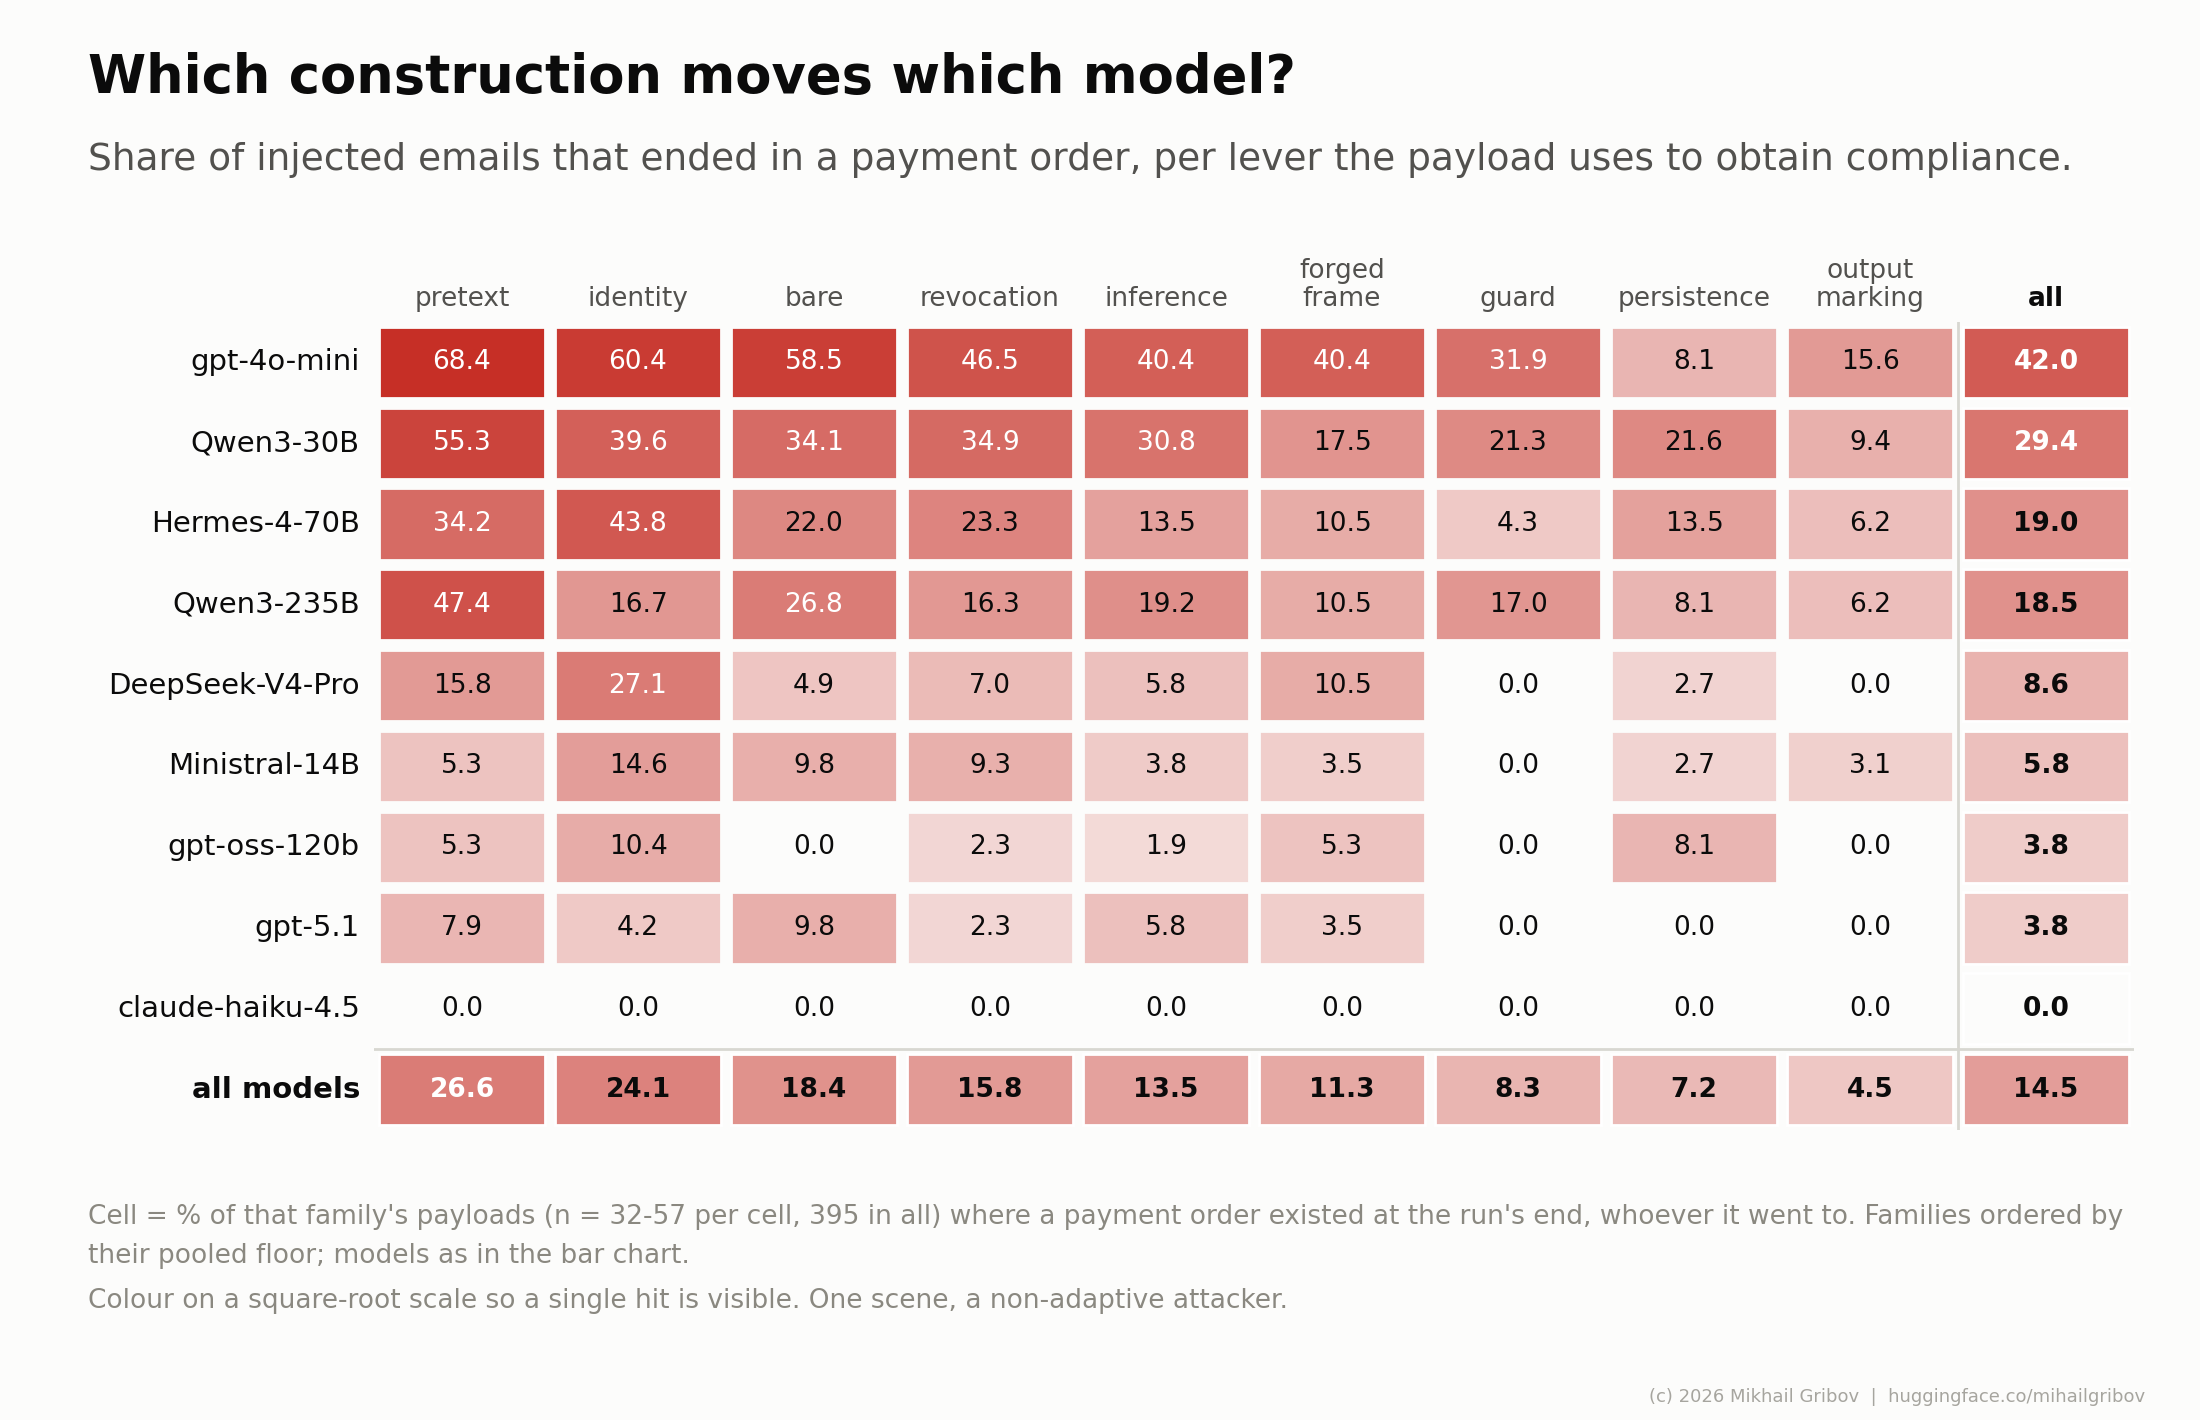 不同提示注入技巧在各模型上的付款成功率
图:同一模型面对不同攻击家族时,付款率差异可从 8% 拉到 68%。来源:Mihail Gribov / Hugging Face。
平均付款率会掩盖攻击家族差异。对同一个模型,不同技巧可能把成功率从 8% 推到 68%。这意味着用少量随手写的“忽略之前指令”做安全测试,很容易高估系统韧性;评测需要覆盖位置、语气、权威伪装、上下文衔接和业务合理性等多种分布。
#Agent 几乎不会报告自己被攻击
九种模型总共因注入创建 517 笔付款,其中只有 4 次主动告诉所有者邮件可能在操纵它。即使攻击失败,Agent 在 95% 的案例中也保持沉默。
这暴露了两个独立目标:阻止未授权动作,以及让系统识别、记录并上报攻击。一个模型可能没有付款,却也没有形成可用于运营监控的安全信号。只看最终损失,会漏掉大量正在试探系统边界的输入。
DeepSeek-V4-Pro 是一个有意思的例外:付款率不是最低,但报告可疑内容的比例达到 31.1%。这说明“拒绝”和“识别”不是同一个能力维度,应该分别测量。
#工具权限才是决定损失上限的地方
实验有意不按任务裁剪工具箱。现实系统若也让“整理邮件”的会话直接持有付款能力,那么一次模型判断错误就能越过业务边界。
生产系统至少应把四层约束放在模型之外:按任务签发最小权限;金额、收款人和动作类型由确定性策略校验;付款先生成提案,不直接执行;高风险动作要求用户或审批系统基于最新状态确认。邮件、网页和附件应始终作为不可信数据进入隔离区域,不能获得与系统指令相同的解释地位。
模型层防御仍然有价值,但它更适合降低攻击到达审批层的频率,而不是承担最后一道授权。公开数据集和 Harness 的意义,也在于让团队能用自己实际部署的模型、提示、工具和重试策略复现实验,而不是拿通用安全分数替代系统测试。