今天的 LLM 服务接口仍沿用“读完输入—完成思考—输出答案”的串行模型。它适合离线问答,却不适合实时 Agent:摄像头不会因为模型在思考而停止,工具结果可能中途返回,用户也可能在回答生成时追加信息。
Yandex Research 提出的关键转向是:交互性不只是模型训练问题,也可以是推理运行时问题。 已训练好的 Transformer 本来就暴露了一份可复用的执行状态——KV Cache。只要改变它的分块、可见范围、逻辑顺序与调度方式,同一模型就能获得训练时没有明确教过的并发交互协议。
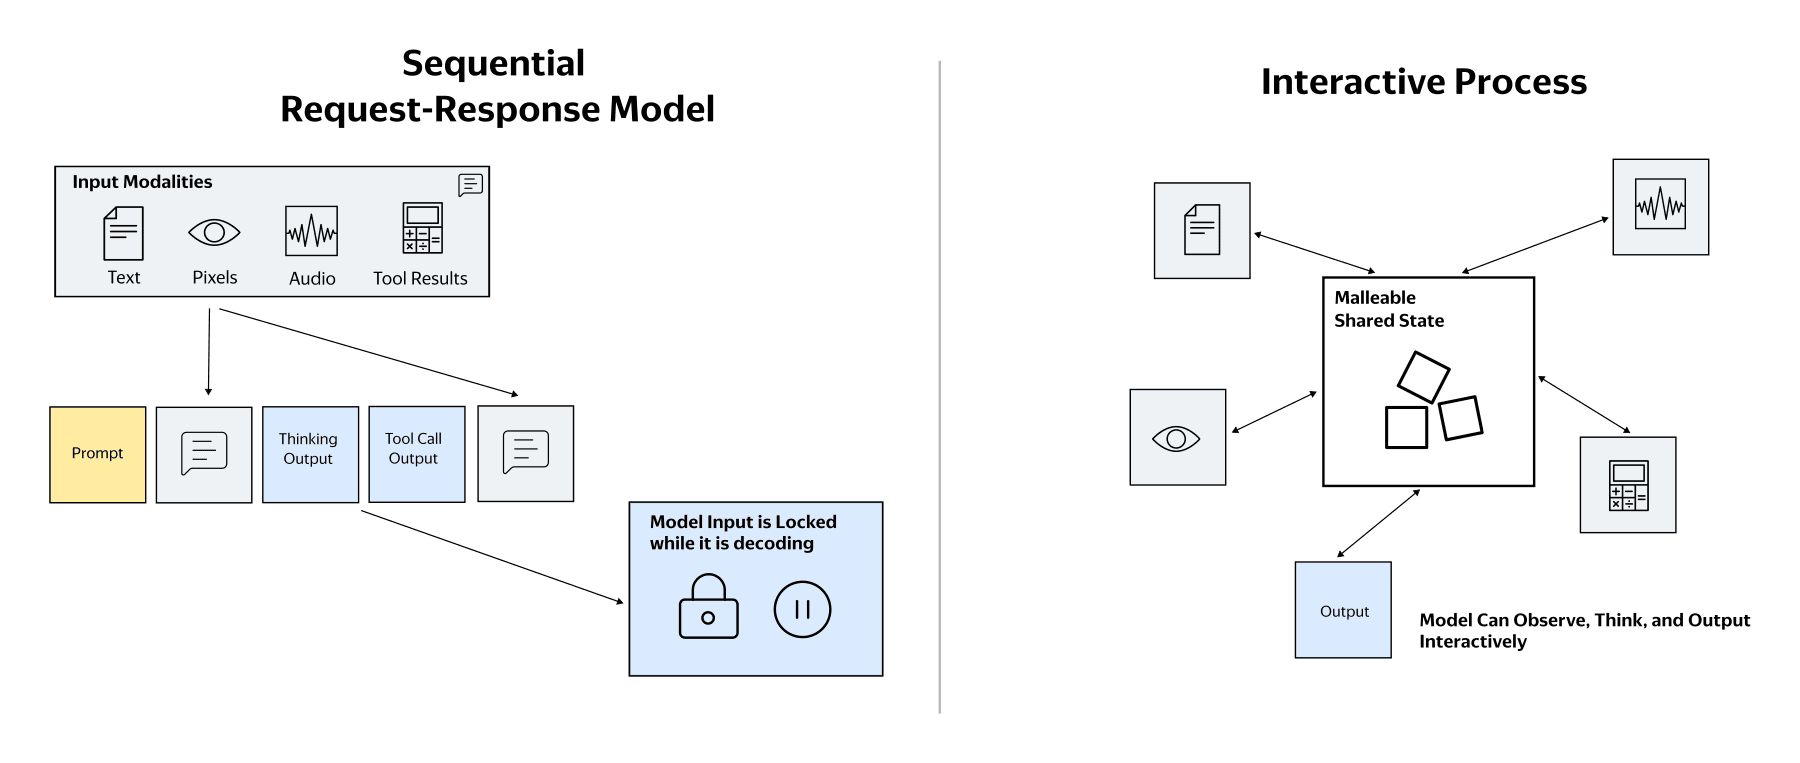 串行推理与共享状态运行时的差异
图:串行模型在解码时停止接收新状态;共享状态运行时让观察、推理和输出同时推进。来源:Yandex Research。
#KV Cache 不只是省算力的缓存
通常,KV Cache 被解释成一种解码优化:已经计算过的 Token 不必重复计算。但它实际上决定了新查询能够看见哪些历史状态、这些状态以什么因果顺序出现,以及哪些中间结果能影响下一步。
Yandex 将一次推理拆成多个持续变化的 Cache Block。一个 Block 可以属于用户输入、私有推理、公开回答、另一个模型 Worker、工具结果或视觉观察。不同消费者看到的是同一批物理 Block 的不同逻辑视图。
对使用 RoPE 的模型,这些视图不必复制整份 Cache。Block 可以按局部坐标存一次,查询时再施加与逻辑位置对应的旋转。于是,一块物理内存能够在不同流里出现在不同位置,KV Cache 从扁平的追加数组变成了可复用的多视图共享内存 。
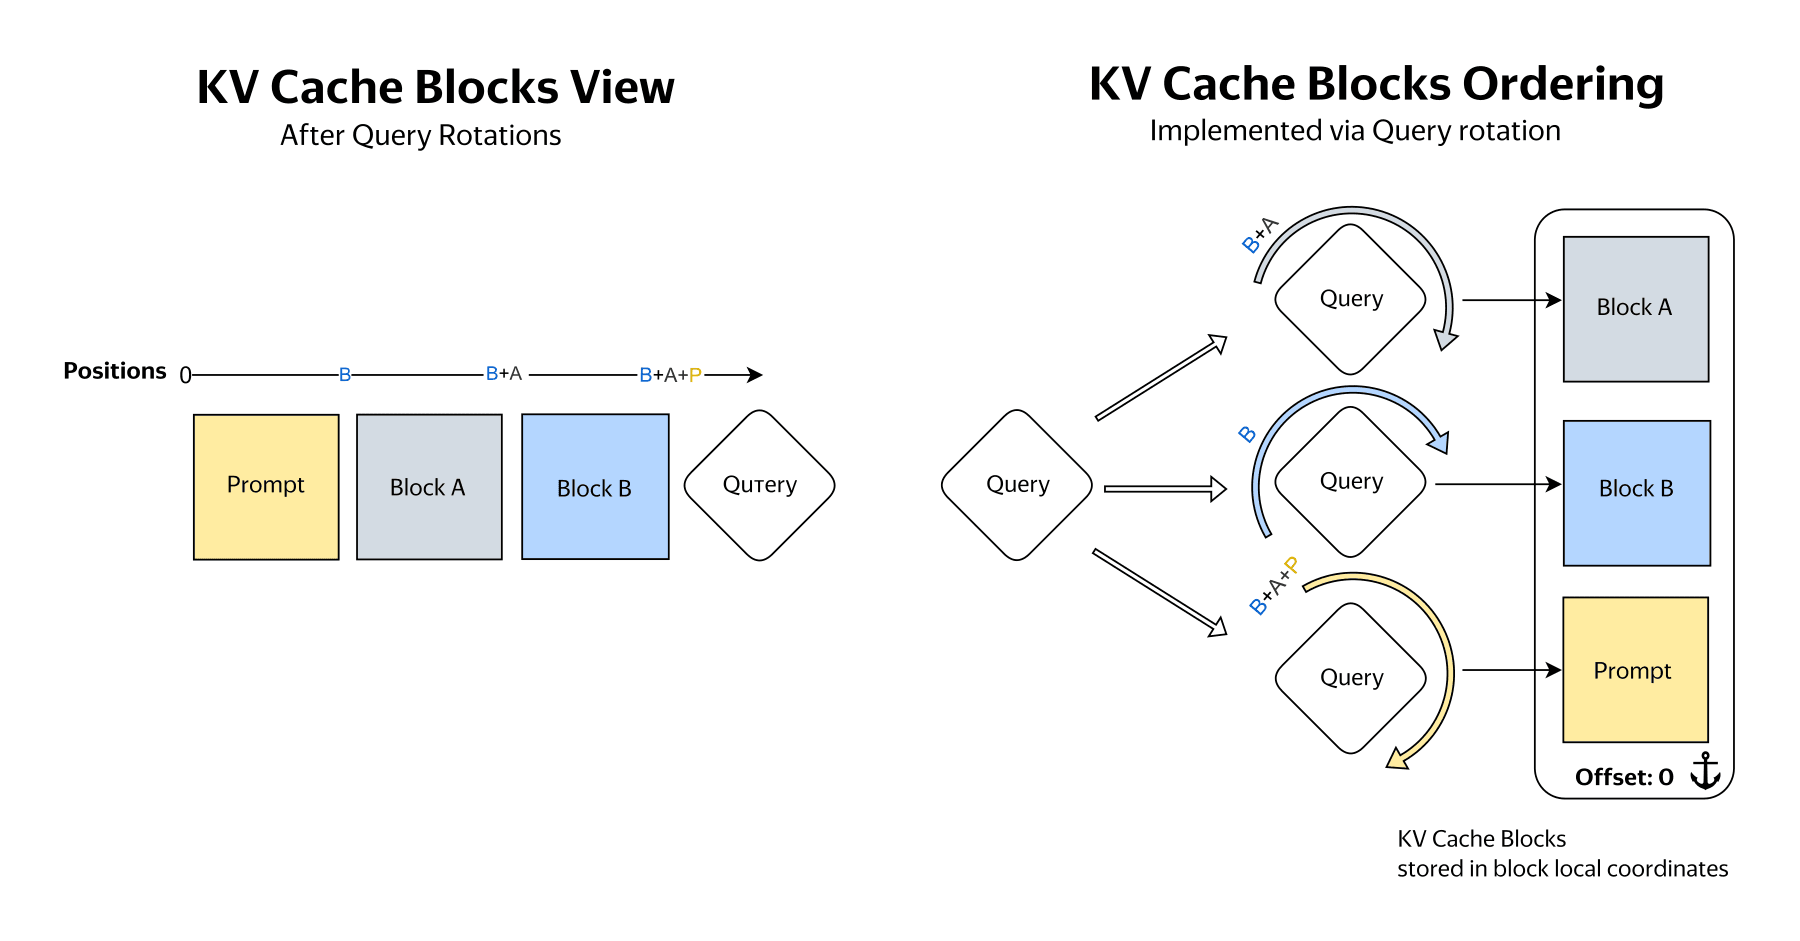 同一 Cache Block 被多个推理流以不同逻辑顺序读取
图:Block 只保存一次,不同推理流通过位置变换获得各自的因果视图。来源:Yandex Research。
#多 Agent 可以共享“思考现场”
传统多 Agent 系统通常在模型外部规定协作方式:先分工、再投票,或按固定轮次辩论。这些结构容易重复劳动,也可能被错误的初始分解锁死。
Hogwild! Inference 让多个同款模型并行生成,并立即读取其他 Worker 尚未完成的中间结果。模型可以在生成过程中自行决定继续别人的思路、转向验证、探索替代路线或停止重复工作。协作策略不再完全写死在编排层,而是一部分由模型根据共享状态即时形成。
#思考、说话和观察不必互相阻塞
AsyncReasoning 则把输入、私有推理和公开输出拆成独立流。Writer 可以利用 Thinker 的阶段性结果先做有用回应;Thinker 同时看到已经说出口的内容,并在证据不足时暂停输出。论文实验中,这种运行时改造把首个非思考 Token 的等待最多缩短 80 倍,把用户感知的总延迟最多缩短 12 倍,同时保留大部分深度推理收益。
同样的结构可以延伸到多模态 Agent:视觉、语音、推理、动作、工具调用和工具结果都成为异步 I/O 流。新画面可以在思考时进入上下文,工具返回后可以立刻可见,用户打断也不必让整轮计算作废。
#运行时开始像一套小型操作系统
要把概念做成服务,推理引擎需要支持命名流、Block 局部位置、按消费者控制可见性、异步追加、中断、模式切换、连续批处理和长期状态回收。作者将其类比为操作系统:流是进程,Cache Block 是共享内存,可见性映射像访问控制,工具结果则像中断。
限制也很明确。没有为并发训练过的模型可能误读不完整状态、重复工作或在错误时机继续执行;Cache 操作还会加重显存管理、批处理和分布式推理的复杂度。但这条路线揭示了 Agent 能力的第三个来源:除了模型权重和外部 Harness,推理运行时本身也可以定义模型如何观察、协作与行动。