Coding Agent 进步得很快,过去需要大量手把手指导和脚手架才能完成的任务,如今可能已经不再需要。如果一个项目持续使用 Agent 一年,它大概率积累了越来越长的 Skill、AGENTS.md 和任务 Prompt:每次模型犯错,就再补一条规则。
这些指令最初是修复问题的经验,但模型能力升级后,它们可能反过来限制结果。GPT-6 Astra 尤其值得触发一次指令审计:哪些规则仍在提供必要上下文,哪些只是在重复模型已经会做的事,哪些甚至会让它读错材料、做过度验证或过早停下。
#Skill 不是越多越好
Skill 本质上是保存在 Markdown 文件中的专用 Prompt,有时还会附带脚本。它最适合承载两类信息:只在特定任务中需要的工作流,以及使用某个插件或工具时必须遵守的说明。
问题在于,很多项目默认下载大量 Skill。每个 Skill 的名称和描述都要先进入模型上下文,模型才能判断什么时候加载它。当 Skill 太多、描述太长时,Codex 可能为了适应上下文而缩短描述,模型看到的触发条件变得更模糊,反而更难选对 Skill。
不同 Skill 的描述还可能互相矛盾,或者带有过强的“选我”倾向,诱导模型在不相关的任务中加载额外规则。结果不是能力增加,而是上下文被噪声占用。
第一条改进原则,是让 Skill 描述尽可能短,同时准确说明适用时机。比如数据库迁移 Skill 如果写成“处理数据库、查询、模型或持久化时使用”,几乎所有后端任务都会触发;更好的描述是只在新增、修改迁移或审查迁移发布时使用。
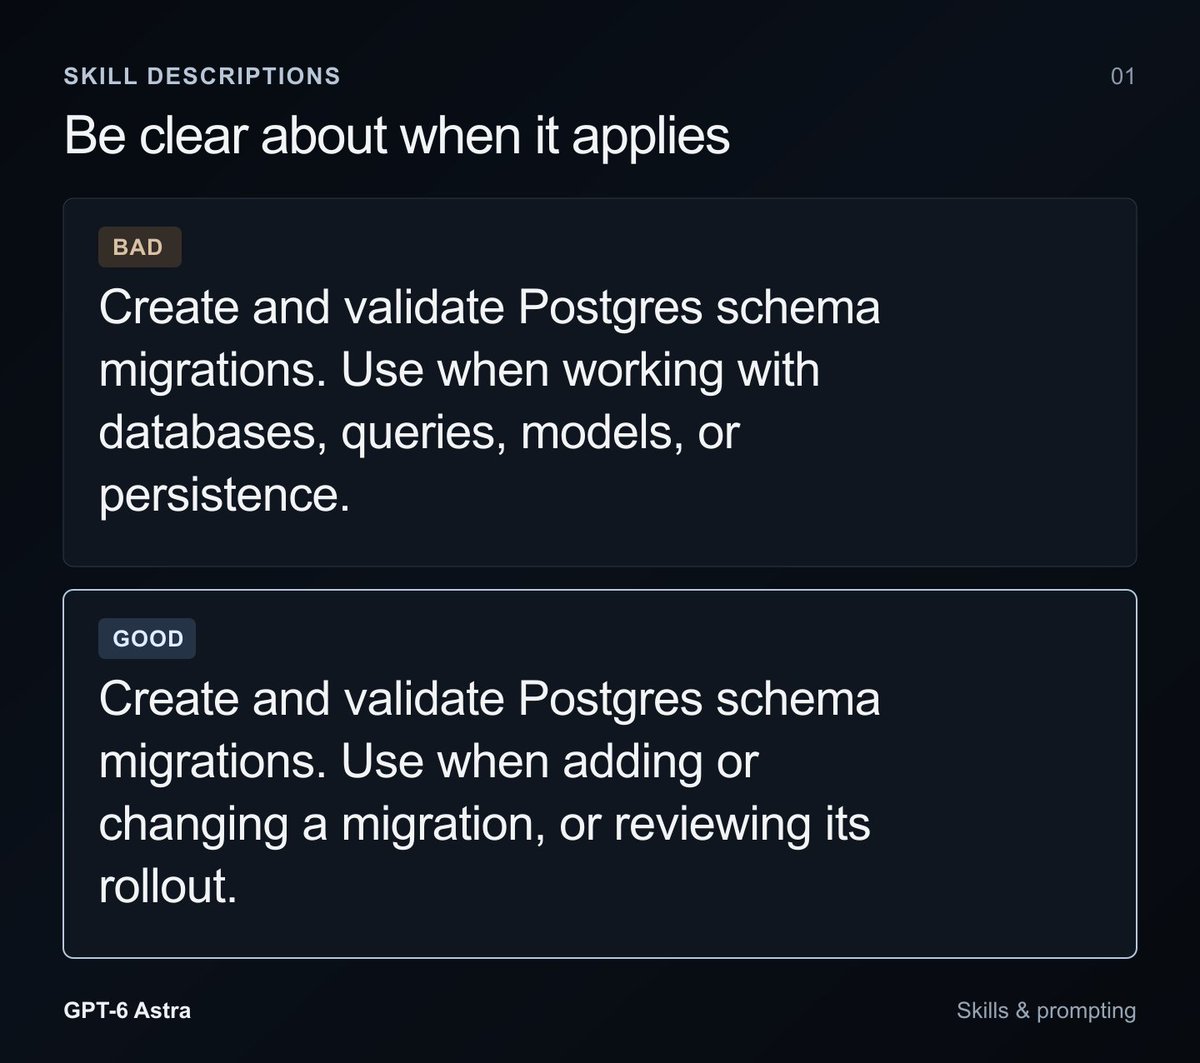 Skill 描述应把触发范围限定到真正需要它的数据库迁移任务
Skill 描述不是功能宣传,而是路由条件。范围越泛,误触发越多;范围准确,模型才能在真正需要时获得正确指令。
#用渐进披露保护上下文
一个有用 Skill 的关键特征是 Progressive Disclosure,也就是渐进披露。读取 Skill 会消耗上下文,让任务更接近压缩,还可能引入当前步骤根本用不到的规则。
如果一个 Skill 包含多条工作流,根文档应该是最小路由器:说明何时选择哪份支持文档或脚本,让模型知道下一步去哪里找,而不是在任务开始时强迫它读完所有分支。
过去,Skill 经常被写成非常详细的行程表或固定配方。较早的模型需要这种逐步约束,GPT-6 Astra 对语义、歧义和任务背景的理解更强,过度具体的步骤可能限制它根据现场情况判断。
还要考虑仓库并不只服务一个模型。帮助 Sol 或 Luna 的规则,可能过度约束 Astra;对 Astra 足够清晰的简短说明,又可能不给其他模型足够支撑。Skill 设计需要明确实际使用者,而不是假设所有模型对同一套脚手架反应相同。
#AGENTS.md 应提供路由,而不是课前阅读
与按需加载的 Skill 不同,AGENTS.md 会在模型每次进入仓库工作时生效。因此,其中每条指令都应该接受更严格的问题:是否所有任务都需要它?
如果要求模型在每次编辑前阅读架构、数据库和部署文档,那么修复一个拼写错误也要加载整套项目地图。对 GPT-6 Astra 来说,这通常既浪费上下文,也拖慢工作。它已经能够根据任务判断需要了解哪些文件。
更好的做法是提供上下文路由:修改服务边界时查架构文档,变更 Schema 时查数据库文档,准备发布时再查部署说明。相关资料仍然可发现,但不会无条件塞进每个任务。
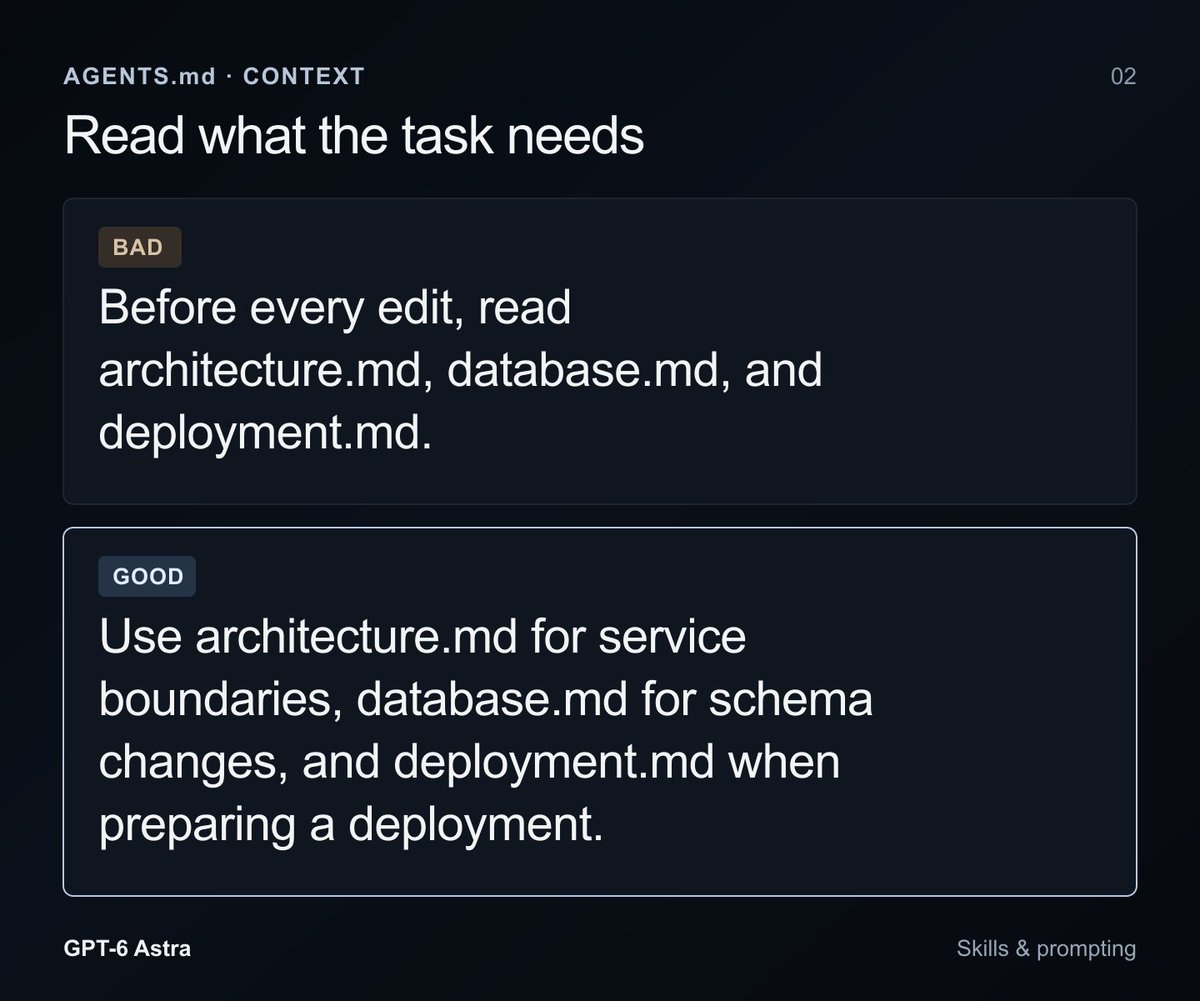 AGENTS.md 应按服务边界、数据库变更和部署任务分别指向所需文档
被引用的文档也必须保持更新。错误或过期的项目说明,比没有说明更危险,因为模型会把它当成高优先级上下文。
#昨天的质量护栏可能变成今天的重复劳动
旧模型需要明确提醒“运行测试并检查结果”,GPT-6 Astra 往往会主动验证工作。如果 AGENTS.md 仍无条件要求完整测试矩阵,同一目标可能被重复执行,简单修改也会产生不必要的等待和上下文消耗。
这并不意味着删掉所有测试要求,而是把要求改成与风险和变更范围相关。让模型运行受影响的测试、修复由本次修改造成的失败,并重新验证;不要把每个任务都升级成整仓测试。
GPT-6 Astra 的另一个特点是做事细致,但对任务应该推进到什么程度可能更谨慎。它完成第一版实现后,可能在仍有可做验证时就回来请求审阅。这里真正有用的不是更多步骤,而是更清楚的授权范围。
例如,仓库可以明确说明本地测试只使用一次性 Fixture,不访问生产环境,模型可以直接运行、修复相关失败并重试,无需每一步请求批准。这种说明提供的是安全边界与行动权限,而不是机械流程。
#重新审视“先问我”的边界
如果旧模型曾未经允许代替用户执行操作,项目里可能加入大量强制停下询问的规则。这些规则在当时有价值,但 GPT-6 Astra 的判断力更强,同时也更认真地遵守边界。旧有的强约束可能让它在其实可以安全继续的地方停止。
审计这类指令时,要区分真正需要人工决策的动作,与范围明确、可逆、无生产风险的正常步骤。边界仍然必须清楚,但清楚不等于把所有动作都变成审批点。
#持续工作需要完成定义
熟悉 GPT-5.6 Sol 长时间连续工作的用户,可能会觉得 Astra 更容易在第一轮实现后停下来。解决方法不是只写一句“坚持完成”,而是在任务开始时定义完成条件。
如果目标包括让实现真正运行、检查结果并修复失败,就应把这三件事写进任务。反过来,如果要求第一版完成后必须停下来评审,模型自然会更早交回控制权。
希望它继续探索时,也要说明探索什么以及在哪里停止。Persistence 不是无限工作,而是在明确范围内持续推进,直到可验证的终点。
#新模型上线,也是清理指令债务的时机
Skill、AGENTS.md 和 Prompt 都不是一次写完永久有效的资产。它们依赖模型能力、工具环境和团队工作流,理应像代码与依赖一样定期审计。
GPT-6 Astra 带来的变化,不只是可以完成更难的任务,也意味着许多旧脚手架已经失去必要性。应该删除宽泛的 Skill 触发条件,把根 Skill 缩成路由器,让 AGENTS.md 按场景指向文档,移除模型已经默认执行的重复要求,并把权限、风险和完成定义写得更清楚。
好的 Agent 指令不是最长、最严密的那套,而是能在正确时机提供恰好足够的信息,同时给更强模型留下判断空间。